닛판, 앤트로픽에 책을 팔았나? 일본 출판계 논란으로 본 AI 학습과 저작권
안녕하세요. 에이아이비(AIB)입니다.
2026년 9월 18일, 일본 최대급 출판 도매(유통) 기업인 닛판 그룹 홀딩스(日販, Nippan)가 Claude를 만드는 미국 AI 기업 앤트로픽에 대량의 책을 판매했을 가능성이 보도됐습니다.
발단은 미국에서 앤트로픽을 상대로 제기된 저작권 소송입니다.
이 재판에서는 앤트로픽이 AI 학습에 쓰기 위해 어디서, 어떻게 대량의 책을 모았는지가 쟁점 중 하나였습니다. 그 과정에서 공개된 재판 자료를 살펴보니, 책의 조달처로 “Nippan Japan”이라는 기재가 발견된 것이죠.
이에 일본 출판사 약 380곳이 가입한 업계 단체인 일본서적출판협회(서협)는 닛판에 사실 확인을 요구하는 서면을 보냈습니다. 앤트로픽에 넘어간 책 중에 회원 출판사의 책이 포함돼 있었는지, 닛판이 그 용도를 어디까지 알고 있었는지 등에 대해 설명을 요구하고 있습니다.
한 기업의 거래 문제처럼 보이지만, 이 일은 사실 전 세계가 아직 답을 내지 못한 큰 질문을 비추고 있습니다. 바로 “AI는 책을 어떻게 학습하고, 저작권은 이를 어떻게 다뤄야 하는가”입니다.
AI 기업은 왜 ‘책’을 원할까
생성형 AI 학습에는 그동안 인터넷의 글을 대규모로 수집한 데이터가 널리 쓰였습니다.
그런데 최근 인터넷에는 AI가 스스로 만들어낸 저품질 콘텐츠, 이른바 ‘AI 슬롭(AI slop)’도 빠르게 늘고 있습니다. 사람이 쓴 글과 AI가 만든 글이 뒤섞이면서, 품질 좋은, 사람이 만든 학습 데이터를 어떻게 확보할지가 AI 개발의 새로운 과제로 떠올랐습니다.
그래서 다시 주목받는 것이 바로 ‘종이책’입니다.
앤트로픽 내부 자료에서도 생성형 AI가 널리 퍼지기 전, 특히 2022년 이전에 만들어진 양질의 글을 확보하는 것을 중요하게 여겼습니다. 2022년 말 ChatGPT가 등장한 뒤로 인터넷에 AI가 만든 글이 급격히 늘었기 때문입니다.
즉 지금의 웹에서는 “AI가 만든 글을 또 다른 AI가 다시 학습하는” 일이 예전보다 훨씬 일어나기 쉬워졌습니다.
반면 그 이전에 출판된 책이라면 사람이 쓰고 편집자의 손을 거쳐 나온 글일 가능성이 높습니다. AI 생성물의 영향을 덜 받은, 품질 좋은 데이터 원천으로서 가치가 다시 평가받고 있는 것이죠.
아이러니하게도 책이라는 아날로그 매체가 ‘AI 시대의 보물’로 재평가받고 있는 셈입니다.
‘해적판’에서 ‘대량 구매’로
미국 재판 자료에서 드러난 숫자는 상상을 넘는 규모였습니다.
작가 안드레아 바츠(Andrea Bartz) 등이 제기한 집단소송에서는 앤트로픽이 LibGen 같은 해적판 사이트에서 700만 권이 넘는 책을 내려받아 디지털 라이브러리로 보관하고 있었다는 사실이 드러났습니다. 책 한 권을 8만 단어로 잡으면 100만 권에 약 800억 단어, 700만 권이면 약 5,600억 단어입니다.
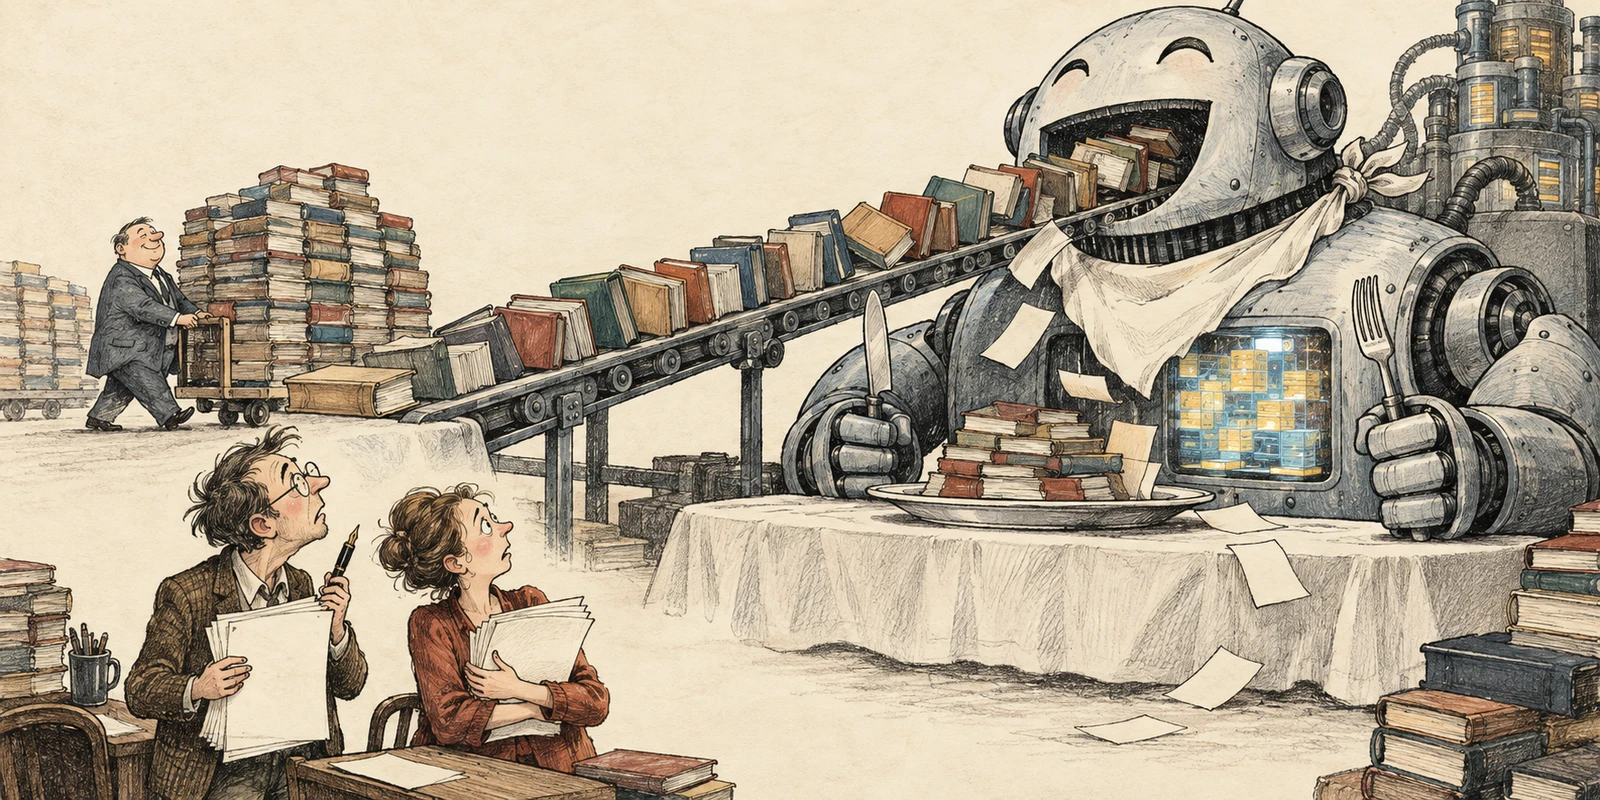
앤트로픽은 여기에 더해 과거 Google Books 파트너십 부문을 이끌던 톰 터비(Tom Turvey)를 영입했습니다. 그리고 종이책을 정식으로 대량 구매해 제본 부분을 잘라내고 페이지를 스캔해 디지털화한 뒤, 원본은 폐기·재활용하는 대규모 체계를 만들었습니다.
책등과 제본 부분을 잘라내고, 페이지를 한 장씩 스캔해 나가는 방식이죠.
말 그대로 종이책을 AI가 쓸 수 있는 전자 데이터로 바꾸는 전용 공장입니다.
이번에 보도된 닛판과의 거래도 이런 AI 학습용 도서 조달의 일환이었을 가능성이 제기되고 있습니다.
15억 달러, 역대 최대 규모의 저작권 합의
해적판 사이트에서 책을 확보한 문제와 관련해 앤트로픽은 2025년 저작권자 측과 합의했습니다.
이후 2026년 7월 20일 미국 연방지방법원이 합의를 최종 승인했습니다. 합의 기금은 총 15억 달러로, 대상이 된 약 48만 개 작품에 작품당 약 3,000달러가 지급되는 구조입니다. 다만 여기서 중요한 점은 이 15억 달러가 ‘AI에 학습시킨 것’에 대한 대가가 아니라는 것입니다.
합의 대상은 해적판 사이트에서 부정하게 입수한 책입니다. 반면 정식으로 구매한 종이책은 책값 자체는 지불됐더라도, AI 학습에 쓰는 것에 대한 추가 대가가 저자나 출판사에 지급된 것은 아닙니다.
정리하면,
해적판에는 재판의 결과로 거액의 합의금이 발생했다.
반면 정식으로 구매한 책에는, 책값 외에 ‘AI 학습이라는 새로운 용도’에 대한 추가 대가가 없다.
이번 닛판 문제에서 묻고 있는 것도 바로 이 지점입니다.
책으로 팔리는 가격과 AI 학습 데이터로 쓰이는 가치는 정말 같을까요?
그리고 그 새로운 가치를 누가 가져가고, 저자와 출판사에게는 어떻게 돌려줘야 하는지라는 문제가 남습니다.
일본에서는 일정 조건에서 허락 없이 AI 학습이 가능하다
흥미로운 점은 일본 저작권법이 이 문제에 대해 독자적인 장치를 갖고 있다는 것입니다.
2018년 저작권법 개정으로 마련돼 2019년 1월 시행된 저작권법 제30조의4는, 저작물에 표현된 사상이나 감정을 ‘향유’하는 것이 목적이 아닌 경우 필요하다고 인정되는 범위에서 권리자의 허락 없이 저작물을 이용할 수 있다고 정하고 있습니다.
일본 문화청도 AI 개발을 위해 저작물을 학습용 데이터로 수집·이용하는 행위는 원칙적으로 이 규정의 대상이 될 수 있다고 설명합니다.
혁신을 촉진하기 위한 유연한 제도이지만, AI가 빠르게 발전하면서 “학습에 쓰인 저작물의 가치를 권리자에게 어떻게 돌려줄 것인가”라는 새로운 문제도 떠올랐습니다.
이번 닛판 건이 그 상징적인 사례입니다.
일반 도서로 판매된 이상 책값은 발생합니다. 하지만 그 책이 AI 학습이라는 다른 용도로 쓰였더라도, AI 학습 이용 자체에 대해 저자나 출판사에 추가 대가가 자동으로 돌아가는 구조는 아닙니다.
합법이라면, 왜 파문이 커질까?
그렇다면 AI 학습에 쓰였다는 이유만으로 곧바로 불법이라고 단정하기 어려운 이번 거래가, 왜 이렇게 큰 반발을 불러왔을까요?
초점은 ‘합법이냐 불법이냐’만이 아닙니다.
누가, 무엇을 알고 있었고, 누구에게 어떤 설명을 했는가.
즉 법의 바깥에 있는 투명성과 설명 책임의 문제입니다.
서협이 닛판에 요구하는 것도 단순히 위법성을 따지는 것만이 아닙니다.
앤트로픽에 넘어간 책 중에 회원 출판사의 책이 있었는지, 출판사의 동의 없이 대량 판매됐는지, 닛판이 판매처와 용도를 어디까지 알고 있었는지 등 거래 경위에 대한 설명을 요구하고 있습니다.
반면 닛판은 개별 거래에 대해서는 답변을 삼가면서, AI 학습에 쓰인다는 것을 알고 판매한 사실은 없다고 설명하고 있습니다.
이 사건의 핵심에는 “저자와 출판사가 모르는 사이에, 자신들의 책이 ‘학습 데이터’라는 다른 경제적 가치를 지닌 상품으로 바뀌어 있었던 것은 아닌가” 하는, 출판 유통의 투명성 자체에 대한 불신이 있습니다.
‘합법’과 ‘납득’은 다른 문제
AI 개발 경쟁이 치열해질수록 영어뿐 아니라 양질의 일본어 데이터의 가치도 상대적으로 높아질 것으로 보입니다.
게다가 주요 공개 웹 데이터가 AI 학습에 반복적으로 쓰이고 인터넷에 AI 생성 콘텐츠도 늘어나는 가운데, 그동안 충분히 활용되지 않았던 양질의 사람 유래 데이터는 점점 더 귀해질 수 있습니다. 그 대표적인 존재 중 하나가 바로 ‘책’입니다.
그렇다면,
- AI가 필요로 하는 막대한 데이터 양을, 사람이 새로 만들어내는 양질의 글이 따라잡을 수 있을까요?
- 새로 학습할 수 있는 좋은 사람 유래 데이터가 줄어들면, AI의 발전은 어떻게 달라질까요?
- 그리고 내 저작물이 AI 학습 데이터로서 큰 가치를 갖게 되었을 때, 저작권자는 그 이용에 대해 어떻게 권리를 주장하고, 어떤 대가를 요구해야 할까요?
이번 닛판과 앤트로픽을 둘러싼 문제는 단순히 “책을 팔아도 됐는가”의 이야기가 아닙니다.
사람이 만든 지식과 표현을, AI 시대에 누가, 어떤 규칙으로 이용하고, 그 가치를 누구에게 돌려줄 것인가.
일본 출판업계에는 거래 규칙과 정보 공개의 방식을 다시 생각해 보는 하나의 시금석이 될 것으로 보입니다.