歴史で学ぶAIの基礎「機械は自ら学べるのか?」
まずは、ある新聞記事の一文を読んでみましょう。
「歩き、話し、見て、書き、自らを複製し、自分の存在を意識するようになるだろう」
“Walk, talk, see, write, reproduce itself and be conscious of its existence”
この一文は、1958年7月8日付の『ニューヨーク・タイムズ』に掲載された記事に登場します。最新のAIモデルの発表だと言われても違和感のない内容ですよね。
記事の見出しは「海軍の新装置、やってみて学ぶ(New Navy Device Learns by Doing)」でした。
『ニューヨーカー』はさらに踏み込み、この機械をこう評しました。
「これまでに考案されたもののなかで、人間の脳にとって初めての本格的なライバル」
“The first serious rival to the human brain ever devised”
この記事の主役は、当時30歳の誕生日を数日後に控えた心理学者、フランク・ローゼンブラット(Frank Rosenblatt)。そして彼がつくったパーセプトロン(Perceptron)です。
それから68年が経った今も、AIをめぐる人々の不安や関心は、あまり変わっていないように見えます。
新しいAIが登場するたびに「自ら考える機械が現れた」「人間の仕事が危ない」といった記事があふれるのですから。
脳の仕組みをまねた機械、パーセプトロン
1958年、ローゼンブラットは「パーセプトロン:脳における情報の保存と組織化のための確率モデル(The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain)」という論文を発表します。
興味深いことに、この論文が掲載されたのはコンピューターの学術誌ではなく、心理学の学術誌『Psychological Review』でした。ローゼンブラットはコンピューター科学者ではなく、人間の脳と心を研究する心理学者だったからです。
論文は、3つの根本的な問いから始まります。
-
生物は外の世界の情報をどのように感知するのか?
-
その情報はどのような形で記憶されるのか?
-
記憶された情報は、認識や行動にどのような影響を与えるのか?
ローゼンブラットは、脳の働きを、きっちり割り切れる論理規則だけで説明するよりも、確率論の視点から理解すべきだと考えました。そして脳の働きをヒントに、いつも同じ答えを返す単純な計算機ではなく、経験によって判断の基準が変わっていく「学習する機械」をつくろうとしたのです。
パーセプトロンの仕組み
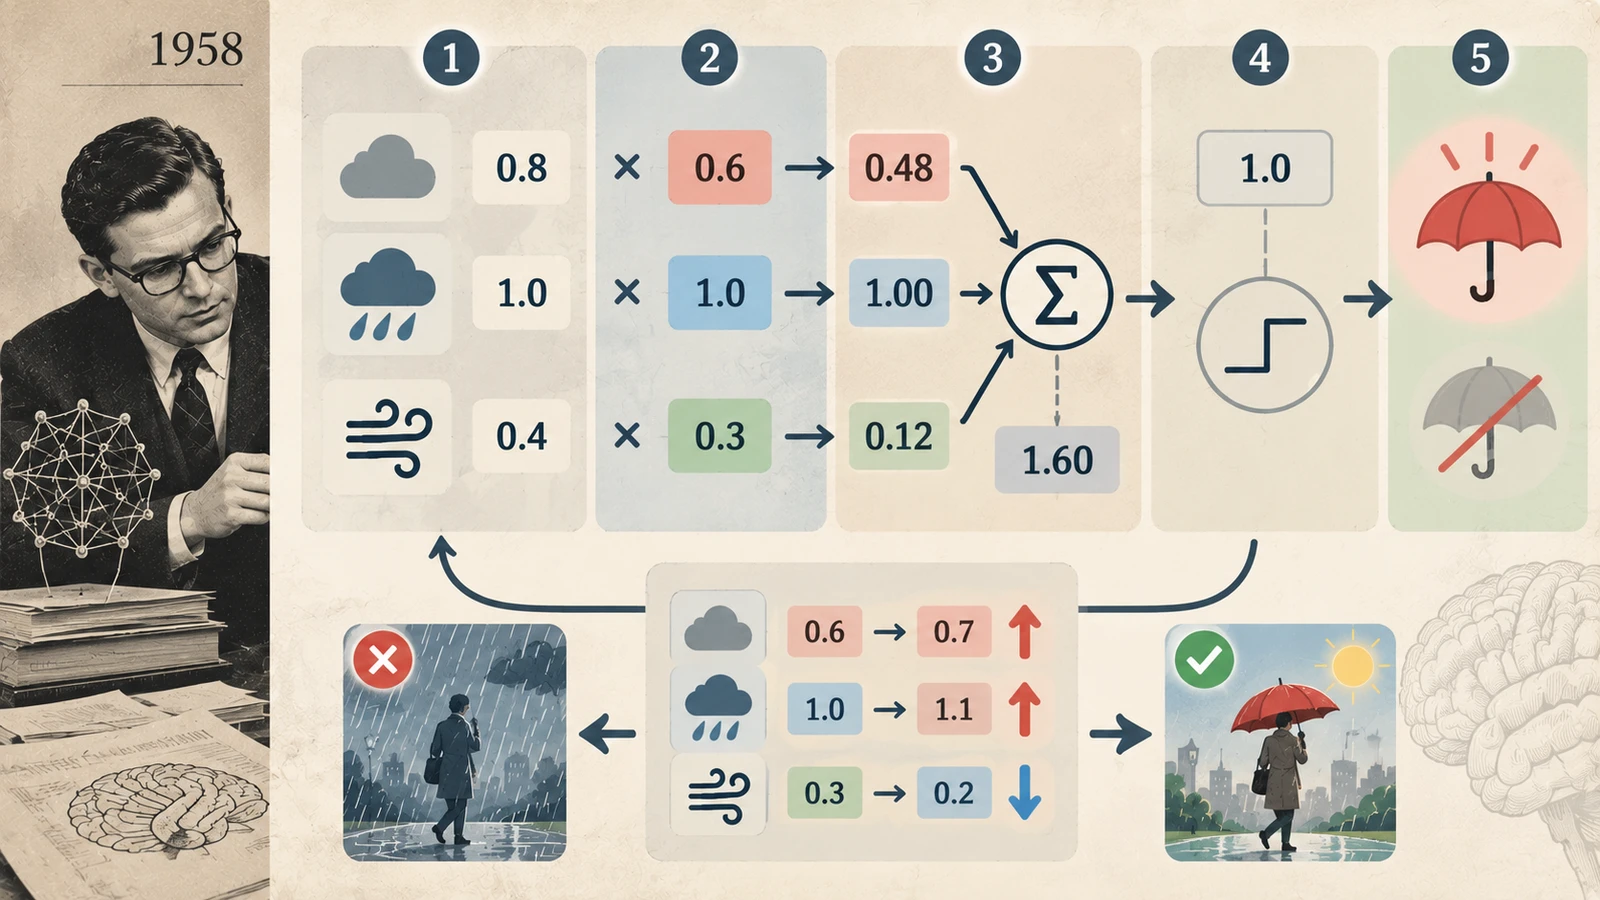
朝、傘を持っていくかどうか迷う場面を思い浮かべてみましょう。
-
「空は曇っているか?」「天気予報に雨マークはあるか?」「風は吹いているか?」といった手がかりを数字に置き換えます。
たとえば、曇り0.8、雨1.0、風0.4のように、それぞれの情報を数値で入力します。 -
それぞれの手がかりに重要度を掛けます。
雨のように重要な手がかりには大きな重み、それほど重要でない手がかりには小さな重みを与えます。
たとえば曇りには0.6、雨予報には1.0、風には0.3の重みを与えることができます。 -
計算した値をすべて足します。
0.8 × 0.6 + 1.0 × 1.0 + 0.4 × 0.3 = 1.60のように、ひとつのスコアにまとめます。 -
基準値と比べます。
合計が基準値1.0を超えているかを確認します。 -
結果を決めます。
基準を超えれば傘を持っていく、超えなければ傘を持っていかないと判断します。 -
正解をもとに重みを調整します。
もし計算結果が間違っていた(傘が必要だと判断したのに、実際には必要なかった)なら、それぞれの手がかりの重要度を少しずつ調整します。
このように結果を確かめ、重みを修正しながら次の判断を改善していくことが、パーセプトロンが「学習」する基本的な仕組みです。
人間がルールを直接書いていた時代に、「ルールを教えるのではなく、事例を見せて、機械にルールを見つけさせよう」という発想は革命的でした。
これは、今日私たちが機械学習(machine learning)と呼んでいる技術の、重要な出発点のひとつです。
自ら「学習」する巨大な機械
1958年、アメリカ海軍の記者会見では、パーセプトロンの仕組みを実装したプログラムが、部屋ひとつを埋め尽くす重さ5トンのIBM 704コンピューターで実演されました。
コンピューターは約50回の試行を経て、左側に印のあるカードと右側に印のあるカードを見分けはじめました。今から見ればあまりに単純な問題ですが、人間がコンピューターに「左と右を見分けるルールそのもの」を一つひとつプログラムしたわけではないという点で画期的でした。
ローゼンブラットはそこで止まりませんでした。
パーセプトロンのアイデアを実際のハードウェアで実現するため、光センサーや電子回路などを使った専用の機械、Mark I Perceptronをつくったのです。
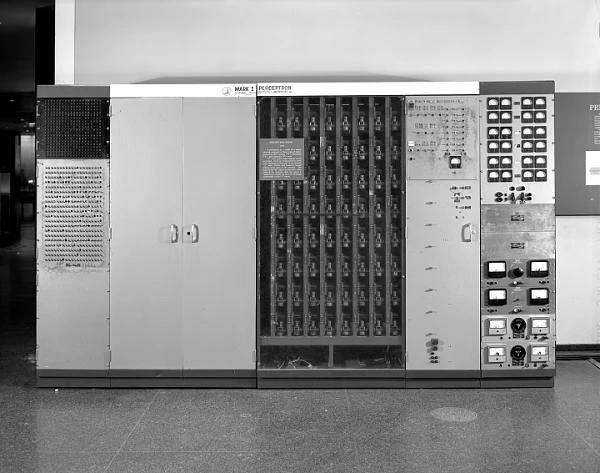 Mark I パーセプトロン
パーセプトロンの終焉と「AIの冬」
パーセプトロンへの期待が高まるほど、冷ややかな目を向ける人もいました。
そのひとりが、MITのマービン・ミンスキー(Marvin Minsky)。のちに「AIの父」のひとりと呼ばれる人物です。
ローゼンブラットとミンスキーは、ニューヨークのブロンクス科学高校に1学年違いで通っていた同窓生でした。ふたりは学会の場で、パーセプトロンの可能性をめぐってたびたび公開で激しい議論を交わしていました。
そして1969年、ミンスキーは同僚のシーモア・パパート(Seymour Papert)とともに『パーセプトロン(Perceptrons)』という本を出版します。
ローゼンブラットがつくった機械の名前をタイトルにしていましたが、この本は当時のパーセプトロンが抱える数学的な限界を集中的に分析した本でした。
単純なパーセプトロンは、データを1本の直線や平面で分けられる問題には強いものでした。しかし、世の中のすべての問題がそんなにきれいに分けられるわけではありません。どれだけ長く学習させても、構造そのものの限界のために解けない問題があったのです。
この本は当時のニューラルネットワーク研究に大きな衝撃を与え、その後パーセプトロンとニューラルネットワークの研究が下火になっていく過程を象徴する出来事のひとつになりました。
さらに、期待に届かなかった機械翻訳の研究、政府による研究成果の評価、膨大なコンピューティングコストや研究費の削減など、さまざまな要因が重なり、1970年代にはAI研究全体の熱気が急速に冷めていきました。
パーセプトロンが残した遺産
しかし、ローゼンブラットのアイデアそのものが消えたわけではありませんでした。
1980年代に入ると、研究者たちは多層のニューラルネットワークを効果的に学習させる方法を発展させはじめます。とくに1986年、デビッド・ラメルハート(David Rumelhart)、ジェフリー・ヒントン(Geoffrey Hinton)、ロナルド・ウィリアムズ(Ronald Williams)が発表した論文をきっかけに、誤差逆伝播法(backpropagation)がニューラルネットワーク研究で広く知られるようになります。
誤差逆伝播法は、結果がどれだけ間違っていたかを計算し、その誤差をネットワークの後ろから前へと伝えながら、各つながりの重みを少しずつ修正する方法です。ローゼンブラットの「間違えたら重みを直す」というアイデアを、はるかに大きく複雑な多層のニューラルネットワークでも効果的に使えるようにしたのです。
その結果、単純なパーセプトロンひとつでは解きにくかった問題も、多層のニューラルネットワークと新しい学習方法によって解けるようになり、ニューラルネットワーク研究は再び勢いを取り戻していきました。そして2024年、ジョン・ホップフィールド(John Hopfield)とジェフリー・ヒントン(Geoffrey Hinton)は「人工ニューラルネットワークによる機械学習を可能にした基礎的な発見と発明(for foundational discoveries and inventions that enable machine learning with artificial neural networks)」が認められ、ノーベル物理学賞を受賞しました。
もちろん、私たちが今使っているChatGPT、Claude、Geminiが、1958年のパーセプトロンと同じ構造や学習アルゴリズムで動いているわけではありません。
それでも、無数のつながりにそれぞれ異なる重みやパラメータを持たせ、学習の過程で誤差が小さくなる方向へその値を少しずつ調整するという大きな考え方は、受け継がれています。
ローゼンブラットのMark I パーセプトロンでは、可変抵抗の値を電気モーターが物理的に調整していましたが、今日のAIではGPUが膨大な数の数値、つまりパラメータを計算し、調整しています。形も規模も性能もまったく変わりましたが、「経験を通じてつながりの重要度を変えながら学ぶ」という考え方は、今も生き続けているのです。
私たちが今使っているAIのアイデアは68年前にすでに登場していましたが、そのアイデアを十分な規模で実現できるコンピューターとデータ、そして学習方法が追いつくまでには、半世紀以上の時間が必要でした。
やってみよう・パーセプトロンはどうやって答えを学ぶのか?
TensorFlow Playgroundを使って、パーセプトロンの仕組みを自分の目で確かめてみましょう。
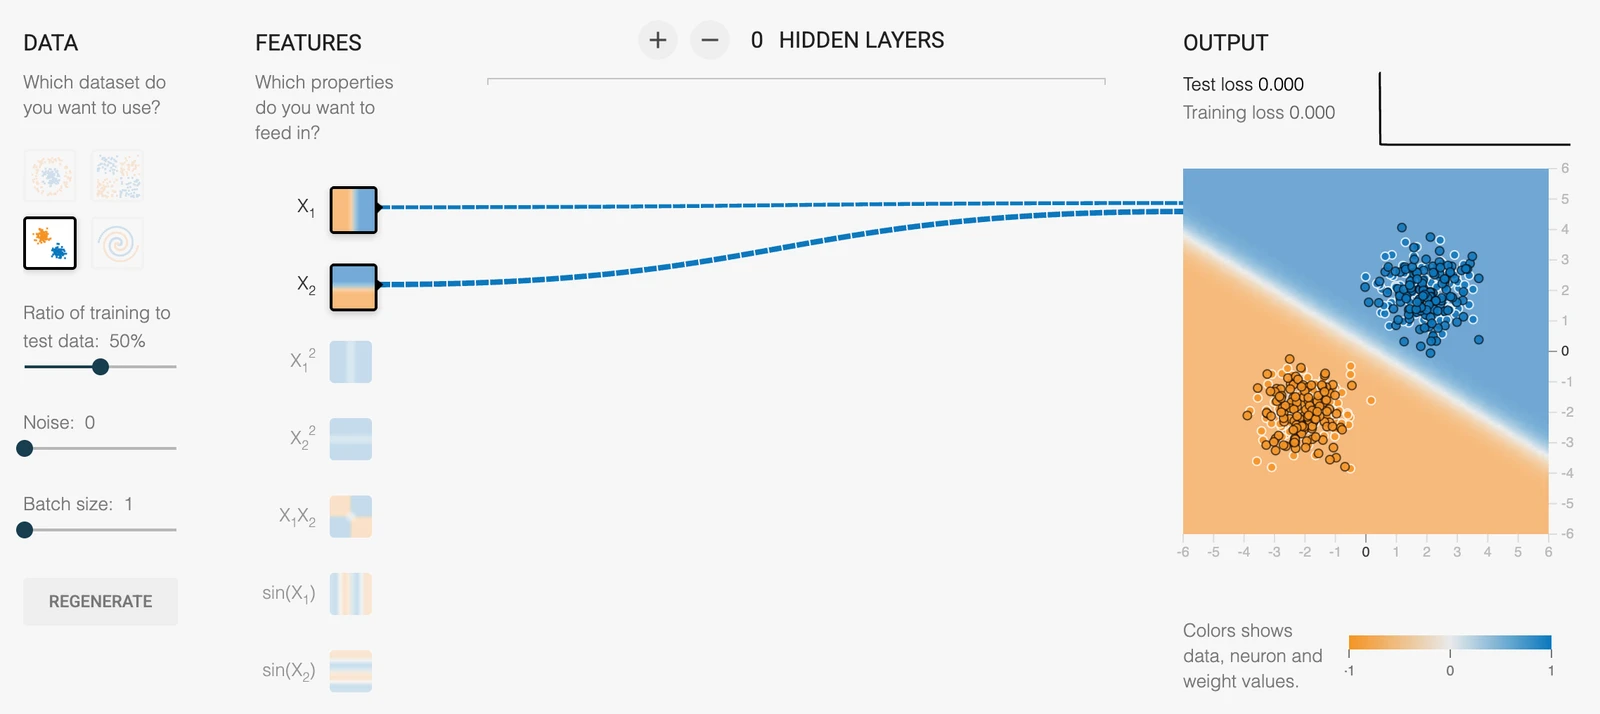 画面には数字や難しい用語がたくさん並んでいますが、すべてを理解する必要はありません。
見るのはたった3つ。青い点、オレンジの点、そして2つの色を分ける境界線です。
① いちばん単純な問題を選ぶ
左側のDATAで、青い点とオレンジの点が2つのかたまりに分かれている図を選びます。
青い点はある種類の正解、オレンジの点は別の種類の正解だと考えてください。
たとえば、
- 青 = 傘が必要だった日
- オレンジ = 傘が必要なかった日
と考えてもかまいません。
目標は、機械がこれらの事例を見て、2つの種類をいちばんうまく分けられる基準を自分で見つけ出すことです。
② 機械をできるだけ単純にする
FEATURESではX₁とX₂だけを残し、
HIDDEN LAYERSを0にします。
これで、複雑なニューラルネットワークではなく、2つの手がかりを見てひとつの答えを出す、とても単純な構造になります。
傘の例でいえば、
- X₁ = 空がどれくらい曇っているか
- X₂ = 雨が降る可能性がどれくらい高いか
という2つの手がかりだと考えればOKです。
③ まず画面の「境界」を探す
右側のOUTPUTを見てください。
青い背景とオレンジの背景のあいだに、うっすらとした境界があります。
この境界は、かんたんにいえば機械がつくった判断の基準線です。片側にあるものは青、反対側にあるものはオレンジと判断しているわけです。
学習前は、この基準がまったく見当違いの場所にあることもあります。
④ 1回ずつ学習させてみる
まず↻ボタンを押して最初の状態に戻したら、大きな▶ボタンは押さずに、その横の1ステップ進めるボタンを1回ずつ押してみてください。
(▶ボタンを押すと一瞬で学習が終わってしまい、途中の様子が見えにくくなります)
1回。もう1回。さらに何回か押してみます。ほかの数字は見なくてかまいません。
青とオレンジのあいだの境界がどう動くかだけを見てください。
最初は点をうまく分けられなかった境界が、少しずつ向きや位置を変えながら、だんだんと青い点は青い領域に、オレンジの点はオレンジの領域に入るように動いていきます。
この変化こそが「学習」です。
⑤ 何を学んだのでしょうか?
私たちはコンピューターに「ここに、この角度で線を引いて」と教えたわけではありません。
機械に見せたのは、「この点は青」「この点はオレンジ」という、いくつもの事例だけです。
機械は最初、間違った基準から出発しますが、正解と自分の結果を比べながら、少しずつ基準を変えていきます。そしてついには、「このあたりに、こんな向きで線を引けば、2つの種類をいちばんうまく分けられそうだ」という基準を見つけ出します。
これがパーセプトロンの核となるアイデアです。
人間がルールを直接教える代わりに、たくさんの事例と正解を見せて、機械がその中からルールを見つけていくこと。
TensorFlow Playgroundで境界線が少しずつ動いていく様子は、まさにその変化が画面に表れたものなのです。