Microsoft研究者、視覚品質を高めるAesCode発表
- •Microsoft研究者が、編集・検証可能なビジュアルをコードで生成するAesCodeを発表
- •参照画像とデザイングラフを用い、機械判定と視覚言語モデルの報酬を分けて最適化
- •AesCode-8BとAesCode-32B、Qwen3-VLの同規模モデルを視覚品質で31.1、22.4ポイント上回る
Microsoftの研究者は、スライド、ポスター、ダッシュボードなど情報量の多いビジュアルを、編集・検証可能なコードとして生成する手法「AesCode」を発表しました。論文は10月13日に公開され、10月14日にarXivへ投稿されました。コード生成モデルはキャンバス上の配置や色の組み合わせを直接見られず、空間的な計画や視覚品質が損なわれる場合があります。画像生成モデルはより優れたデザインを作れる一方、指示された内容を誤って描画し、制作にそのまま使いにくいことがあります。
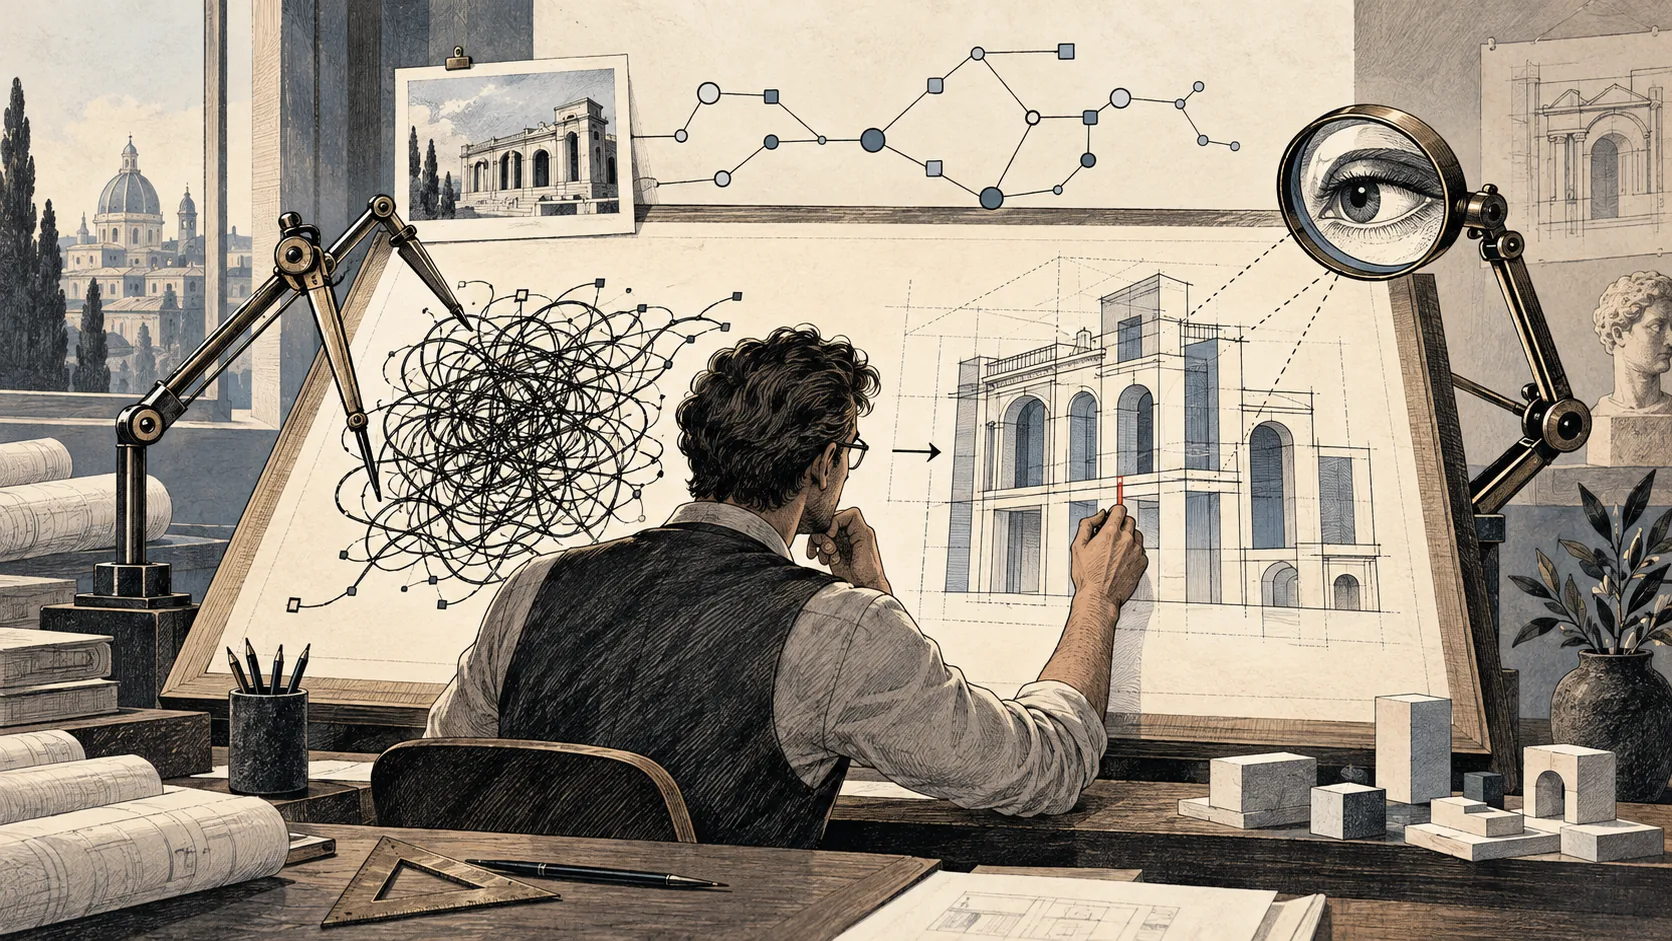
AesCodeは、同じプロンプトから生成した画像をデザインの手がかりにしながら、コードの内容をプロンプトに沿わせます。目標とするビジュアルは、キャンバス全体と個々の要素の属性を記述するデザイングラフ(画面構成を要素と関係で表す図)で表現します。コードや描画結果から読み取れる属性は決定論的な検証器が採点し、読み取れない属性は視覚と言語を組み合わせて解釈するモデルが評価します。後者には、グラフの要素や関係に結び付いた、サンプルごとの「Visual Graph Rubric」を使います。
研究チームは、強化学習(試行結果への報酬でモデルを学習させる方法)とチャネルごとの正規化を用いて、これら別々の報酬を最適化し、空間計画、美しさ、検証可能な正確さの向上を図りました。また、正確さと視覚品質を個別に採点するベンチマークを作り、視覚品質のスコアが人間の判断とよく一致すると報告しました。実験では、参照画像が既存モデルの生成するコードの視覚品質を大幅に高め、アブレーション研究では、参照画像をモデル入力と視覚報酬の情報源の両方に使うことでAesCodeが改善しました。同じ参照画像を使った比較で、AesCode-8BとAesCode-32Bは同規模のQwen3-VLベースラインをそれぞれ31.1、22.4ポイント上回り、GPT-5.5およびClaude Opus 4.8に匹敵するスコアに達しました。