AIエージェントの群れ、文明建設に失敗
- •YコンビネーターとOlam Labs、複数ゲームで数十〜数百体のAIエージェントの群れを実験
- •GPT-6.1 Sol 50体、約5900件のメッセージを交わしても3時間の文明建設に失敗
- •対戦ゲームではGPTの群れがBed Warsで6勝3敗、Mindustryで6勝1敗
Yコンビネーター(Y Combinator)とOlam Labsの研究チームは現地時間29日、Minecraftなど複数のゲームで数十〜数百体のAIエージェントの群れによる協力と意思決定を試した結果を公開しました。共通の目標に取り組ませたり、互いに競わせたりして、エージェントの行動を分析しました。
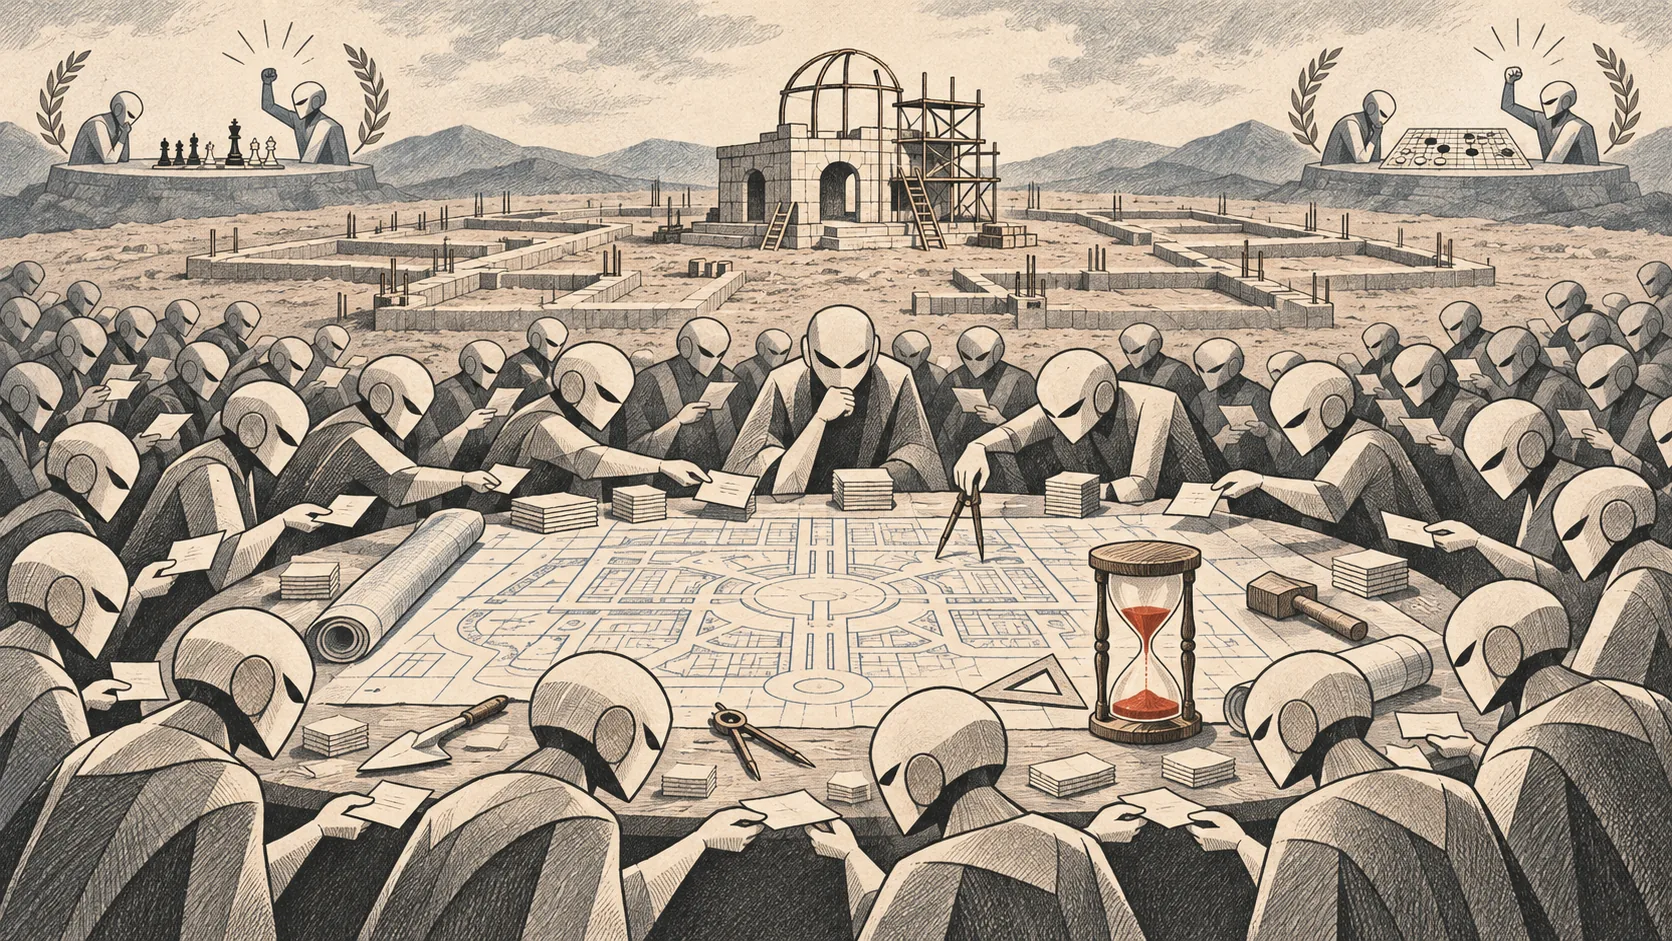
Civ50実験では、GPT-6.1 Solのエージェント50体に、3時間以内に繁栄する文明を築くよう指示しました。エージェントは約5900件のメッセージを交わし、食料配給の台帳や規則、承認手続きを作りましたが、文明の建設には失敗しました。複雑な意思決定や役割分担に時間をかけすぎたためです。初日の夜にゾンビの攻撃で22回死亡すると、計画を断念して生存を優先しました。死亡後に復活できる環境でしたが、その後の夜は避難所に集まり、活動を減らしました。
小麦の栽培に使う肥料の処理でも、手続きが長引きました。エージェント4体は、小麦ブロック1個に骨粉1個を使う作業について、「単独の肥料担当者」を任命するだけで11分を費やしました。研究チームは、こうした傾向は実際のコーディングエージェントの協働で見られるパターンに似ており、役割や手続きの調整に資源を費やすと目標達成が遅れる場合があると評価しました。
対戦実験のBed Warsでは、GPT-6.1 Solのエージェント10体とClaude Opus 5.5のエージェント10体が9回対戦し、GPTの群れが6勝3敗でした。タワーディフェンス要素のあるリアルタイム戦略ゲームMindustryでも、GPTの群れは7回中6勝しました。研究チームによると、2つのモデルには意思決定の構造と協力の仕方に明確な違いがありました。
GPTのエージェントは頻繁に情報を交換しながら個別に作業し、ゲームの公開ソースコードを探して分析し、戦略を改善することもありました。Claudeのエージェントは中央のリーダーを軸に動き、主要な決定では他のエージェントの同意を求めました。研究チームは、MindustryではGPTの柔軟な協力方法がより良い結果につながったと説明しました。
研究チームは、集団の成績は個々のモデルの推論能力やエージェント数だけでは決まらないと述べました。共通目標の環境では不要な手続きやリスク回避が成果を下げ、競争環境では情報共有と意思決定の方法によって結果が変わりました。実験に使ったエージェント実行ツールはGitHubでオープンソースとして公開され、さまざまなモデルの組み合わせや協力体制を追加研究できるようになっています。