DexAgent、人の動画からロボット訓練データを生成
- •スタンフォード大とコロンビア大の研究者が、実環境のロボット作業11種で平均成功率63.6%を報告
- •人の動画1本から4段階の処理で作業ごとに検証済みエピソード500件を生成
- •引き出しへの玩具収納で成功率80%、ロープ結びで50%;比較対象の最高値は平均18.2%
スタンフォード大学とコロンビア大学の研究者は、人の一人称視点動画1本と作業の説明からロボットの訓練データを作るエージェント型の枠組み「DexAgent」を発表しました。実環境での物体操作作業11種で、DexAgentのデータを使って訓練した方策の平均成功率は63.6%でした。比較対象のうち最も高かったSPIDERは18.2%、V2Dは17.3%で、SPIDERの約3.5倍に当たります。作業には電池の挿入、はさみでの切断、ロープ結び、コンピューターの設置が含まれ、硬い物体、関節のある物体、変形する物体、道具の使用、長い動作手順を扱いました。物体の配置をランダムに変え、各作業につき10回試験しました。玩具を引き出しに入れる作業では成功率80%、ロープ結びでは50%でした。手法の比較では、同じ方策モデルと共通のデータ拡張・画像処理手順を用いました。
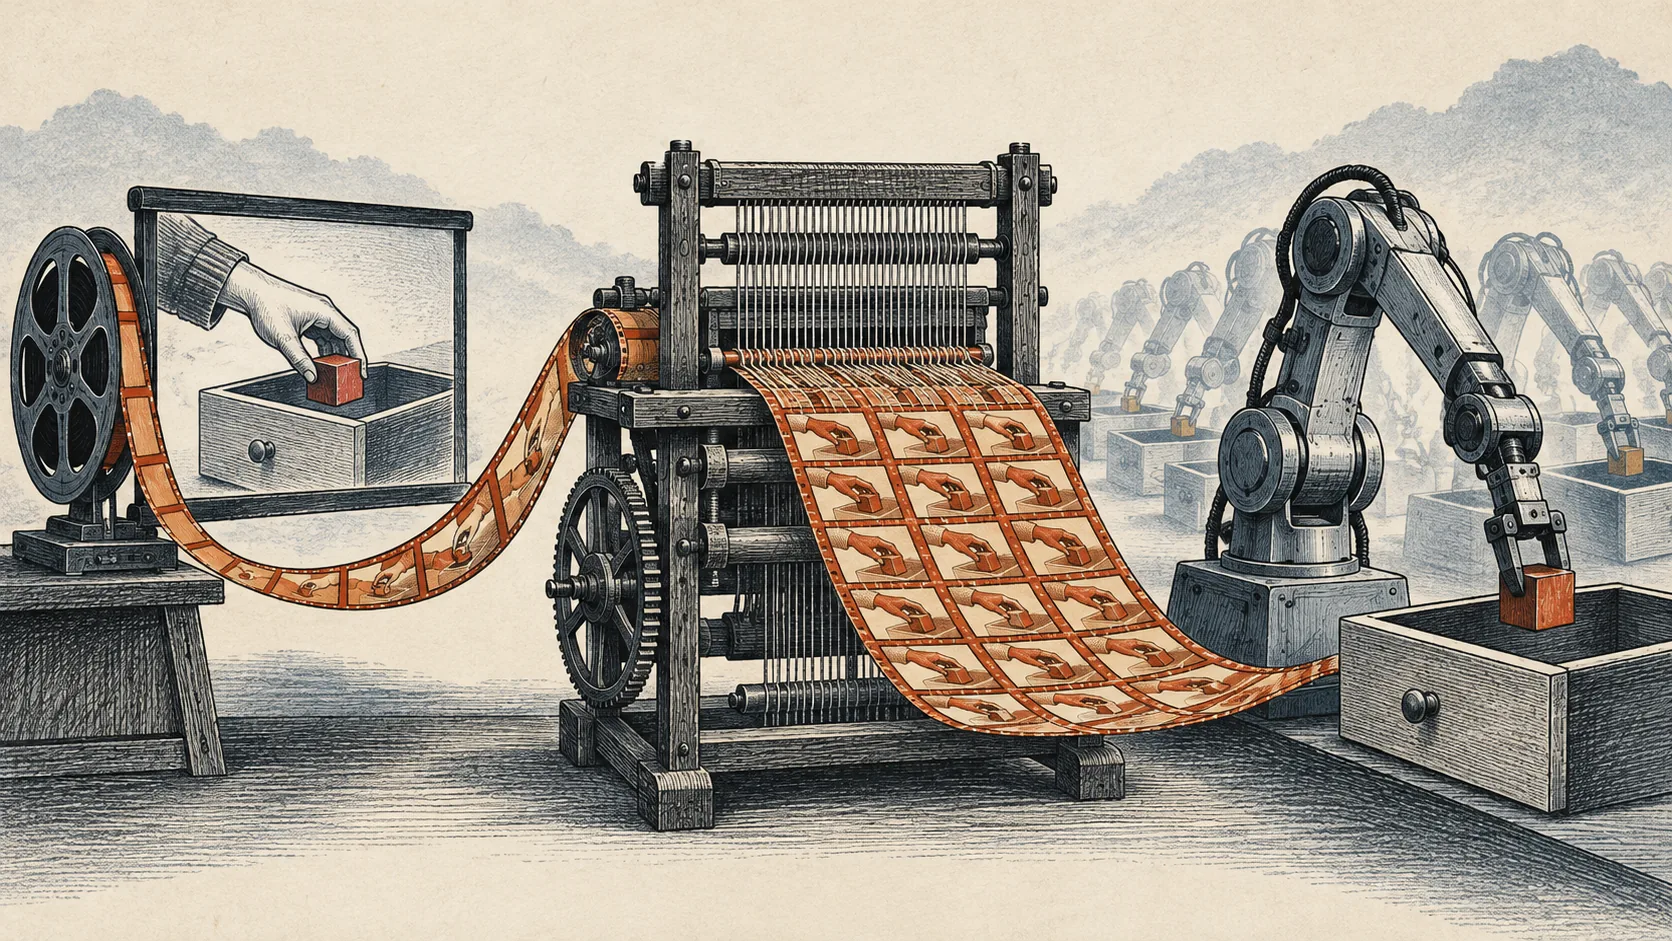
DexAgentは実演動画を4段階で処理します。まず物体やその性質、作業の小目標を特定し、次に物体をシミュレーション上に再現します。その後、ロボットの動きを生成・検証し、最後に多様な訓練エピソードを作ります。瓶のふたを開ける作業では、ふたを回しながら上に動かす動作と、もう一方の手で瓶を固定する役割を表現します。シミュレーションでは、ふたを回すと上昇するかなど、物体が必要な物理的性質を備えているかを確認します。適切な再現用ツールがない場合、DexAgentはツールを作成できます。検証に通るまでシミュレーション上の物体を調整し、パラメーターの異なる追加の3種類でも新機能を試してから、再利用可能なライブラリーに登録します。
ロボットの動作生成では、人の姿勢を手がかりに、指の位置を最適化して必要な接触を再現し、シミュレーション上のやり取りで把持候補を試します。検証済みの姿勢をつないで軌道を作り、前の動作が後の手順を妨げる状態を生んだ場合は、その動作を修正できます。物体とロボットの初期状態を変えながら軌道を調整し、実行可能性を確認します。方策の実験では、作業ごとに検証済みエピソードを500件生成しました。ロボット視点の画像を作る際は、軌道に沿ってシミュレーション上のロボットと物体を描画し、元動画から実演者の手と操作対象を取り除いた場面に合成します。さらに、質感を再設定して見た目を調整します。こうして作ったエピソードを使い、事前学習済みのπ0.5方策を微調整しました。
再利用可能なライブラリーには103種のスキルと188種の検証器が含まれます。EgoDexの動画100本を処理した別の実験では、スキルを再利用すると変換時間が最初の動画の4.3時間から2.2時間に短縮され、物体のアセットも再利用できる場合は13.1分になりました。全体の平均は動画1本当たり2.1時間でした。この実験で蓄積したのは85種のスキルと168種の検証器で、より広範なライブラリーの一部です。研究者らは、シミュレーション上の確認だけでは現実世界での成功を保証できず、実演の誤解、物体の誤った再現、見逃された誤りが後にライブラリーへ引き継がれる可能性があると説明しています。力加減が重要な作業は特に難しく、検証の強化とシミュレーションと現実の差の縮小を今後の課題に挙げました。また、利用可能なスキルで有効な解決策を作れない場合には、強化学習を試す計画です。