AI使い比べAIを探すAIニュースAI活用法
会社紹介
個人情報保護方針利用規約FAQお問い合せお問い合わせ
エーアイビー株式会社事業者情報
© 2026 AIB Inc.

Dharma-AI、遊休GPUに警鐘

Dharma-AI、遊休GPUに警鐘

HuggingFace Blog·2026年7月31日 (金)
  • •Dharma-AIは、企業AIの次の制約はモデル知能ではなくGPU稼働率だと指摘した
  • •マイクロソフトの2020年OpenAI向けシステムは、10,000超のGPUと285,000個のCPUコアを使った
  • •GPU Managementは、訓練、推論、量子化、埋め込み、評価にまたがって作業を継続配分する
  • •Dharma-AIは、企業AIの次の制約はモデル知能ではなくGPU稼働率だと指摘した
  • •マイクロソフトの2020年OpenAI向けシステムは、10,000超のGPUと285,000個のCPUコアを使った
  • •GPU Managementは、訓練、推論、量子化、埋め込み、評価にまたがって作業を継続配分する
  • •Dharma-AIは、企業AIの次の制約はモデル知能ではなくGPU稼働率だと指摘した
  • •マイクロソフトの2020年OpenAI向けシステムは、10,000超のGPUと285,000個のCPUコアを使った
  • •GPU Managementは、訓練、推論、量子化、埋め込み、評価にまたがって作業を継続配分する
  • •Dharma-AIは、企業AIの次の制約はモデル知能ではなくGPU稼働率だと指摘した
  • •マイクロソフトの2020年OpenAI向けシステムは、10,000超のGPUと285,000個のCPUコアを使った
  • •GPU Managementは、訓練、推論、量子化、埋め込み、評価にまたがって作業を継続配分する

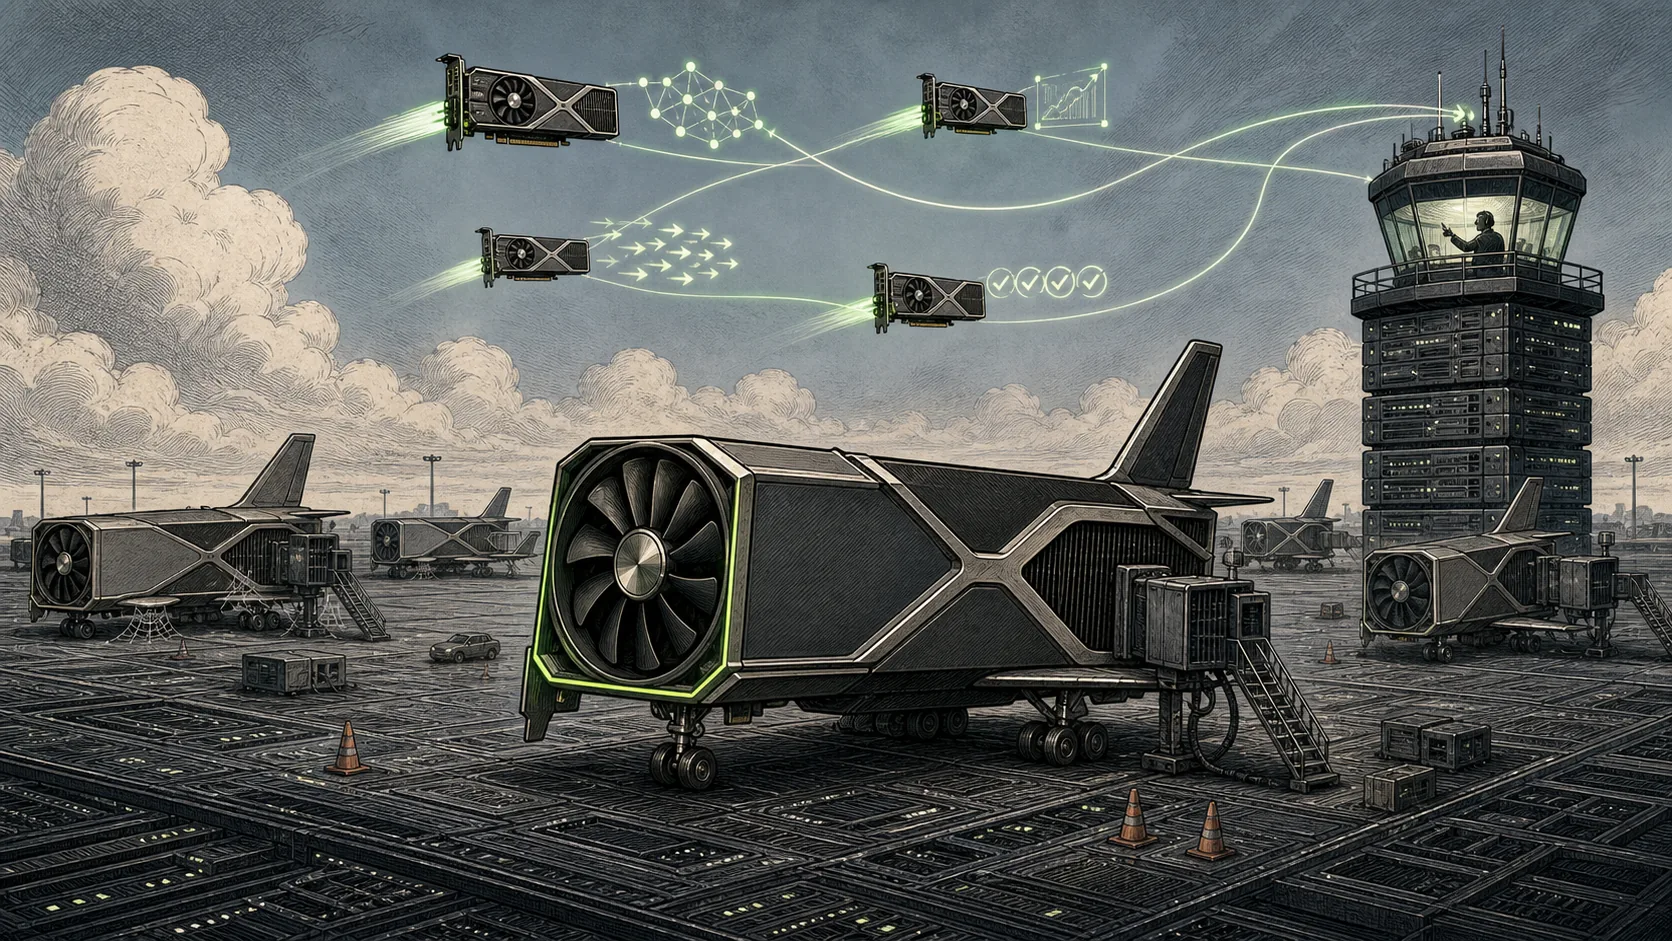
Dharma-AIはJuly 30, 2026、企業AIの次の制約はモデル知能ではなくGPU稼働率だと主張した。GPUは暦上の時間単位で資金調達、減価償却、電力、冷却のコストを積み上げる一方、計算作業を実行している時だけ価値を生むからだ。同社は遊休GPUを地上待機中の航空機になぞらえた。同じような機材を持つ航空会社でも、航空機コストが地上でも続くため採算は変わり、同等のGPU予算を持つAI企業も、任意の時点でどれだけのハードウェアが有用な作業をしているかで差が出るという。

企業AIのボトルネックは、パラメータ数、より厳しいベンチマーク、リーダーボード順位を中心にした初期のモデル競争を経て、モデル品質から計算資源へのアクセスへ移ったとDharma-AIは述べた。例として、マイクロソフトが2020年にOpenAI向けに構築した専用スーパーコンピューターを挙げた。このシステムは10,000超のGPUと285,000個のCPUコアで構成され、当時は世界で5本の指に入る規模のシステムの1つと説明され、GPT-3訓練のための巨大な frontier system と見なされていた。2026年には、その規模はむしろ出発点に近く見えると同社は述べた。AnthropicはAmazon、Google、Microsoft、AMDの4つのハードウェア基盤にまたがる複数のマルチギガワット級契約を同時に進め、Metaも同等のマルチギガワット級契約を結んだという。

API経由でAIを使う企業も、別の形で同じ圧力を受ける。コストが使用トークン数に比例して直線的に増えるためだ。月に数千件のリクエストを処理する概念実証は安く見えても、本番規模では同じワークロードが採算を満たさない費用項目になり得る。Dharma-AIによると、一部企業はGPUを取得してモデルを自社環境で動かし、利用量ベースの変動API費用を固定的な設備投資に置き換えている。ただし、その移行で問われるのは、アクセラレーターを入手できるかではなく、稼働させ続けられるかだ。

Dharma-AIは、忙しく見えるGPUで埋まったクラスターでも容量を浪費し得ると述べた。訓練実行、バッチジョブ、リアルタイム処理が同時に到着するピーク需要に合わせてインフラを用意する必要があり、ピーク外では確保済み容量が未使用になるためだ。同じ企業用ハードウェアに載るワークロードとして、訓練、ファインチューニング、量子化、リアルタイム推論、バッチ推論、埋め込み生成、モデル評価を列挙した。リアルタイム推論は低遅延を必要とし、バッチ作業はスループットを優先して数時間の遅れを許容する場合がある。訓練はGPUを数時間または数日占有し、量子化は短時間だけ大きな容量を必要とすることがある。

Dharma-AIはGPU Managementを、ワークロード、モデル、ハードウェアの間に生まれつつあるオーケストレーション層だと説明した。この層は、どのワークロードを、いつ、どのように、クラスター内のどのGPUで実行するかを継続的に判断する。平均占有率は不一致を隠し得る。あるタスクで使われているGPU形状を待つジョブがキューに残る場合があるためだ。航空機は通常、別路線に再配置できるが、GPUはメモリ、遅延、実行時間の条件が合うワークロードにしか対応できない。

割り当て判断はいま、ジョブ完了、新規リクエスト到着、顧客向けサービスと社内訓練実行の優先順位変更のたびに発生している。Dharma-AIは、GPUを単に忙しく保つだけでは不十分だと主張した。低優先度の作業でも占有率は高く見せられるが、リターンを最大化するとは限らないからだ。目標はダッシュボード上の単純な利用率ではなく、設置された各GPUが生み出す有用な出力で測るGPU ROIである。

Dharma-AIは、特化型の小型モデルなら、必要なタスク品質を失わずに、大型の汎用モデルより少ないリソースコストで特定作業を実行できるとも述べた。特化は各ワークロードが必要とする資源を小さくして容量を解放し、オーケストレーションはその解放された容量を別のワークロード、モデル、キューへ再配分する。同社は、特化とGPU Managementを並行する戦略と位置づけた。一方は資源需要を減らし、もう一方は回収された容量の行き先を決める。

原文(英語)を読む·2026年7月30日
インフラ#gpu management#gpu utilization#ai infrastructure#compute scarcity#orchestration#enterprise ai#quantization#inference#specialized models