EmoReward、動画生成の感情表現を調整
- •Tencent Hunyuanの研究者が、感情を表す動画生成器の学習手法EmoRewardを発表
- •学習時の報酬の信頼性を推定し、次の学習で各信号の重みを調整
- •HunyuanVideo 1.5、SD 3.5、FLUXでの実験が適応的な報酬調整を支持
Tencent Hunyuanの研究者は11月4日、生成動画の感情表現を改善する自己進化型の学習手法EmoRewardを発表しました。11月5日に投稿された論文は、感情表現の動画を評価する難しさに取り組んでいます。評価は主観的な美的判断に左右され、唯一の正解がありません。既存手法では画質、動きの質、テキストとの一致度に固定報酬を使うことが多く、研究者らは感情的な意図を捉え損ねたり、報酬ハッキング(報酬の抜け道を利用する行為)を招いたりする可能性があると述べています。また、人間のフィードバックによる強化学習(人の好みに沿って学習を導く手法)は規模を拡大しにくく、物語の文脈に応じて表情、身体の動き、色の手がかりを判断する際には、個人ごとの美的感覚の違いも課題になると説明しています。
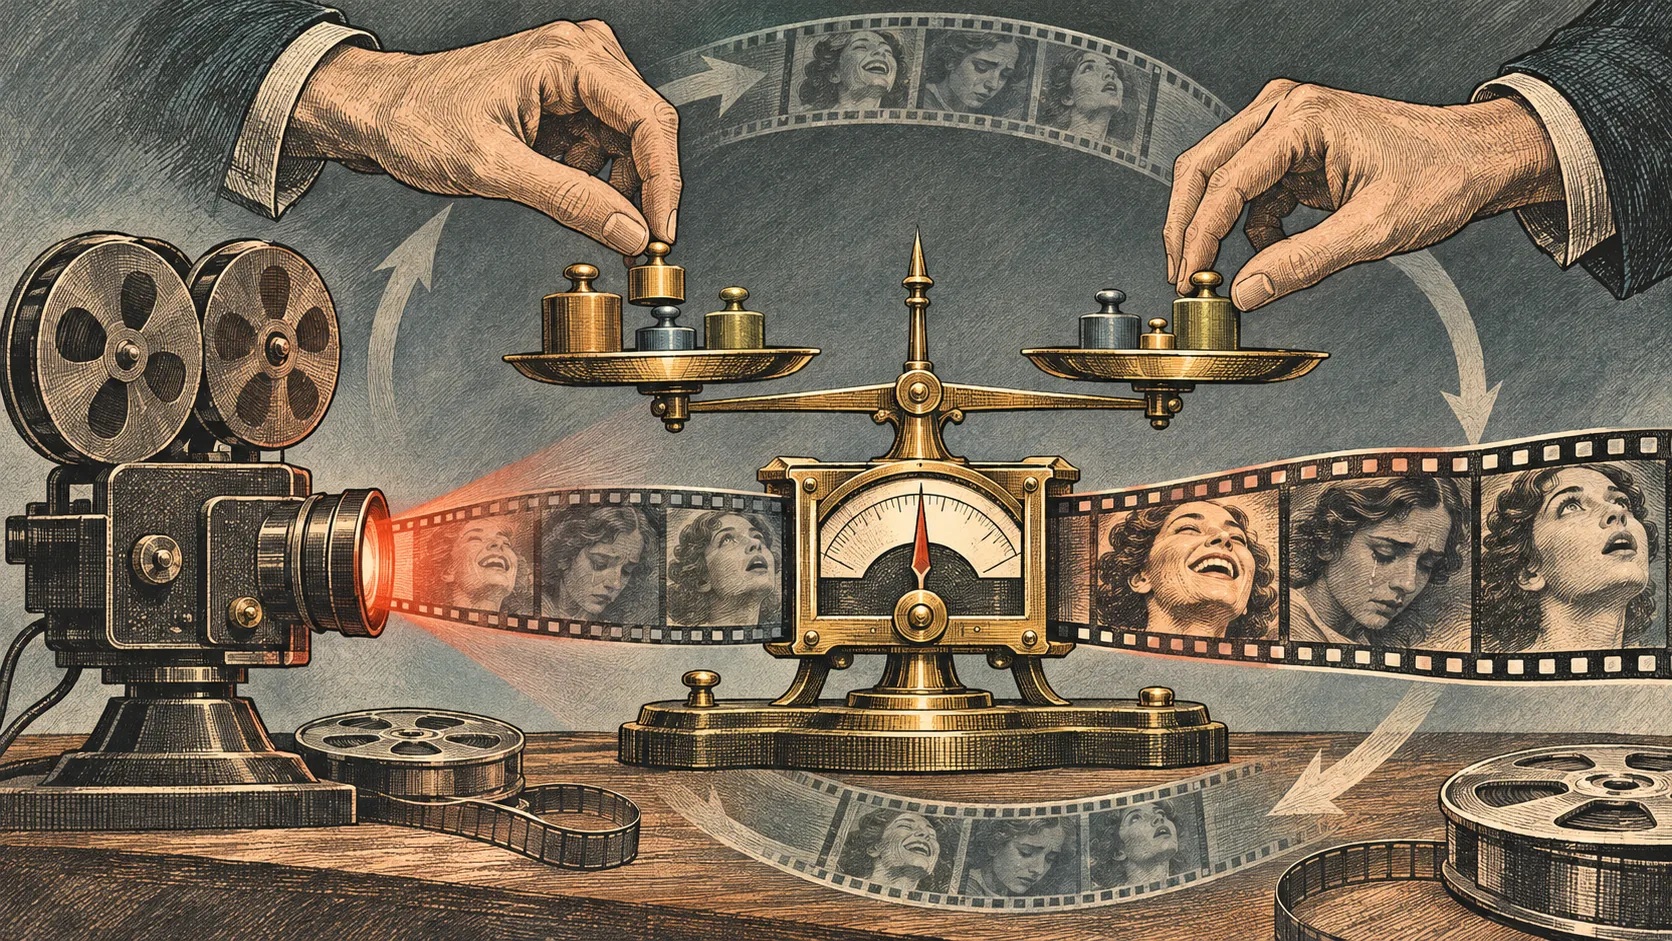
EmoRewardは、学習の実行中に集めた報酬の記録から、どの感情表現の手がかりが信頼できるかを推定し、後続の学習で複数の報酬に割り当てる重みを調整します。まず感情を示す指示文から具体的な視覚的手がかりを計画し、複数種類の信号で生成動画を採点します。Reflective Reward Gatingは、フェーズ、顔の信頼度、信号間の矛盾、表現の微妙さに応じた個別のゲートで各信号の寄与を調整します。続いて有効な信号間で重みを再配分し、サンプルごとの統合報酬を算出します。
RewardMemoryは、完了した学習実行のロールアウト(生成から結果評価までの過程)のスコアと結果を使い、感情の種類ごとに各信号の信頼性を推定します。報酬モデル自体は更新せず、次の学習で報酬の重みを調整するための、上限と下限を設けた倍率を設定します。HunyuanVideo 1.5を使った実験では、複数の強化学習アルゴリズムで改善が示されました。SAGE-GRPOでは、他のエージェント型報酬手法と比較しました。SD 3.5とFLUXを使った要因除去実験と転移実験も、視覚生成における適応的な報酬調整を支持したと論文は報告しています。