音声分離とノイズ抑制を一体化したネットワーク
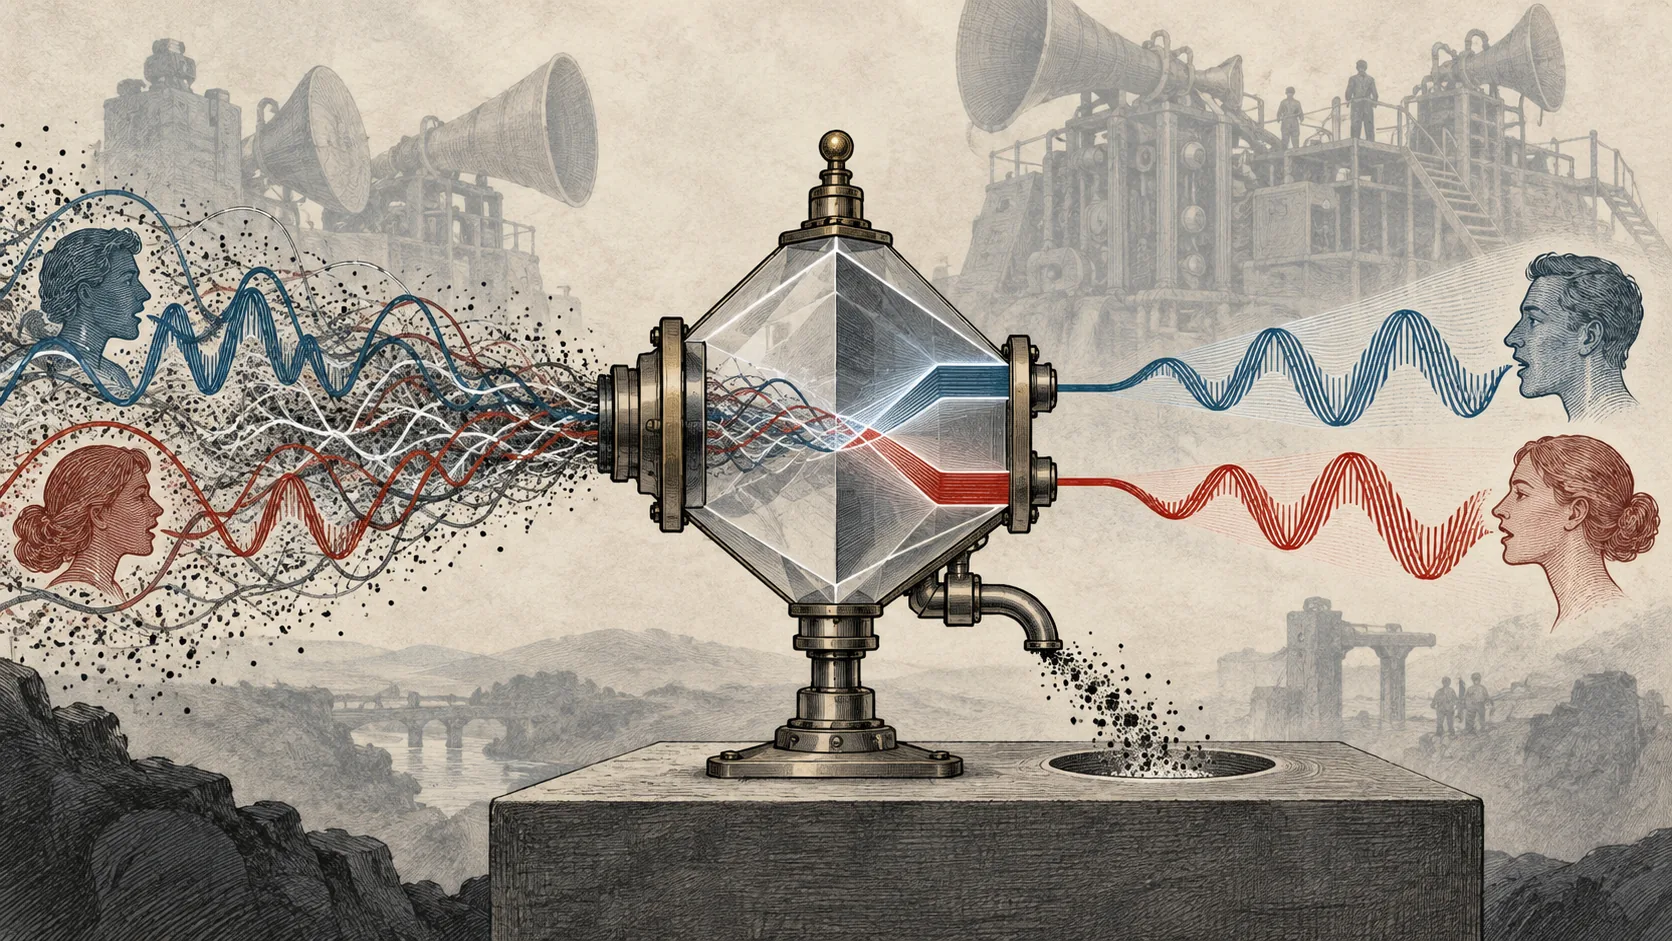
- •共通の音声表現から、重なった話者の分離と変化するノイズの抑制を同時に処理
- •3,000件の混合音声で、入力SNR 0 dB時にSI-SNR改善15.60 ± 0.10 dB、PESQ 3.02、STOI 0.917
- •TF-GridNetとMossFormer2より演算量を7〜11分の1に抑え、スコア差は0.50〜0.80 dB
湖南情報技術大学の研究者が、重なった話者の分離と変化する背景ノイズの抑制を同時に行う深層学習ネットワークを開発しました。学習可能なエンコーダー、多尺度分離器、分離した各音声向けのノイズ抑制モジュール、再構成器を備え、チャンネル方向と時間・周波数方向のアテンションを使います。学習は、スケール不変信号対雑音比、スペクトル振幅、知覚重み付けを組み合わせた3部構成の目的関数でエンドツーエンドに行い、入力SNRが−5 dBの音声も含めました。
評価には音源分離用のLibriMix、WHAM!、WHAMR!、ノイズ抑制用のVoiceBank-DEMANDとMUSANを使い、音声以外も含む全帯域音声の確認にはMUSDB18-HQを使いました。3,000件の混合音声と3つの乱数シードで検証し、同じ条件で再学習した7つの基準モデルと比較した結果、入力SNR 0 dBでSI-SNR改善値15.60 ± 0.10 dB、PESQスコア3.02、STOIスコア0.917を記録しました。パラメーター数は390万で、Conv-TasNet、DPRNN、SepFormer、拡散モデルを使うカスケード方式、分離後にノイズ除去するパイプラインを上回りました。
TF-GridNetとMossFormer2はスコアが0.50〜0.80 dB高かった一方、演算量は7〜11倍でした。提案システムの演算量は音声1秒当たり6.8 G回の積和演算で、CPU 1コアでのリアルタイム係数は0.51、処理音声1秒当たりの消費電力は0.41 Jでした。ストリーミング向けの因果型では性能が1.70 dB低下しました。要素を除いて調べるアブレーションでは、2つのアテンション経路がそれぞれ4.50%と7.10%、分離とノイズ除去を一体化する経路が10.30%を担うとされました。異なるコーパス、未学習の言語、残響のある音声でのテストでは性能低下は0.70〜2.20 dBで、残響時間が0.90秒を超える場合、改善値は7.80 dBに下がりました。コード、設定、発話ごとの記録は研究とともに公開されています。