KAIST、動画世界モデル「World Observer」を発表
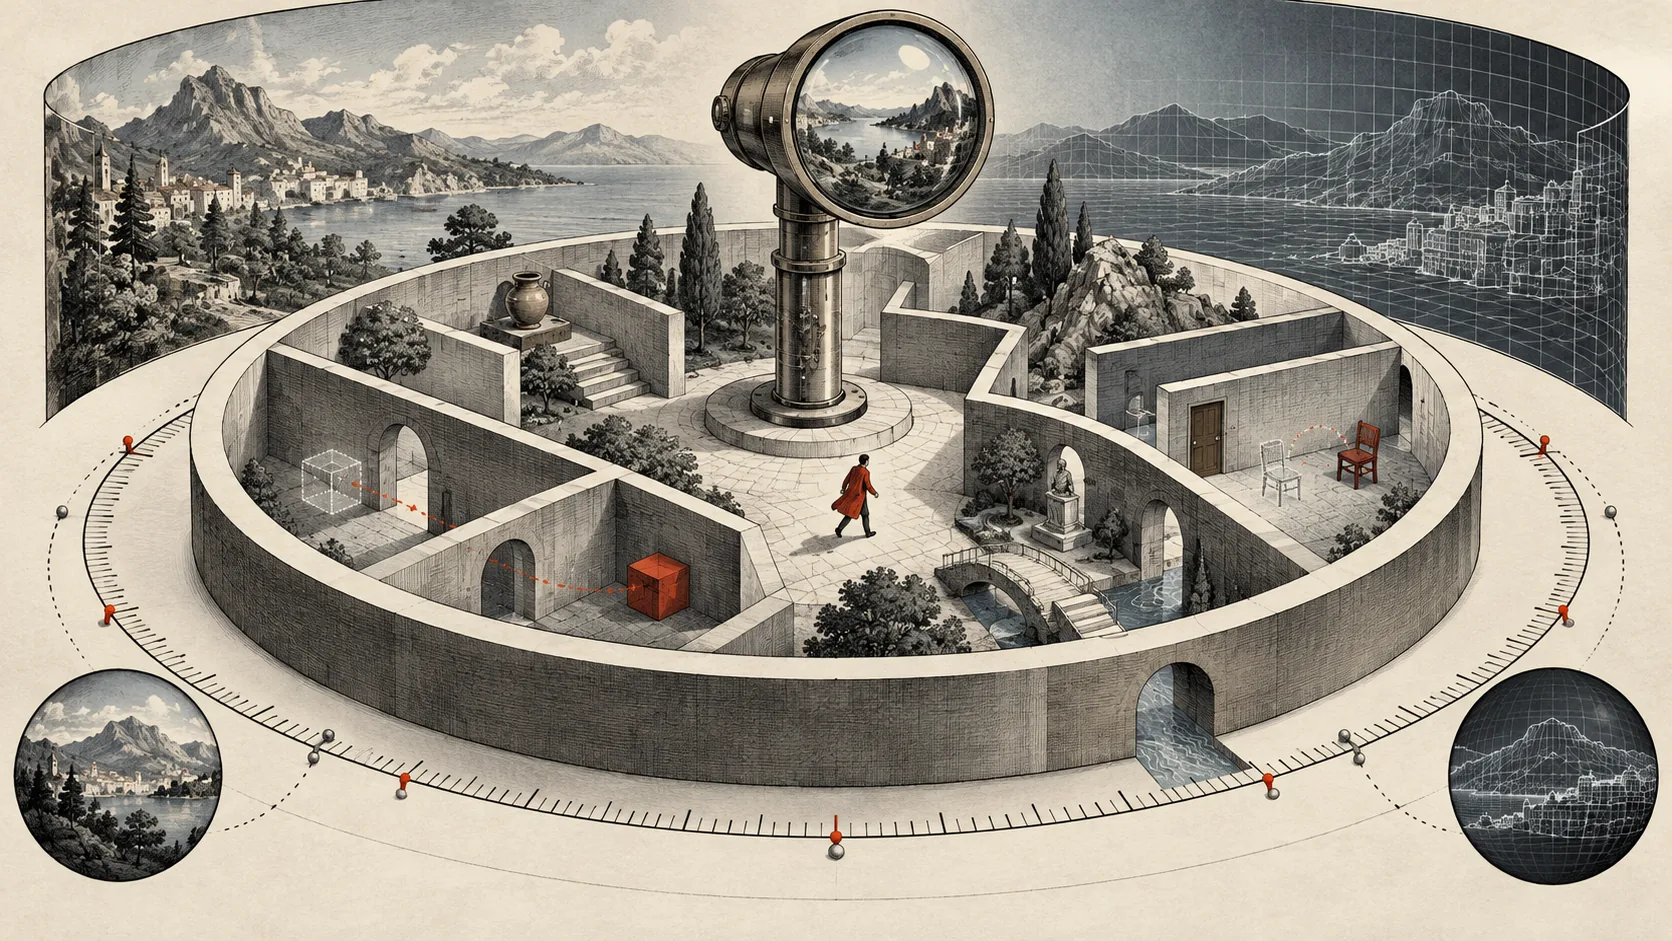
- •KAIST研究者が、行動主体の視点とパノラマ観察者の視点を組み合わせる動画世界モデルを発表
- •観察者が選んだ領域を追跡し、物体が行動主体の視界を離れて戻った後も更新状態を維持
- •視界外の動きを評価する新たなワールド空間指標と、実写・合成シーンのベンチマークを導入
KAISTの研究者は10月1日、行動主体を中心とする視点と、選択した領域を見守るパノラマ観察者の視点を同時に生成する動画世界モデル「World Observer」を発表しました。研究はarXivで公開されました。動画世界モデルは行動主体の操作に応じて環境をシミュレーションしますが、物体が主体の視界から外れると、その後の状態を示す直接的な情報を失い、再び現れた際に状態や動きの一貫性が崩れることがあります。
World Observerは観察と行動を分けます。主体の視界外にある物体も観察者の映像内で見た目が変化し続けるため、主体の視界に戻ったときに更新後の状態を反映できます。システムは共通のパノラマ画像を変形して主体と観察者の視点を作り、各視点間の幾何学的な対応関係を保ちます。また、高解像度の視点参照を蓄える「Observer Sink」を使い、物体が再び見える際に細かな外観を復元します。
観察者はシーン内の任意の場所に個別に配置でき、複数の場所に増やして広い範囲をカバーできます。制御信号で、視界外の領域がどのように変化するかを指定することもできます。研究者はその変化を評価するワールド空間指標と、実写および合成シーンを含むベンチマークを導入しました。報告によると、World Observerは視界外の動きの再現を大幅に改善しながら、映像の忠実度、カメラ制御、3D整合性でも競争力を保ちました。論文の著者はチェ・ヒョヌク、チョン・ダヒョン、キム・ヒョンスン、チン・シユン、チェ・ジンヒョク、ソ・ジュニョン、キム・スンリョンです。公開時点でHugging Faceの掲載ページには70件の賛成票が表示され、ページ上の票数にはさらに62件が加算されていました。同ページでは、論文を引用するモデルやデータセットは公開時点で掲載されておらず、論文全文も利用できませんでした。