KimiとClaudeの文体類似性を解析
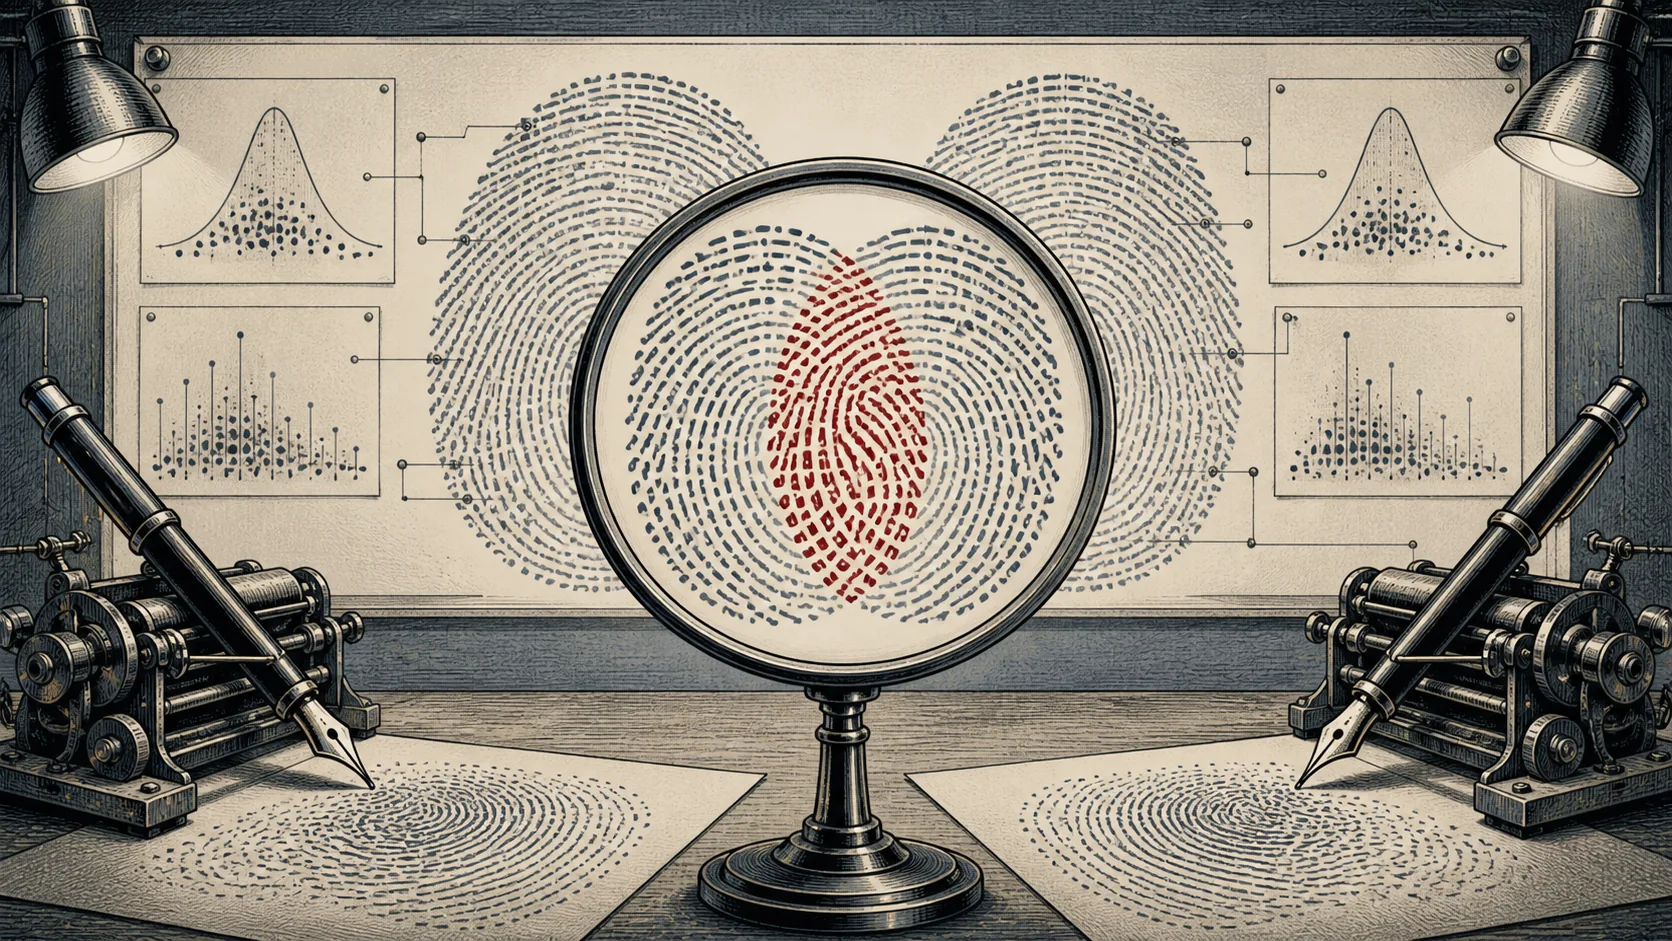
- •「執筆指紋」の解析により、KimiとClaudeの文体間に注目すべき類似性が明らかになった。
- •研究者はトライグラムのエントロピーや言語的な「癖」を用いて、言語モデルの執筆習慣をマッピングした。
- •Typebulb上で公開されたプロジェクトは、ポアソン分布を用いて文体上の重なりを統計的に定量化している。
執筆指紋解析を用いた最新の研究により、大規模言語モデルの文体における類似性が明らかになった。特にKimiとClaudeの間で、パターンの顕著な重複が確認されている。Typebulb上で公開された「You're relatively right!」と題されたこの研究は、各モデルが用いる独自の単語選択や言語的習慣をヒートマップで可視化し、モデル間の文体的乖離を測定している。
研究手法として、モデルの回答からコーパスを構築し、テキストの統計的ランダム性を示す「トライグラム・エントロピー」およびモデル間のクロスエントロピーを算出した。一般的な言語表現を除外し、「癖」と呼ばれる希少なフレーズや単語に焦点を当てることで、モデルが他のモデル群とどのように一致し、あるいは異なるかを定量化している。単一の回答による異常値を除外するため、複数の回答を通じた共通の習慣を検証し、ポアソン分布を用いて偶然の一致である統計的確率を算出している。
本研究は、KLダイバージェンスやクロスエントロピーといった指標を用いてモデルペアを比較する。データによれば、一般的な言語分布において統計的に稀な言語的習慣を共有するモデル同士が、文体的に類似していると判定される。プロジェクトの基盤にはTypeScriptベースの可視化ツールが採用されており、独自の文体署名に基づいて、どのモデルの文章が最も似ているかを特定することが可能だ。
この分析ツールは、表面的な類似性を排除し、モデルが学習過程で形成する根源的な「執筆指紋」を調査するために設計されている。数学的な距離だけでは、情報の伝播方向や一方のモデルが他方の出力を用いて学習したかどうかを断定することはできないが、リリース日を照らし合わせることで文体的な先行性を推測するコンテキストが得られる。本プロジェクトは、現代のLLMが示す観測可能な出力特性を調査する実験的な取り組みであり、ソースコードと手法の全容が公開されている。