Kling報告書、動画理解の課題を分析
HuggingFace2026年11月4日 (水)
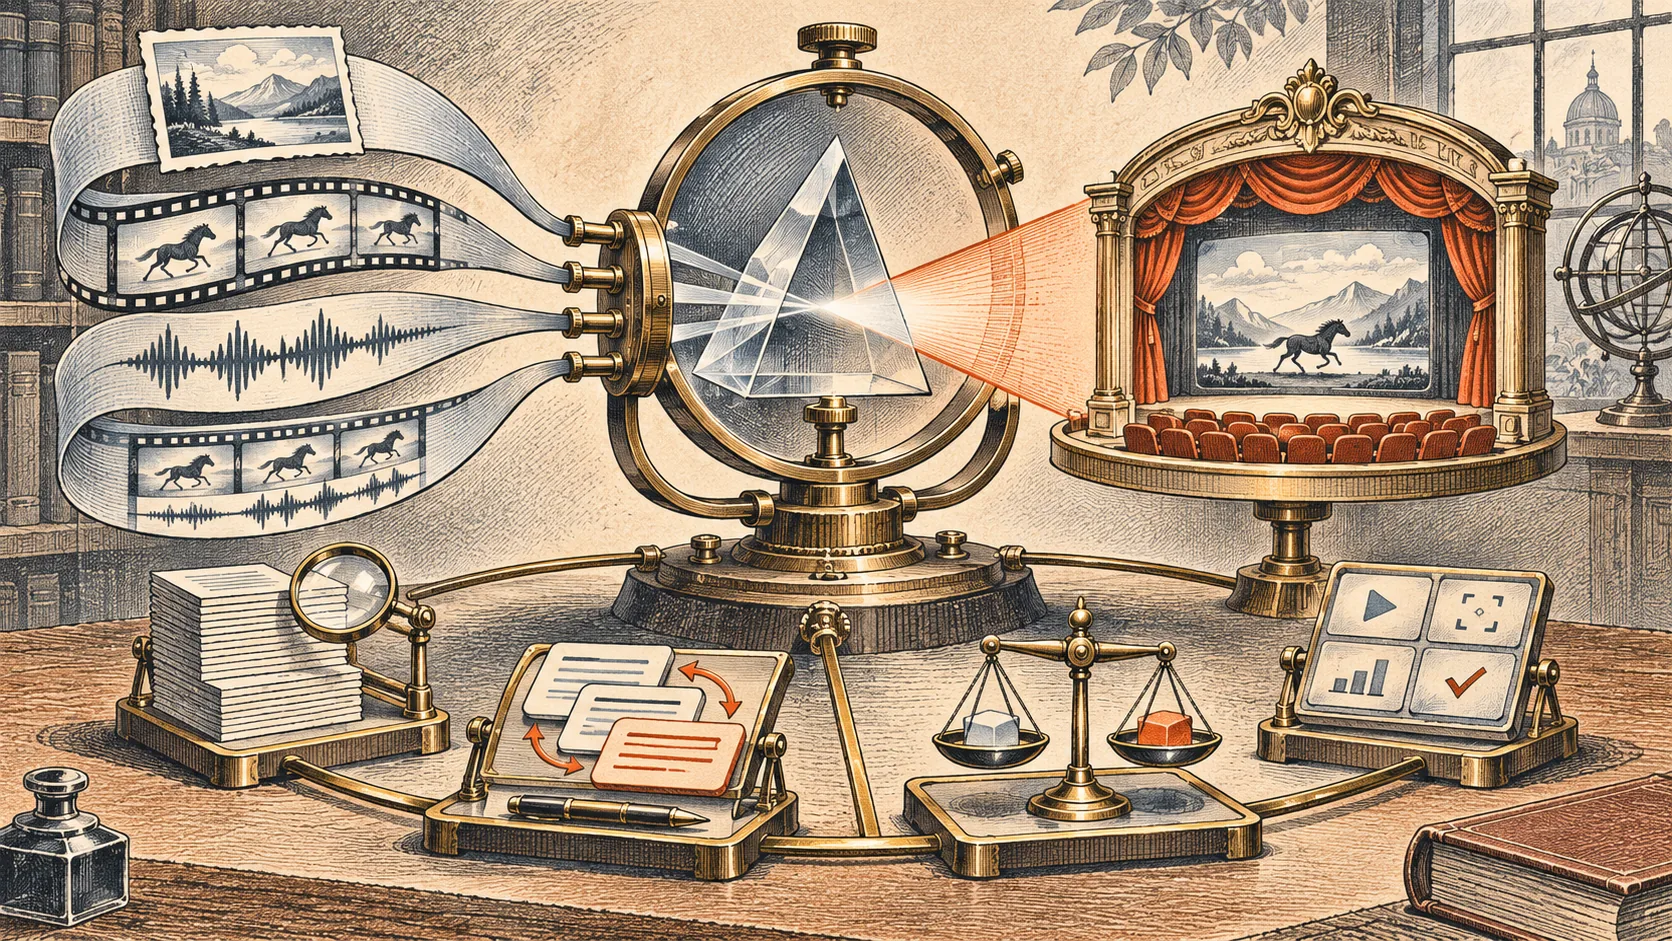
- •Klingチーム、世代を重ねる動画システムの意味制御に関する報告書を公開
- •Kling-MLLMが画像・動画・音声と同期した音声動画を統合し、後続タスクに活用
- •高密度キャプション、プロンプト強化、報酬モデル、タスク別評価を検討
Klingチームは11月3日、世代を重ねてきたKling動画システムの知見をまとめた技術報告書を公開しました。動画生成では意味制御が主なボトルネックになりつつあると論じています。生成品質は描画だけでなく、データ、条件付け、アラインメント、評価までの一連の工程で決まると説明しました。
報告書の中心となるKling-MLLMは、画像、動画、音声、同期した音声と動画、交互に並ぶ入力を統合するマルチモーダル基盤モデルです。チームはこのモデルを後続タスク向けに特化させます。DiTは言語モデルよりはるかに少ない例で学習するため、キャプションを意味の取り決めとして扱い、説明に多くの情報を盛り込むべきだとしています。参照情報に基づくキャプションでは、説明と視覚的な参照との結び付きを明示します。
プロンプト強化は、ユーザーの意図を生成に使える説明へ変換する手法です。チームは印象的な動画のキャプションから基本手法を導き、テキスト段階の強化学習と生成器を学習ループに組み込む強化学習で改良します。エージェント型の手法では、物語をさらに練り、印象的な事例を検索します。また、信頼できるテキストエンコーダーには言語能力の強化より知覚学習が重要で、候補をテキストだけで選別してから端から端までの学習に進めると述べています。
チームは、説明可能で局所的な批評を出す汎用報酬モデルと、複数の尺度を素早く採点する判断報酬モデルを組み合わせ、知覚帯域幅を設計上の重要な要素としています。報告書は、採点の抜け道を明らかにし、失敗を工程の前段階までたどるためのタスク別自動評価手順も検討しました。著者らは、制御可能な動画生成を支えるマルチモーダル理解基盤の構築に向けた実践的な指針として、これらの知見を示しています。