LITがロボットの視覚・行動ショートカットを抑制
- •シンガポール国立大学の研究者が、ロボット基盤モデルの視覚・行動ショートカットを減らすLITを提案した
- •LITはまず姿勢条件付きの行動事前分布を訓練し、次に教師あり潜在インターフェースで視覚入力を制約する
- •LITは4つのアーキテクチャで、LIBERO-Plusの成功率を3.87-10.70ポイント改善した
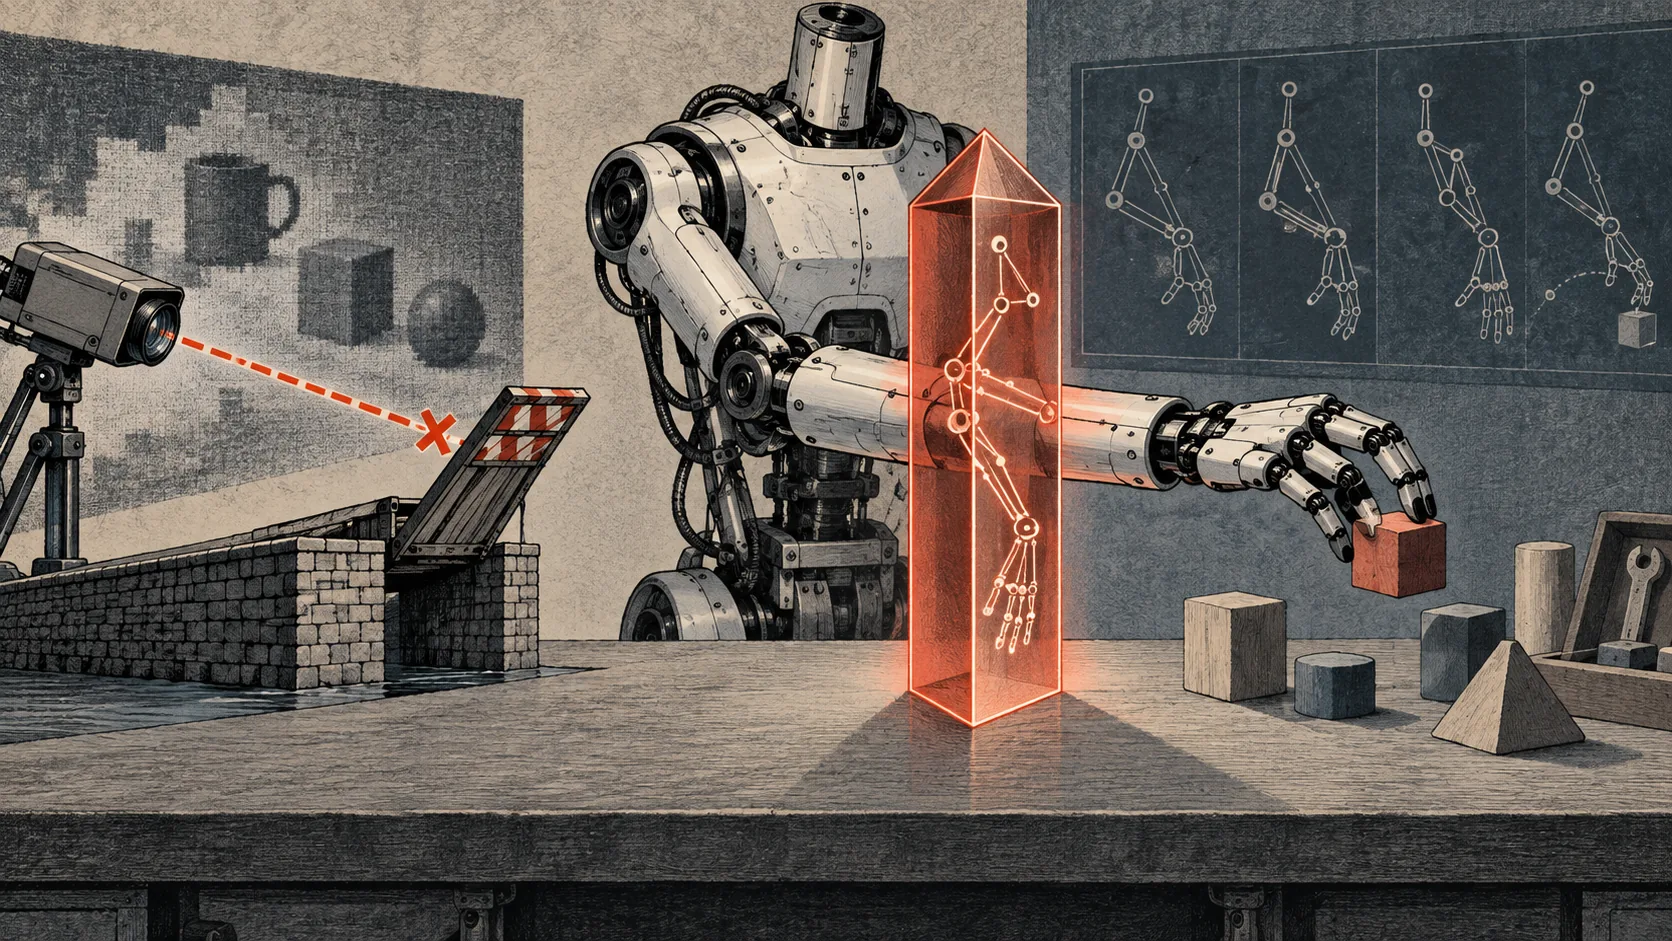
シンガポール国立大学の研究者は、9月11日に公開され、9月14日にHugging Face Papersへ投稿されたロボット基盤モデルの論文で、Latent Interface Training、略称LITを提案した。手法の対象は、訓練分布内では高い性能を示す一方、視覚条件が変わると性能が低下するロボット基盤モデルである。論文によると、こうしたモデルは視覚・行動ショートカットを学習し得る。つまり、訓練中に実演された行動とたまたま相関した、タスクに無関係な視覚的手がかりに依存する状態だ。
LITは、ロボットの行動に視覚情報が及ぼす影響を制限しながら、空間的な目標情報を保つための、フレームワーク非依存の2段階戦略を使う。第1段階では画像を使わず、言語、ロボット状態、各実演チャンクの終端SE(3)エンドエフェクタ姿勢を条件として、行動チャンクを生成する行動エキスパートを訓練する。論文の表現では、これにより視覚的手がかりから独立して、目標指向の行動生成を学ぶ空間目標条件付きの行動事前分布が作られる。
第2段階では、姿勢教師あり潜在インターフェースを追加する。これは姿勢ラベルで導かれる圧縮された内部表現であり、事前訓練済み行動エキスパートにとって唯一の視覚条件付け経路となる。インターフェースは視覚表現と意味表現を集約し、第1段階で使われた終端姿勢を再構成するよう教師あり学習される。狙いは、行動生成に必要な空間情報を残しつつ、無関係な視覚相関から生じるショートカットを抑えることにある。
著者らは、Pi0.5、MolmoAct2、FAST-WAM、ImageWAMという4つの視覚・言語・行動および世界・行動アーキテクチャでLITを評価した。LITはLIBERO-Plus全体の成功率を3.87-10.70ポイント改善し、平均LIBERO成功率を維持または改善した。実世界評価では、未知のカメラ構成、照明変化、妨害物の下で、3タスクを集計した成功率が13.30-16.70ポイント向上した。Hugging Face Papersでは、この研究がその日の#3 Paperとして掲載され、スクレイピングされたページには61 upvotesが表示されていた。