Meta、Museを学習したAIスーパークラスターを公開
AI Times Korea2026年10月21日 (水)
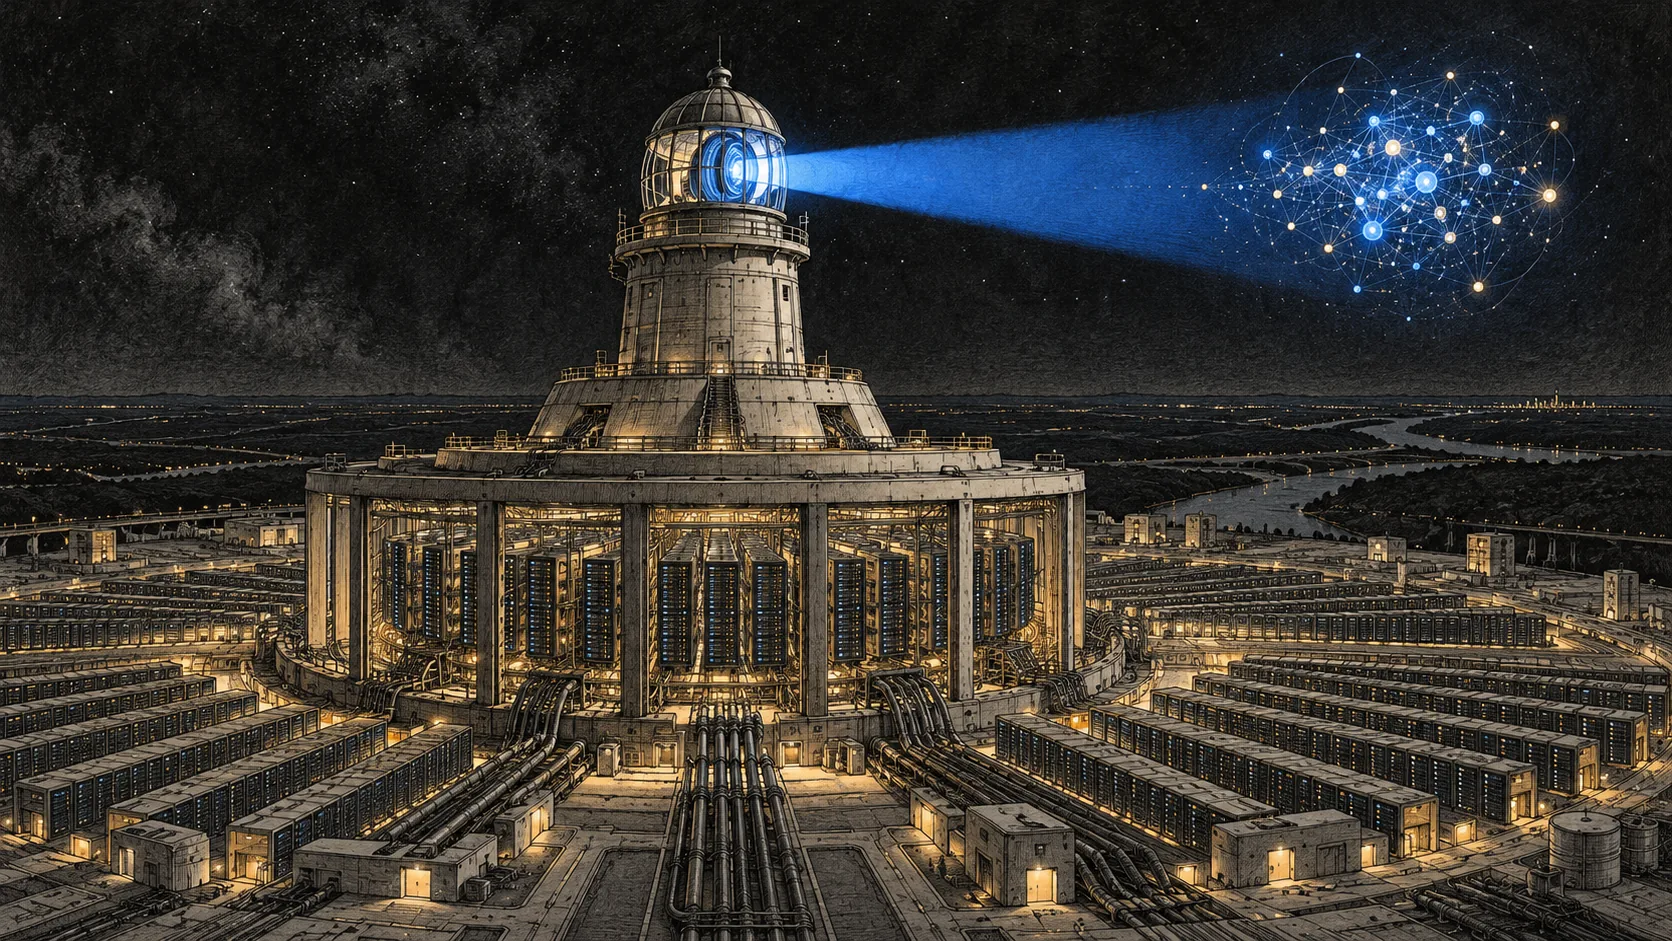
- •Meta、オハイオ州のPrometheus内部を公開、数十万基のGPUが稼働中
- •Prometheusは最終的に約100万基のGPUを目指し、Muse Wonderも学習
- •NVIDIAと連携し、約1年で学習停止を99%削減
Metaは19日(現地時間)、米オハイオ州ニューオールバニに建設したギガワット級AIスーパークラスター「Prometheus」の内部を公式技術ブログで公開しました。同施設は、最近発売したMuseシリーズを支える学習拠点で、現在は数十万基のGPUが稼働しており、最終的に約100万基まで増やす計画です。
Prometheusは、複数の建物に設置したGPUを1台のコンピューターのように動かす施設です。Metaは2年前、一般的なウェブサービスを処理していたデータセンターを大規模AI学習拠点へ転換し、第1段階の建設を終えました。最近発売した「Muse Wonder」もここで学習しました。Metaは12日、「Muse Wonder」と「Muse Wonder Full」を発表し、個人・業務向けエージェント、記憶、コーディングに関する主要評価で最先端の性能を達成したと述べました。
施設ではNVIDIAのGB200・GB300システムを採用しています。GB300は1つのラックにGPUを72基搭載します。建物内外のシステムを接続するため、数万台のネットワークスイッチと数百万個の光通信部品を使用しています。Metaは、多数のGPUを停止させずに同時稼働させることが課題だったと説明しました。NVIDIAと連携し、約1年間で学習の停止を99%削減したほか、故障に備えた予備GPUと液体冷却も導入しました。
Metaは次世代のNVIDIA Vera Rubinを導入し、Prometheusを拡張する計画です。また、Prometheusで得た経験を、ルイジアナ州で建設中の別のスーパークラスター「Hyperion」に適用するとしています。