NVIDIA研究者、ロボット学習のThinkWorldを発表
HuggingFace2026年10月29日 (木)
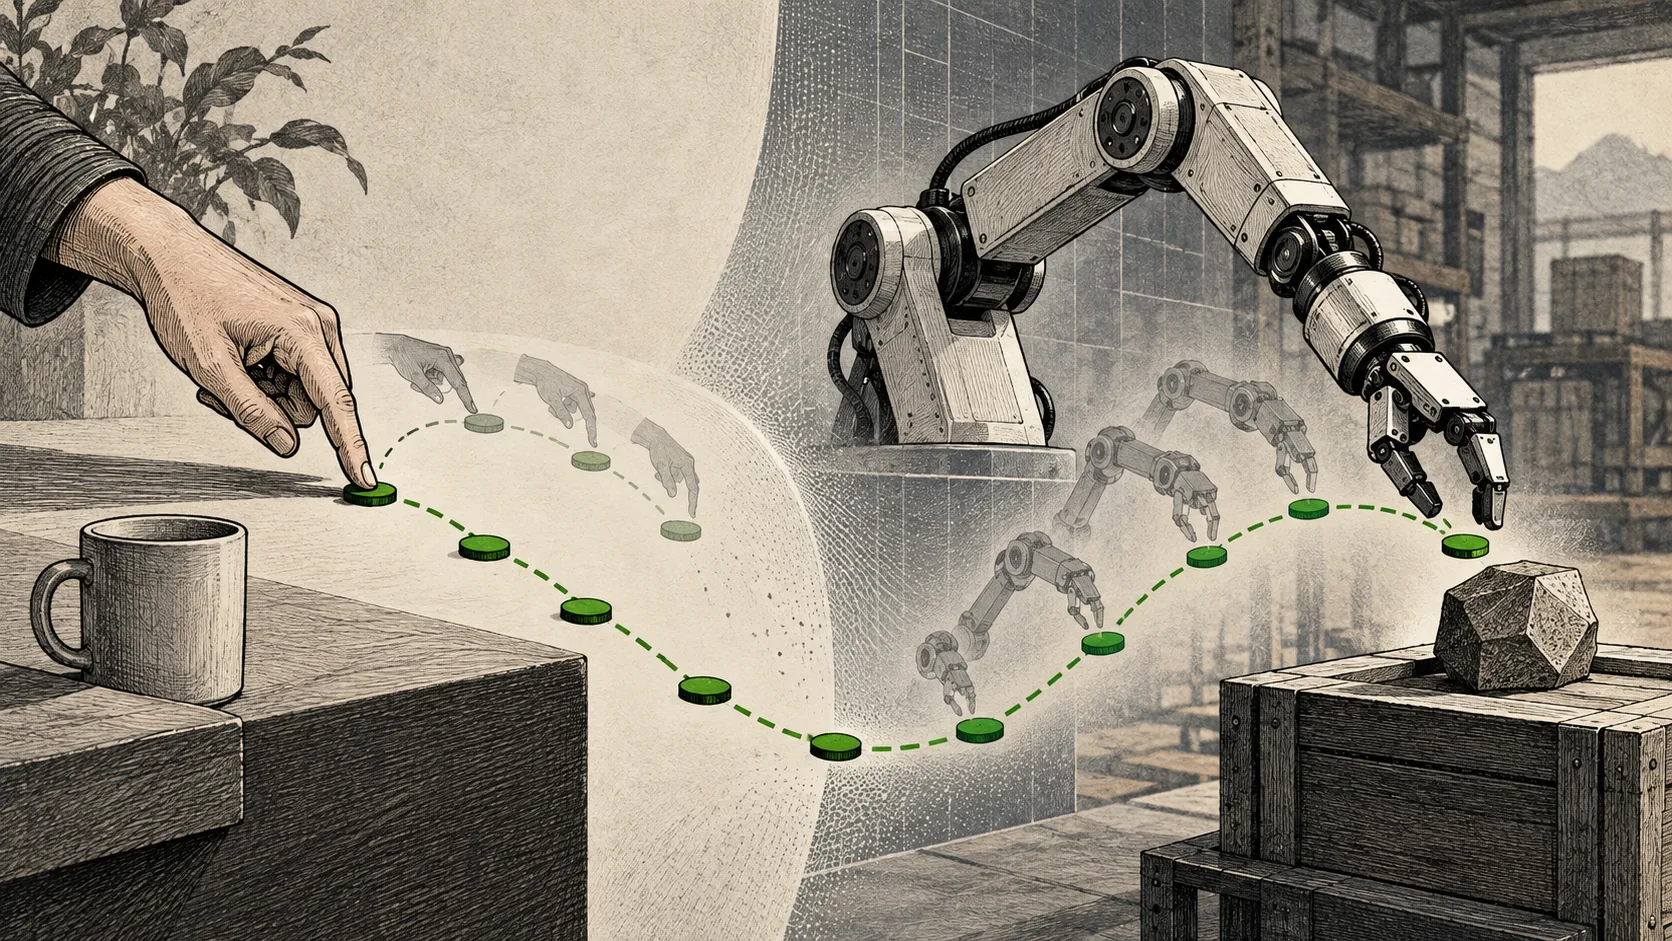
- •NVIDIAの研究者が、人間の動画とロボットの実演から動作を学ぶ枠組みThinkWorldを発表
- •ThinkWorldは、現在から未来の状態への変化を離散的な動作トークン列で表現
- •シミュレーションと実機で、人間からロボットへの学習転移や未経験の課題・環境への汎化を確認
NVIDIAの研究者は、ロボットが学んだ技能を新しい課題や環境に応用しやすくする学習枠組み「ThinkWorld」を発表しました。論文は10月27日に公開され、10月28日にHugging Faceへ提出されました。行動ラベルのない人間の動画と、ロボットの実演の両方から学習します。
ThinkWorldは各動作を「Chain-of-Dynamics(CoD)」として表現します。CoDは、現在の世界の状態から将来の状態までに起きる変化を、離散的な動作トークンの列で示すものです。研究者らによると、この表現によって異なる形態のロボットが動作を共通の方法で表せます。行動ラベル付きの実演でCoDを初期化し、そのCoDが生み出す将来の状態を予測します。
枠組みは、予測したCoDが観測された結果によりよく合うよう学習を強化します。これにより、行動注釈のない動画も、状態間の目に見える変化を通じて学習を導けます。人間とロボットの経験は、同じ動作推論の空間を調整します。研究者らはシミュレーションと実機で実験し、人間からロボットへの学習転移と、未経験の課題や環境への汎化を報告しました。要旨には数値結果や具体的な課題数は記載されていません。論文は、行動ラベル付きロボット実演の多様性と網羅性の不足が視覚・言語・行動モデルの汎化を制約する一方、人間の動画はより幅広い行動や環境の経験を提供するとしています。