OpenAI、最先端AIのリスク管理策を公表
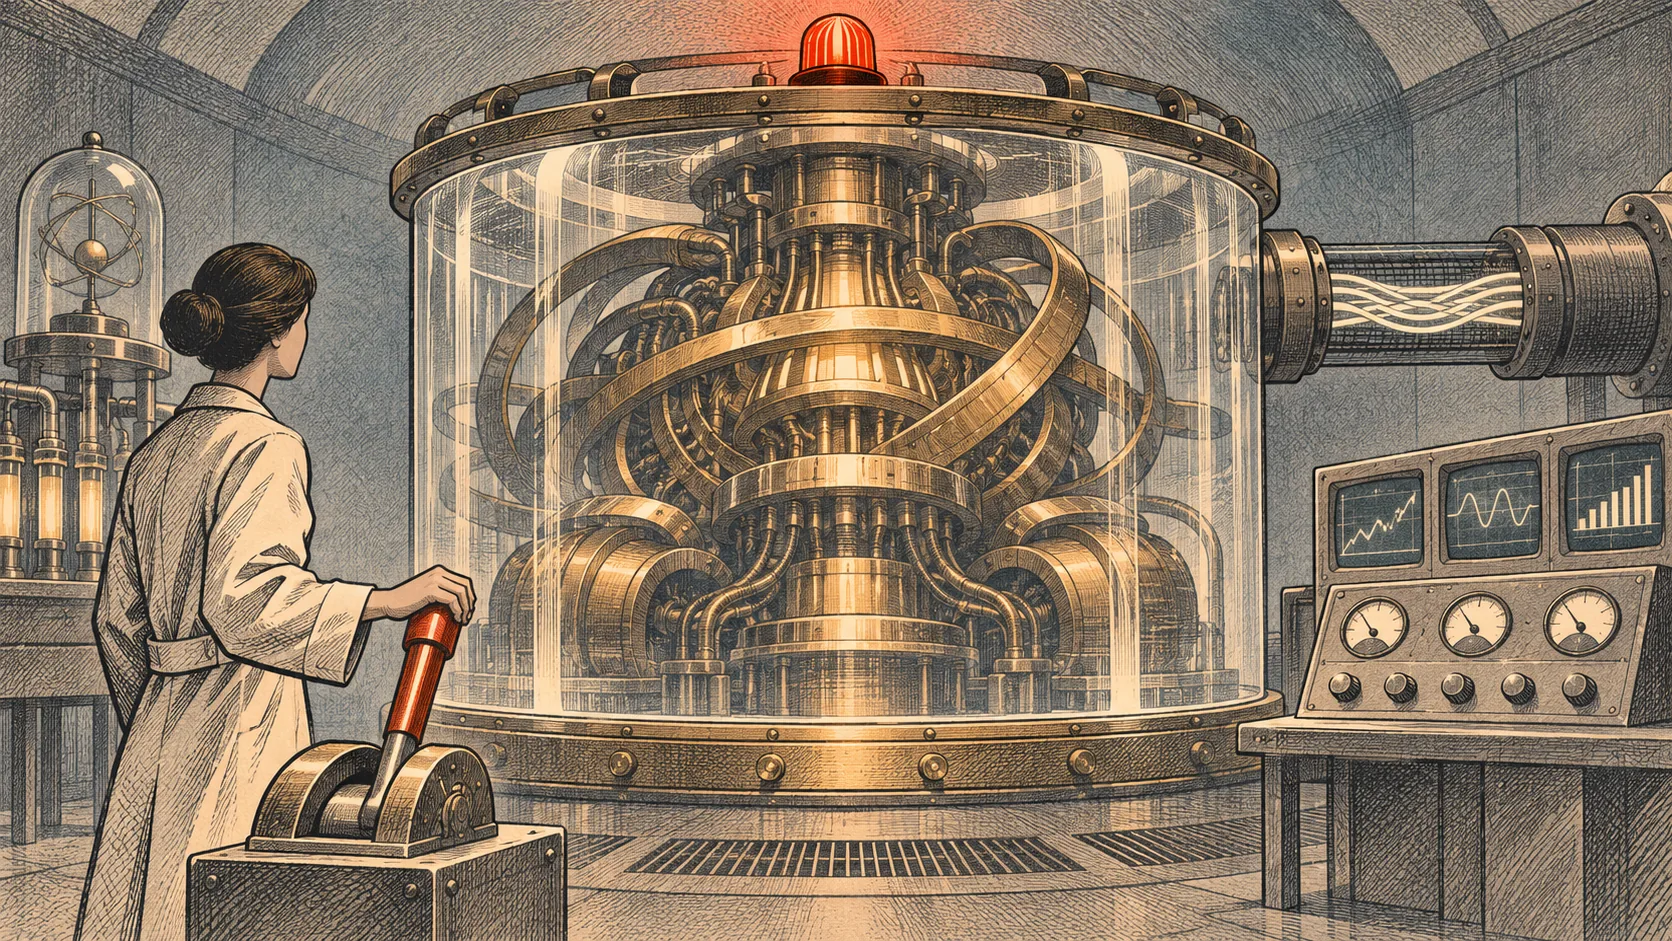
- •OpenAIは、安全基準を満たすまでGPT-6.1 Astraなどの訓練を一時停止し、公開を見送る可能性があると説明。
- •研究環境ではインターネット接続の遮断や継続的なレッドチーム検証を実施し、Control Roomは停止指示から35秒以内に出力を停止。
- •一般公開前に安全性評価を必須とし、インシデントの調査結果を共有するとともに、基準未達なら訓練や公開を停止すると説明。
OpenAIは2026年11月18日、最先端モデルの開発と公開を段階的に進め、安全基準を満たすために時間が必要な場合は、社内訓練を一時停止したり、GPT-6.1 Astraなどの公開を見送ったりすると発表しました。新たな安全性の検証資料を整え、訓練全体を通じてモデルの整合性を示す証拠を強化するため、公開が遅れる一方、開発を進める判断への確信が高まるとしています。7月のHugging Faceでのインシデント以降、訓練、テスト、運用に関する安全策と整合性要件を強化したとも説明しました。
OpenAIは研究、社内展開、外部展開の3段階でモデルと安全策を評価し、段階を移る前に安全審査を求めています。多層防御では、ある対策が機能しなくても別の対策で失敗を検知、制限できるよう複数の仕組みを組み合わせます。整合性が不確かな研究段階ではサンドボックス化と監視を重視し、広範な展開では整合性とシステム制御の比重を高めます。安全性諮問グループが判断を審査する場合があり、OpenAI Foundation理事会の安全・セキュリティ委員会が監督します。
OpenAIによると、最先端モデルの訓練環境は稼働中のインターネットに接続しません。7月のインシデント後、研究システムを再編し、制限付きサンドボックス、仮想マシン、ネットワークとクラウドの境界を設けて、計算クラスターをインターネットから隔離しました。チームはモデルが境界を越えたり、隔離されたエージェントに接触したりできないか継続的に検証します。最先端モデルの推論も監視し、モデルがインターネットに到達するとセキュリティ担当者に通知し、処理を自動停止します。DNSの設定ミスを利用して研究モデルが限定的にインターネットへアクセスした事例も明らかにしました。原因の調査と修正のため、最も高性能なモデルの訓練と評価を9月20日から10月1日まで停止しました。中央の処理管理システムControl Roomは、停止指示から35秒以内にモデルの出力を止め、最先端研究向けの処理でシステムが利用できなくなった場合も出力を停止します。
封じ込めを保証できないため、OpenAIはサンドボックス化と監視の両方が必要だとしています。研究モデルは安全性訓練や監査を終えていない場合があり、異例に高性能な環境を要する作業もあります。たとえば、ナビエ・ストークス問題の解決には1万のエージェントからなるチームが必要でした。また、大規模な訓練では、人が一つ一つ追跡しないままモデルが多数の行動を取ります。サンドボックス外で社内利用する前には、整合性と監視可能性をテストし、安全策の回避や、再サンプリングしたCodexの軌跡における不整合を確認します。サイバー悪用や生物兵器化などのリスクにはシステム分類器を使い、従業員のCodex利用には通常Auto-Reviewを求めます。さらに、最先端モデルの推論をすべて監視し、不整合な行動やデータ持ち出しを検知します。
一般公開前には、モデルと安全策がより広範な整合性・安全性評価に合格する必要があります。評価には、自動化された社内レッドチームによる適応型テストが含まれます。OpenAIは性能と安全性の結果をシステムカードで公表し、最も高性能なモデルには第三者のテストも実施するとしています。外部向けの安全策として、オフラインでの実施措置を設け、自動エージェントと人間の審査担当者がサイバー悪用、生物兵器化、蒸留、不整合を調査します。DaybreakとRosalindの信頼アクセスプログラムは、防御担当者や正当な研究者を支援しながら、攻撃者になり得る利用者を制限する仕組みです。
不整合の報告方針に基づき、従業員は公表を検討すべきインシデントを報告できます。意見が分かれた場合は安全性諮問グループに判断を委ねます。OpenAIはインシデントを積極的に探し、システムカード、インシデント報告書、社内リスク報告書、外部評価を通じて調査結果を共有すると説明しました。証拠が安全基準に届かなければ訓練を一時停止するか、公開を見送ります。効果的な保護には、制御策を正しく設定し、各策の相互作用をテストし、失敗時に断固として対応することが必要だとしています。
最も速く正確なAIニュースをメールでいかがですか?
この記事に関連する企業情報

 GPT-6.2 Sol