Orca Security、Discovery AIでクエリコストを90%削減
- •Orca SecurityとAWS、Amazon Bedrock上に自然言語をSonarクエリへ変換するDiscovery AIを構築
- •9段階の処理で検証済みの例20件を取得し、5件に絞り、生成したフィルターを検証
- •Orcaによると、クエリコストは90%、入力トークンは93%、応答時間は75%減少
Orca SecurityとAWSは、セキュリティ分析担当者がクエリ言語を学ばずにOrcaのクラウドセキュリティデータを検索できるよう、Amazon Bedrock上に自然言語クエリエージェント「Discovery AI」を構築しました。Sonarは900種類を超えるクラウド基盤・アプリケーションのモデルと、それらの関係を扱い、18種類の演算子を使用します。導入前は利用者が正確なモデル名を指定し、入れ子状の関係をたどって、Sonarのスキーマに沿ったJSONクエリを作る必要がありました。
初期試作では、900を超えるモデル定義、関係の種類、クエリ例を1つのプロンプトに入れていました。設計パートナーや社内利用者からは有望な結果が得られた一方、同等の処理1回あたり約200万の入力トークンを使い、応答に約60秒かかりました。複数モデル、入れ子状の関係、条件を含む複雑なクエリにも課題がありました。実運用システムは現在、1日数千件のクエリを約15秒で処理しています。
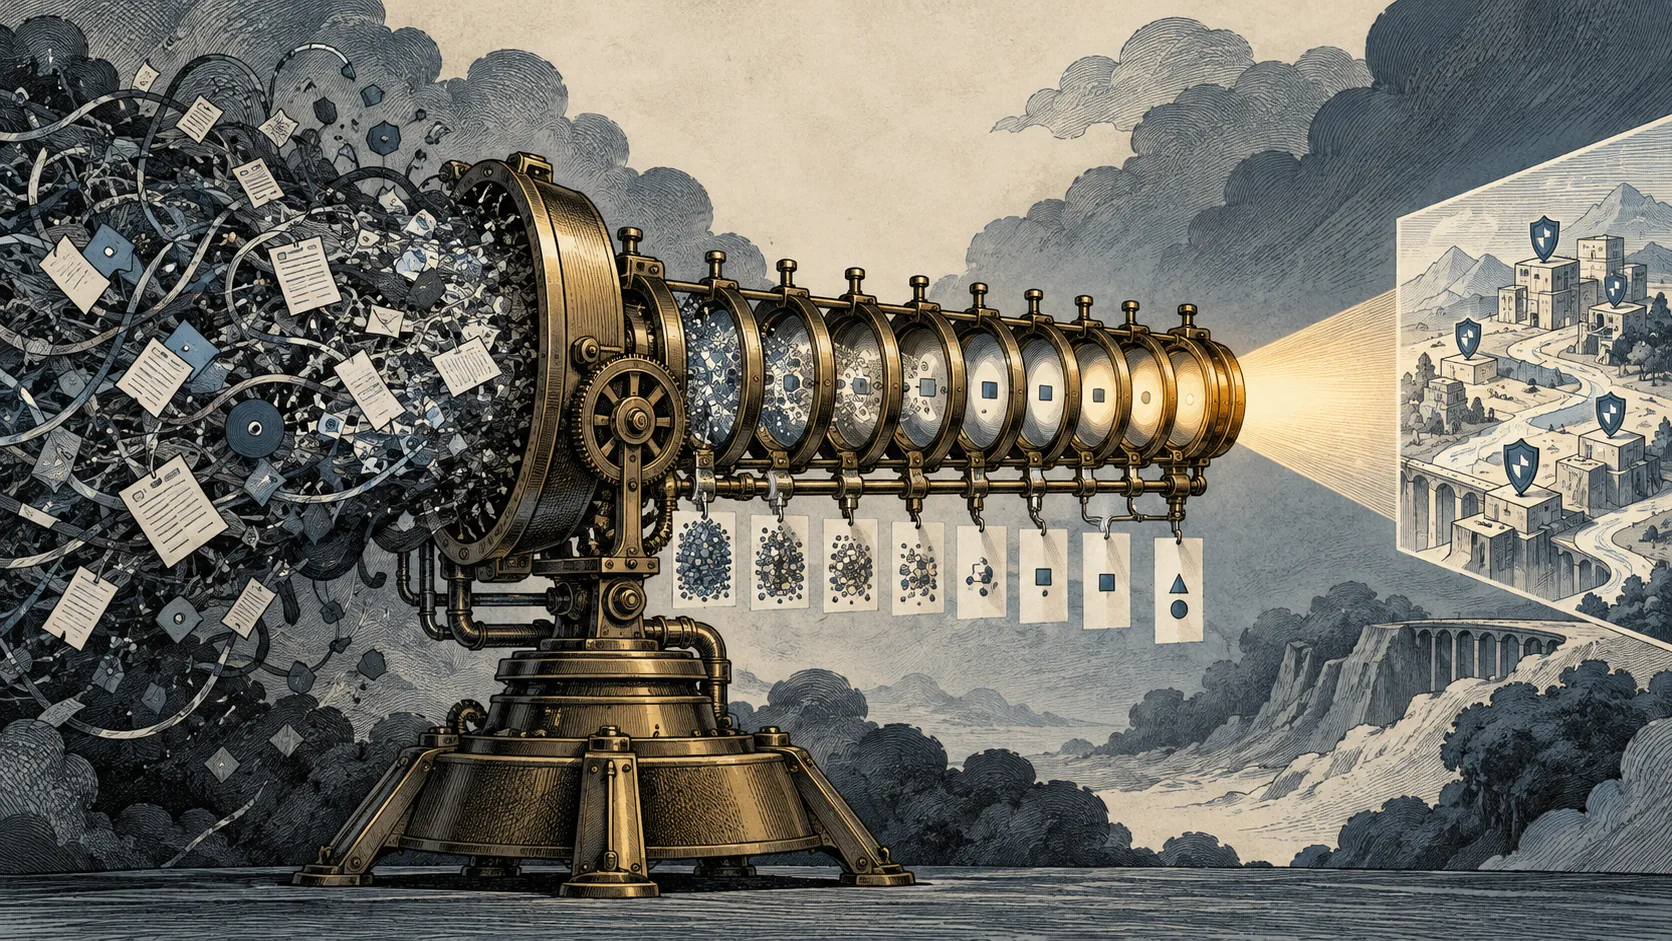
Discovery AIは、関連する例を生成結果の手がかりにする検索拡張生成と、スキーマを踏まえたクエリ構築を組み合わせた9段階の処理を行います。各リクエストに組織、接続済みクラウド事業者、リクエストのメタデータを追加します。ルールベースの照合器はIPアドレス、CVE、ARN、ファイルハッシュ、URL、アラートIDなどの形式化された入力を認識し、言語モデルの推論を使わずに定義済みフィルターを返せます。プロンプトインジェクションの試み、対象外の依頼、未対応の入力は、処理前にガードレールで拒否します。
その他の依頼では、Amazon Titan Text Embeddingsを使って検証済みクエリ例から近い20件を検索し、Cohere Rerank 3.5で関連性の高い5件を選びます。Orcaによると、この組み合わせは、似た例が重複して返る上位K件の意味検索より良好でした。最上位の結果が正しい場合に関連性を下げることがあった最大限関連性多様化よりも適していました。モデル選択器は900を超えるSonarモデルの簡潔な説明から関連モデルを選び、生成器には全スキーマではなく、選ばれたモデルの詳細なスキーマと接続関係を渡します。
Anthropic Claude Haiku 4.5がモデル選択とクエリ生成を担い、Amazon Nova 2 Liteがガードレール確認と検証を行います。Amazon Titanは埋め込み(テキストを数値ベクトルで表す処理)を作り、Cohere Rerank 3.5は検索例を順位付けします。生成器は選択したスキーマ、例、利用者の文脈、ツールを使ってフィルターを構築し、静的チェックとOrcaのSonar APIが検証します。検証エラーは修正のため生成器に戻され、再試行には上限があります。有効なクエリを作れなければ、無効なフィルターとして応答します。Amazon Bedrockは1つのAPIで複数モデルを利用でき、OrcaはAWS Identity and Access Managementの制御、仮想プライベートクラウドのエンドポイント、AWS CloudTrailがセキュリティ要件を満たしたと説明しています。
Orcaは、プロンプト、モデル、検索設定、例の変更を、本番の質問種類、モデル群、複雑さを網羅する選定データセットで評価します。自動化された言語モデル判定器が、正確性、完全性、参照クエリとの意味的な同等性を採点し、区分別の測定で性能低下の箇所を探します。プロダクトマネージャー、サポートエンジニア、セキュリティ研究者は、クエリへの印付け、出力の修正、例の追加ができます。確信度の低い本番クエリは毎日、分野の専門家に回してラベル付けし、次回の処理で修正済みの例をデプロイなしに検索できるようにします。
2026年3月から本番稼働しているDiscovery AIについて、Orcaは初期基準と比べ、同等の処理1回あたりの入力トークンが約200万から14万へ93%減り、クエリ全体のコストが90%下がったと報告しました。処理全体の応答時間は約60秒から15秒へ75%短縮されました。Orcaは評価プロセスで測定した複雑な複数モデルクエリの精度向上も報告しています。システムは1日数千件を処理し、品質は社内専門家と顧客のフィードバックで評価されています。