SemioKAT-FL、動画発作検出の偏りを抑制
- •SemioKAT-FLは動画からてんかん発作を検出し、背景交絡と中央への生動画共有を減らす
- •参照手法はランダム分割の99.5%精度から、被験者単位テストで94.9%に低下した
- •フルアンサンブルは96.6% ± 1.8%の精度、F1 = 96.8%、AUC = 0.93に達した
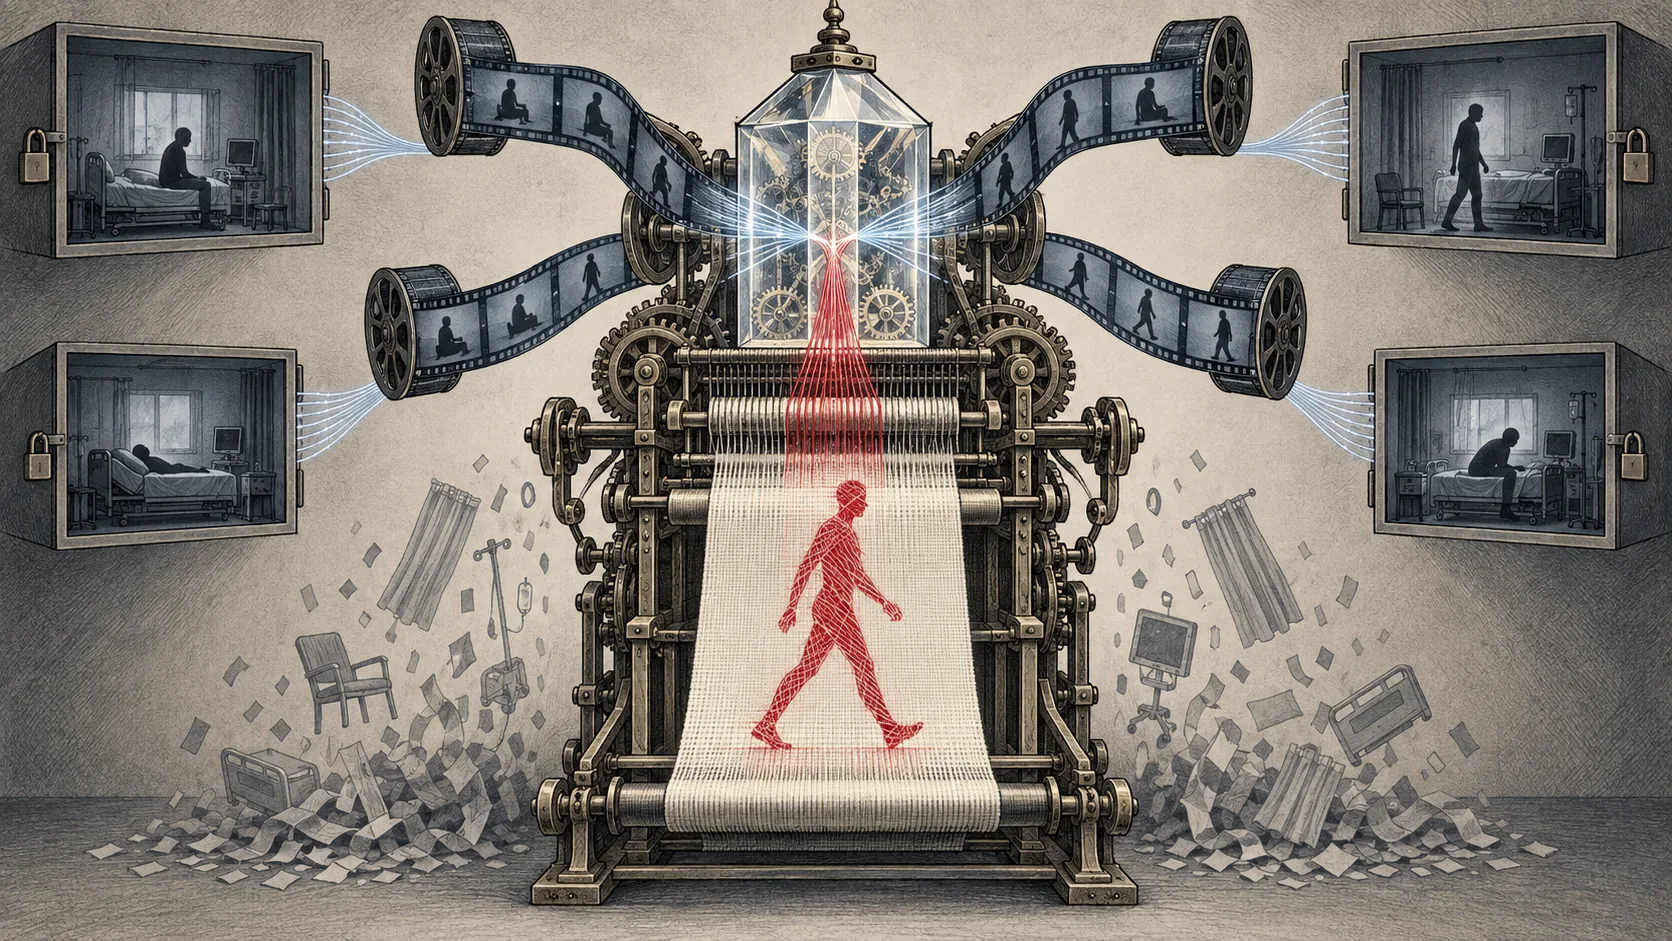
アルハサン・A・アルハルビ(Alhasan A. Alharbi)、ムクタ・ドペシュワルカル(Mukta Dhopeshwarkar)、モハメド・タウフィク(Mohammed Tawfik)の研究チームはSeptember 22, 2026、Scientific ReportsでSemioKAT-FLを発表した。患者の生動画を各ローカル拠点に残したまま、動画からてんかん発作を検出し、背景バイアスを抑え、判断根拠を説明する仕組みである。対象にしたのは、ウェブ由来の発作データセットにある問題だ。スタジオ、自宅、クリニックなどの撮影環境が背景交絡となり、モデルが発作の有無ではなく、どこで撮られた動画かを学習する恐れがある。
SemioKAT-FLは、空間特徴の抽出にImageNetで事前学習したMobileNetV2エンコーダーを使う。その後、マルチヘッド自己注意と、学習可能なBスプラインKANフィードフォワード層を組み合わせたKolmogorov-Arnold Transformerを適用する。時間注意プーリング層は秒単位の顕著性を出力し、どの瞬間が検出に影響したかを示す組み込みの信号になる。勾配反転層で動く敵対的な背景不変性ヘッドは、録画元の情報が復元できる場合にモデルへペナルティを与える。
著者らは、275件の元録画から作られた1,148本のクリップで手法を評価し、漏えいを制御した被験者単位のGroupKFold交差検証を用いた。参照手法を忠実に再実装すると、ランダム分割では99.5%だった精度が、被験者単位のテストでは94.9%に低下した。一方、背景だけを使うモデルも90.4%に達した。論文はこの結果について、従来の評価では背景手掛かりがタスクに漏れ込み、発作認識性能が過大評価され得る直接的な証拠だと述べた。
敵対的ヘッドは、録画元を復元するプローブの性能を70%から50%に下げた。偶然水準は約1.3%だった。著者らは、表現には低減されたものの無視できない録画元情報が残ったとして、この結果を完全な不変性ではなく部分的な不変性と位置づけた。フルのキャリブレーション済みアンサンブルは、ソースレベルのGroupKFoldで96.6% ± 1.8%の精度、F1 = 96.8%、AUC = 0.93、期待校正誤差0.02-0.03を記録した。
学習にはFederated Averagingを使い、生動画が各拠点の外へ出ないようにした。ただし、シミュレーションされたフェデレーテッド設定には正式な差分プライバシーは含まれていない。フェデレーテッドモデルは中央集約型モデルとの差が0.4%以内だった。研究では、YouTubeなどのオンラインプラットフォームにアップロードされたクリップを基にした公開Kaggleデータセットを使用した。保護対象の健康情報や個人を特定できるメタデータはないと報告し、公開フレームでは目をぼかし、匿名化された公開データの二次分析について倫理承認は不要であり、申請もしていないと記した。