研究者、ロボット操作向けSLAモデルを発表
HuggingFace2026年11月7日 (土)
- •研究者がロボット操作向けの空間・言語・行動モデル「SLA」を発表、論文は11月5日に公開
- •視覚表現を3次元認識モデルの空間表現に結び付け、多様なロボットのデータセットとタスクで学習
- •学習時のみ補助機構を使い、推論時の元の構成を維持できると研究者らが説明
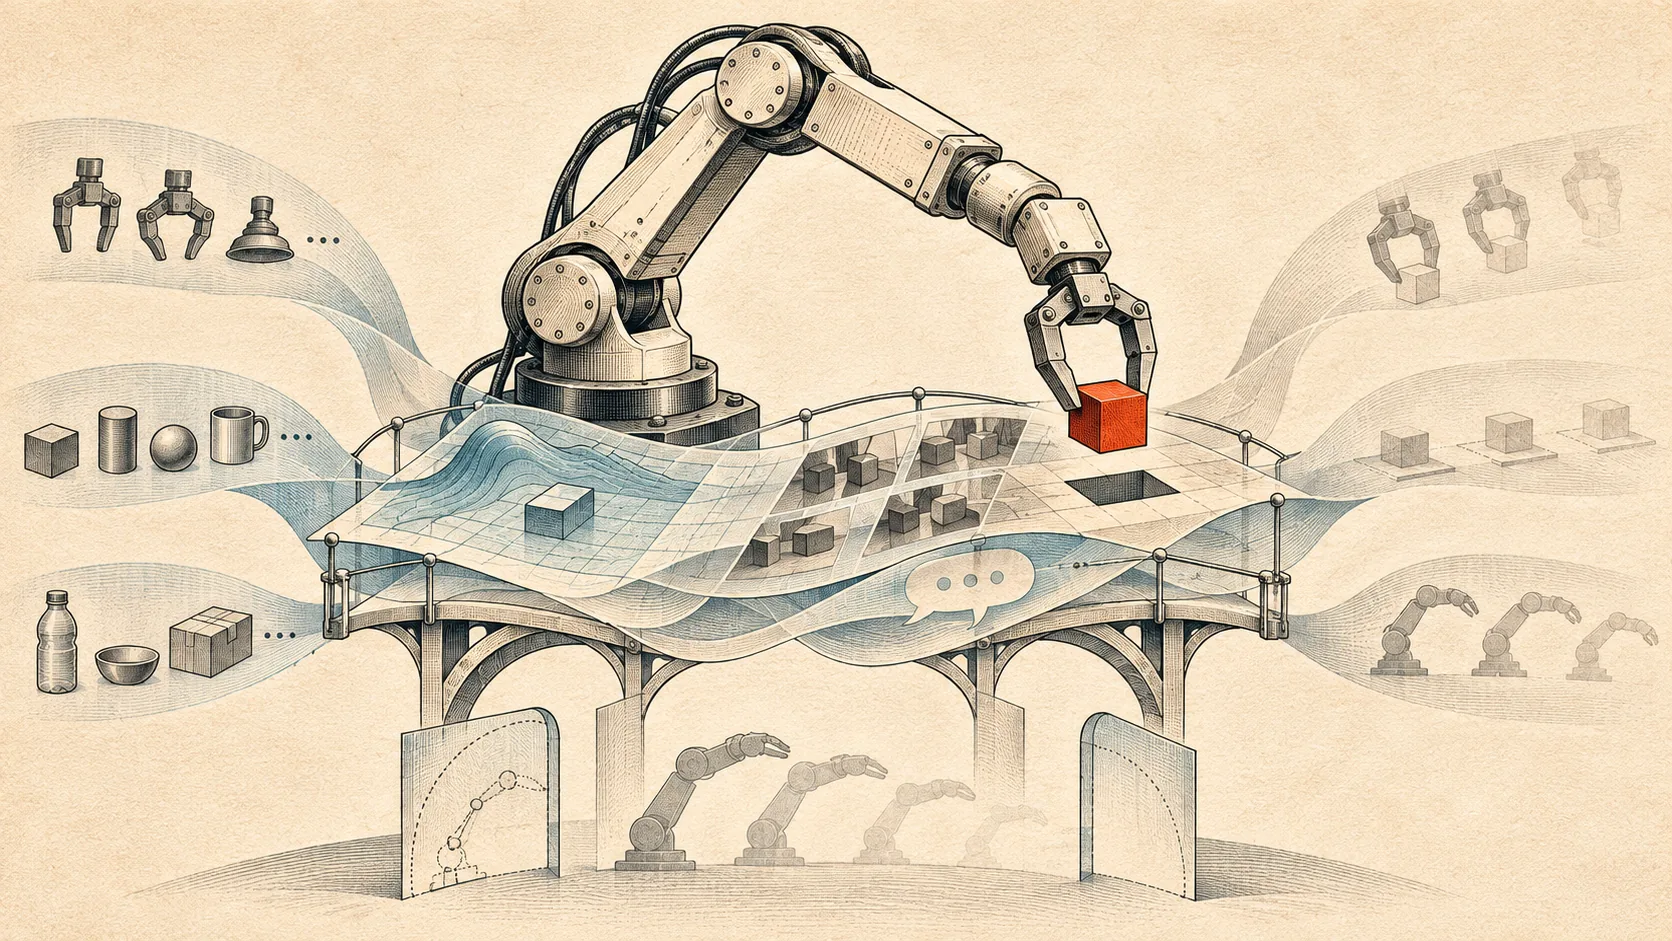
研究者らは、ロボット操作向けの空間・言語・行動モデル「SLA」を発表しました。論文は11月5日に公開され、11月6日に投稿されました。SLAは意味の理解と、3次元空間での精密な制御を組み合わせることを目指します。研究者らによると、視覚・言語・行動モデルは2次元の視覚と言語による事前学習の表現を引き継ぐことが多く、空間情報の学習は特定タスクへの適応時に加えられる傾向があります。
事前学習済みのpi05方策を初期値として、SLAは方策の継続事前学習と事後学習を行います。同時に、中間層の視覚表現を、固定された3次元認識モデルから得る空間表現に整合させます。研究者らは、異なるロボット形態、タスク、場面を含む多様なロボットデータセットを統合しました。特徴に応じたゲート(特徴を組み合わせる学習可能な制御機構)が、複数の視覚・言語・行動モデル層から空間情報の学習に使う視覚表現を選びます。
3次元認識モデルは、RGB画像に加えて利用可能な深度データとカメラの較正情報を使い、多様な幾何学的注釈を活用できるようにします。確率的状態ドロップアウト(学習時に状態入力をランダムに省く手法)は、視覚的な手掛かりへの依存を促し、実演軌跡への過剰適合を抑えます。補助機構は学習時だけ使われるため、事前学習済みの視覚・言語・行動モデルの重みを再利用しながら、元の推論時構成を保てると研究者らは説明しています。