Preferred Networks、画像から3Dシーンを再構成するT3lescope
HuggingFace2026年10月14日 (水)
- •Preferred Networksの研究者が、複数視点の画像から3Dシーンのメッシュを再構成するT3lescopeを発表
- •単一物体から広大な屋外まで、シーンごとの個別最適化なしで処理
- •屋内・屋外・都市規模のシーンで、従来の手法を上回る性能を報告
Preferred Networksの研究者は、複数の視点から撮影した位置情報付き画像を使い、高精細な3Dシーンのメッシュを再構成する手法「T3lescope」を発表しました。単一の物体から広大な屋外まで、シーンごとに別々の3D表現を最適化せずに処理できます。論文は10月2日に公開され、10月13日にHugging Face Papersへ投稿されました。
既存の生成型再構成手法は、学習した3Dの事前知識を使い、画像から得られる観測がまばらな場所の形状を補います。光沢のある面や透明な面も対象です。多くの手法は解像度と扱える空間範囲が固定され、細部の表現とカバー範囲の間で折り合いをつけています。大きなシーンでは重なり合う領域を個別に処理する場合があり、シーン全体で形状を整合させることが難しくなります。
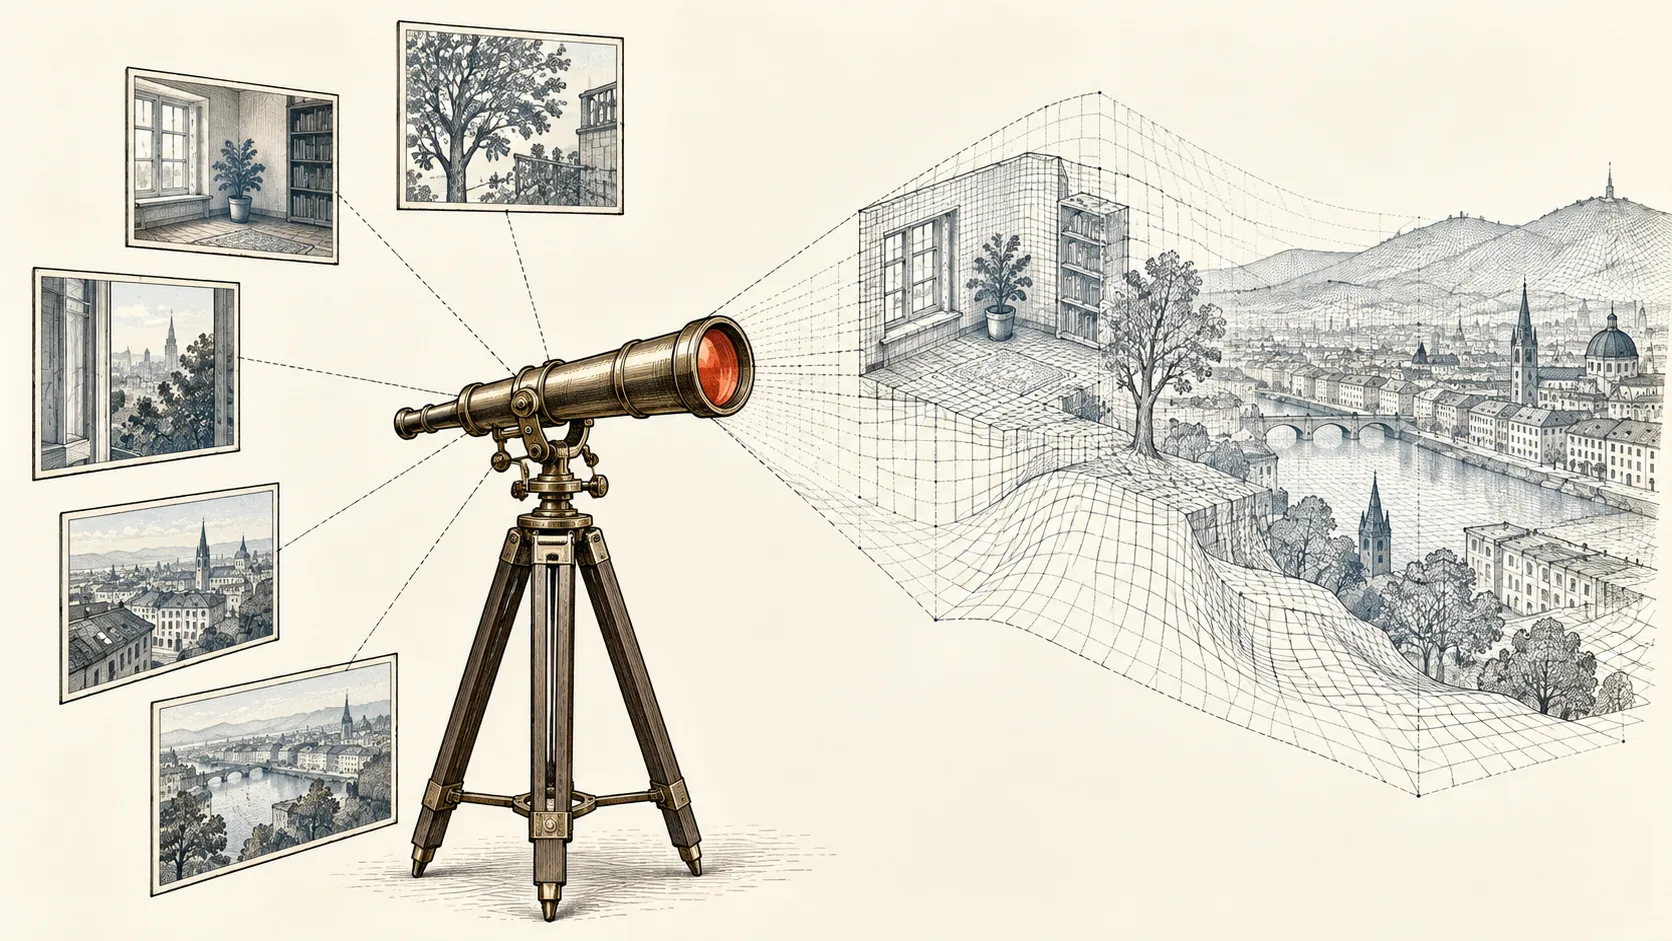
T3lescopeは推論時に粗い段階から細かい段階へ処理を進め、同じ固定解像度の生成器を異なる規模のシーンに適用します。粗い段階で配置を定め、細かい段階では引き継いだ形状に変化を加えてノイズを取り除き、徐々に小さくなる空間セル内で表面の細部を復元します。モデルは複数の尺度の個別セルで学習し、各段階で重みを共有します。段階数、セルの尺度、配置は推論時に設定します。
研究者によると、屋内・屋外・都市規模のシーンで、T3lescopeはフィードフォワード型および生成型の基準手法を上回り、シーンごとの最適化と同等以上の性能を示しました。細かな構造や光沢面、透明面を復元でき、シーンの種類、視点数、画像解像度が異なる場合にも汎化したと報告しています。