AI使い比べAIを探すAIニュースAI活用法
会社紹介
個人情報保護方針利用規約FAQお問い合せお問い合わせ
エーアイビー株式会社事業者情報
© 2026 AIB Inc.

TypeSafe AIがJevを発表

TypeSafe AIがJevを発表

DEV.to·2026年9月19日 (土)
  • •TypeSafe AIは2026年9月15日、DCVC主導の$40MとともにJevを発表した
  • •Jevは型付きの確率的判断を70から500ミリ秒で返し、入力100万トークン当たり$0.042だ
  • •ガイドはChoice、Score、Noulのプリミティブと、ルーティング、採点、検索向けの5つの実装パターンを示した
  • •TypeSafe AIは2026年9月15日、DCVC主導の$40MとともにJevを発表した
  • •Jevは型付きの確率的判断を70から500ミリ秒で返し、入力100万トークン当たり$0.042だ
  • •ガイドはChoice、Score、Noulのプリミティブと、ルーティング、採点、検索向けの5つの実装パターンを示した
  • •TypeSafe AIは2026年9月15日、DCVC主導の$40MとともにJevを発表した
  • •Jevは型付きの確率的判断を70から500ミリ秒で返し、入力100万トークン当たり$0.042だ
  • •ガイドはChoice、Score、Noulのプリミティブと、ルーティング、採点、検索向けの5つの実装パターンを示した
  • •TypeSafe AIは2026年9月15日、DCVC主導の$40MとともにJevを発表した
  • •Jevは型付きの確率的判断を70から500ミリ秒で返し、入力100万トークン当たり$0.042だ
  • •ガイドはChoice、Score、Noulのプリミティブと、ルーティング、採点、検索向けの5つの実装パターンを示した

TypeSafe AIは2026年9月15日、生成テキストではなく型付きの確率的判断を返すフロンティアAIモデルとしてJevを発表した。Jevはプログラム状態と型付き質問を受け取り、1回の並列処理で70から500ミリ秒以内に回答する。価格は入力100万トークン当たり$0.042で、出力は無料だ。JevはDCVC主導の$40Mとともに登場し、OpenAIでRLHFとInstructGPTを共同発明したディオゴ・アルメイダ(Diogo Almeida)が開発した。

TypeSafe AIはJevを「System One」モデルと位置づけ、ダニエル・カーネマン(Daniel Kahneman)の速く直感的な思考を指す用語を借りている。同社の比較では、Jevのエンドツーエンド遅延は70msから500msで、フロンティアLLMは3sから329s。Jevの入力コストは$0.042 / MTokで、フロンティアLLMは$0.20から$10 / MTok。Jevの出力は無料で、フロンティアLLMの出力は入力の約5x。Jevの構造化出力エラーは「設計上」0%で、フロンティアLLMは0.58%から45.5%だ。筆者は、これらがTypeSafe自身の数値であり、自社実行かつ再現されていない点に注意を促している。

開発者はTypeSafeのコンソールからキーを取得できるが、早期アクセスはウェイトリスト制だ。Vercel AI Gatewayからも利用できる。PythonユーザーはPython 3.10+と`typesafe-sdk`が必要で、JavaScriptとTypeScriptのユーザーはNode 20+と`@typesafe-ai/sdk`を使う。両SDKは環境変数`TYPESAFE_API_KEY`を読み込み、既定で`jev-latest`を使い、直接エンドポイント`POST https://api.typesafe.ai/v1/systemone`も呼び出せる。

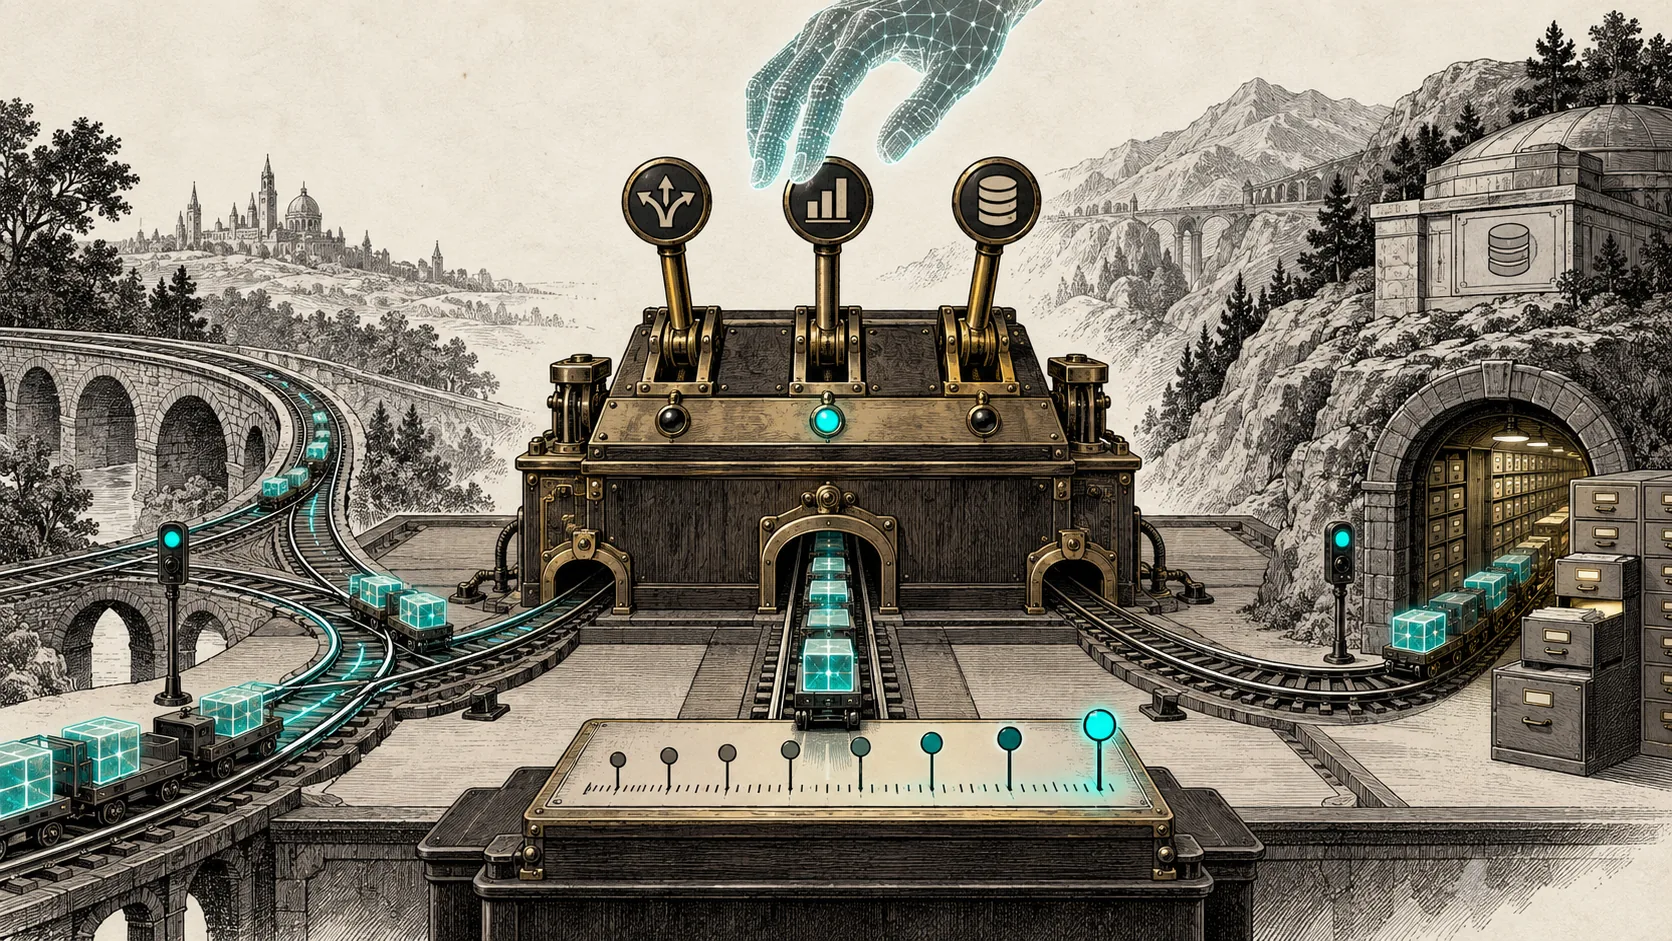
JevのAPIにはChoice、Score、Noulという3種類の質問がある。Choiceは選択肢から1つを選び、`.choice`、`.probabilities`、`.confidence`を返す。最大255個の選択肢を扱える。Scoreは回答を2から10の順序付きレベルに置き、`1.035`のようなレベル間の値も、`.probabilities`と`.confidence`とともに返せる。Noulはyes-or-noの確率として0から1の単一数値を返し、別個の信頼度フィールドはない。

状態は文字列、JSONオブジェクト、テキスト配列にできるが、Jevが受け付けるのはテキストのみだ。画像、音声、動画は、先に文字起こしやキャプション化をしなければ処理できない。コンテキスト上限は、状態と全質問の合計で64k tokens、状態と単一の最長質問の合計で32k tokens。状態は1回だけ取り込まれ、質問は並列実行されるため、筆者は関連する質問を前もって多く投げ、どの回答が重要かはコードで判断する方法を勧めている。

ガイドは5つの実装パターンを挙げている。投機的ファンアウトでは、10個目の質問はトークンを消費するが、時間はほとんど増やさない。TypeSafeのcookbookは、長いWikipedia記事に対する13問の規制関連ブリーフィングで、1回のバッチ呼び出しが1問ずつ尋ねる場合より12.2x安く、10.0x速く、回答は同一だったとしている。信頼度ゲート付きルーティングでは、リスクに応じた異なるしきい値を推奨している。たとえば信頼度0.5未満のメッセージは人間に回し、資金移動を伴う処理の承認には0.85超を求める。

複合スコアリングは、複数のScore質問で別々の次元を評価し、履歴書レビュー基準の0.40、0.25、0.35のように、開発者が管理する重みで結合する。Cascadeパターンは、Opus 5やGPT-5.6のような大型モデルが必要なリクエストをJevで判断する。これにより、ある分岐ではモデル利用を避け、2つの分岐では異なる専門モデルを使い、1つの分岐ではエスカレーションできる。TypeSafeのケース別数値を使うと、100万件のチケット処理は$30,400ではなく約$6,480で済み、約800,000件が10秒ではなく0.5秒未満で回答されるとの推定だ。

最後のパターンは「Retrieve, then judge」だ。Jevは外部情報を検索せず、与えられた状態だけを知る。そのため、無関係な状態は精度を下げる可能性があり、弱い検索ソースでも質の低い材料について較正された判断が出てしまうと警告している。引用された指針は「まずコードで検索とフィルタリングを行い、質問に必要なフィールドだけを送る」ことだ。

原文(英語)を読む·2026年9月17日
#typesafe ai#jev#system one#rlhf#instructgpt#typed decisions#probabilistic decisions#typesafe sdk#vercel ai gateway#confidence routing