Uno、拡散でLLM推論を高速化
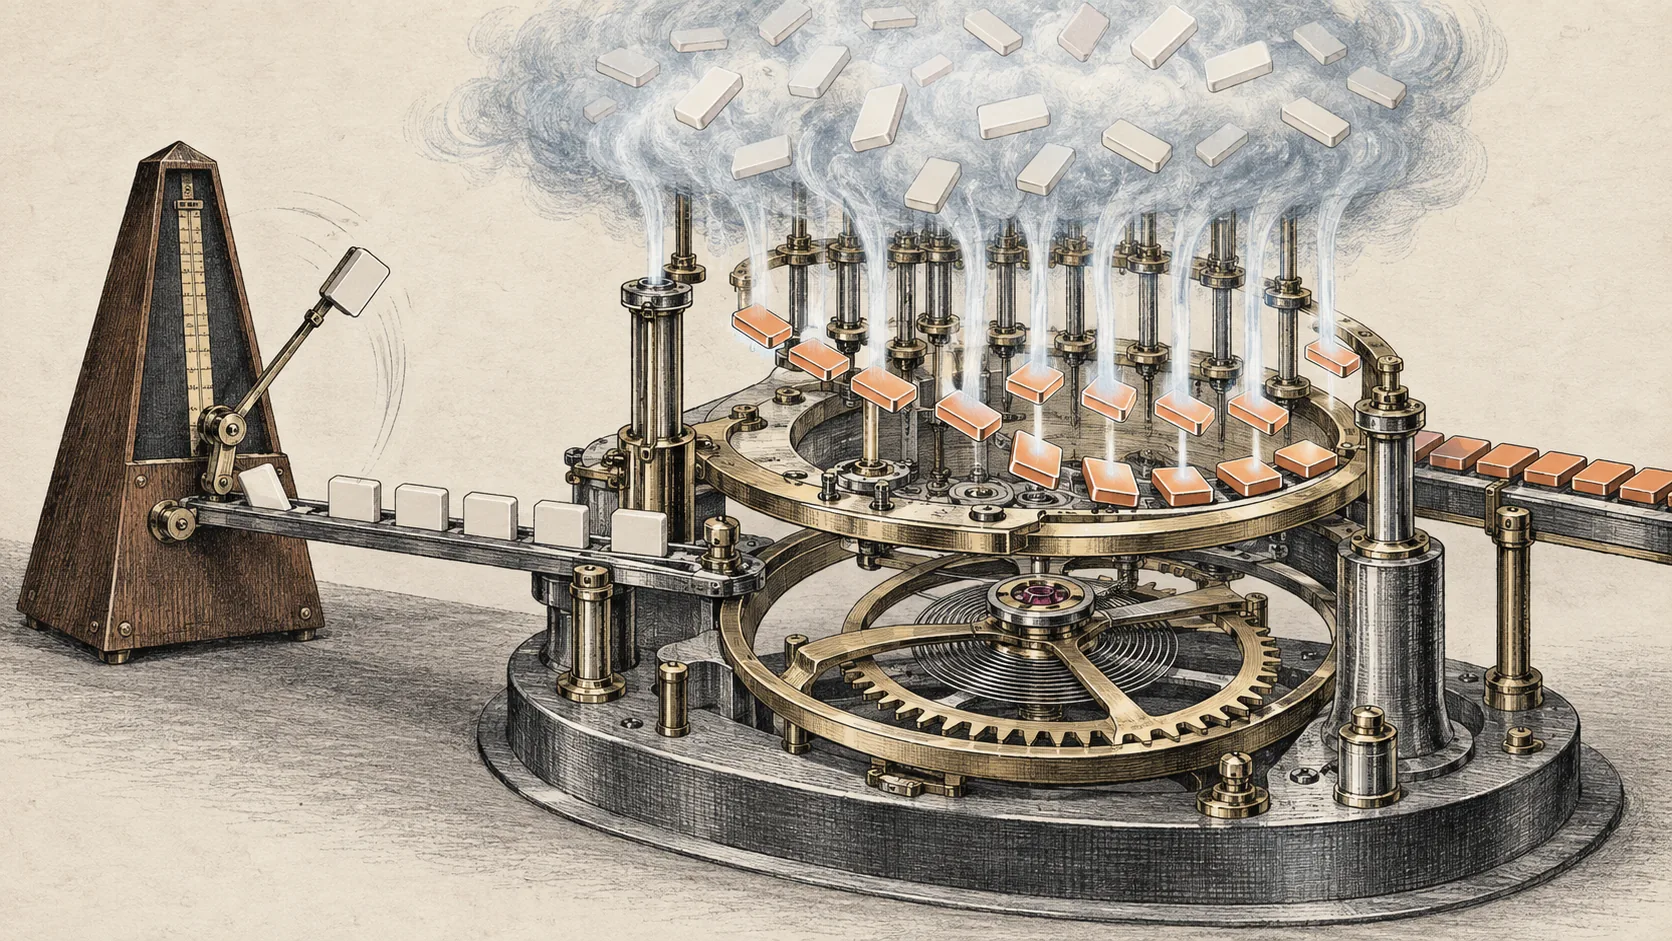
- •Institute of Foundation Modelsの論文が、品質低下なしに並列トークンサンプリングを行う拡散拡張LLMを発表
- •Unoは評価された全バッチサイズでスループットを高め、基盤ARモデル比で最大3times高速化を報告
- •8B Unoは、エージェント型ツール利用、コーディング、長文脈ベンチマークで26B DiffusionGemmaとMercury 2を上回った
Institute of Foundation Modelsの研究者らはSep 3、「Unlocking Lossless Speedups in LLMs via Discrete Diffusion」を公開し、Hugging FaceはSubham Sekhar SahooがSep 8に投稿した後、同論文をその日の#1 Paperに掲げた。論文は拡散拡張LLMを提案した。これは自己回帰言語モデルの確率分布を保ちながら、推論時に拡散を使って複数トークンを並列サンプリングするモデル群である。著者らは、次トークン予測と自己回帰構造によって生じる遅い逐次的トークン生成を対象にした手法だとしている。
提案された構成は、モデルパラメータをAR重みと軽量な拡散重みに分ける。AR重みは標準的な次トークン予測目的で訓練され、拡散重みはDiffusion Distillation段階を通じて複数トークンを同時生成するよう訓練される。著者らは、この段階が既存のLLM訓練パイプラインに加えるオーバーヘッドは無視できる程度だと説明している。システムはΨ-Specも導入した。論文によれば、Ψ-Specは固定された文脈長でロスレスな高速化と推論時スケーリングを可能にするサンプラー群である。
生成されたモデルはUnoと呼ばれる。要旨によると、Unoはゼロから訓練することも、既存のオープンウェイト自己回帰LLMを拡張して作ることもできる。著者らはUnoを投機的デコーディングと対比し、別個のドラフトモデルを必要としない点を挙げた。拡散LLMとの違いとして、基盤となる自己回帰モデルの品質を犠牲にせず生成を高速化する点も示している。
論文は、Unoが評価された全バッチサイズで主要な投機的デコーディング手法より高いスループットを達成し、デバイスが対応する最大バッチサイズを含め、基盤自己回帰モデル比で最大3timesの高速化を実現したと報告した。著者らは、8B Unoモデルがエージェント型ツール利用、コーディング、長文脈推論の評価対象ベンチマークすべてで、主要なオープン拡散LLMである26B DiffusionGemmaとプロプライエタリなMercury 2を上回ったとも述べている。
Hugging Faceのページには、42件のアップボート、44件のコレクション操作、論文を引用する5モデル、引用する0データセット、引用する0 Spaces、同論文を含む1コレクションが表示されている。著者には、Subham Sekhar Sahoo、Lingjie Chen、Khiem Pham、Jonathan Geuter、Chaitanya Dwivedi、Varad Pimpalkhute、Yash Akhauri、Alexander Moreno、Mikhail Yurochkin、Zhenting Wang、Mostafa Elhoushi、Nolan Dey、Shane Bergsma、Joel Hestness、John Thickstun、Eric Xing、Zhengzhong Liuが名を連ねる。
コミュニティでの議論では、Unoの中核フレームワークが4 months earlierに公開されたとリンクされた論文Orthrusに似ているのではないかという疑問が出た。Sahooは、Unoはアーキテクチャとアテンションを変更しない一方、リンク先の論文は拡散アテンションヘッドを追加してアーキテクチャを変え、拡散ブロックに双方向アテンションを使うと回答した。別のコメント投稿者は、両システムが凍結されたTransformerバックボーンを維持し、訓練可能な拡散パラメータを追加し、AR KVキャッシュを再利用し、複数トークンを並列にドラフトし、ロスレス生成のためにAR重みで検証すると主張した。