研究者、動画データ生成パイプライン「VidUEU-Agent」を発表
HuggingFace2026年11月5日 (木)
- •生動画からマルチモーダル理解向けの指示データを合成するVidUEU-Agentを研究者が発表
- •下流の学習・評価結果を反映する4段階の処理でデータ分布を調整
- •VidUEU-100Kは8,268本の動画から10万件を作成、9種類のタスク領域を網羅
研究者らは、生動画からマルチモーダル理解、画像編集、理解と生成を統合するタスク向けの指示データを作る自動パイプライン「VidUEU-Agent」を発表しました。高品質な指示データの不足と、注釈にかかる高い費用への対応を目指すとしています。論文は11月3日に公開され、11月4日にHugging Faceへ提出されました。
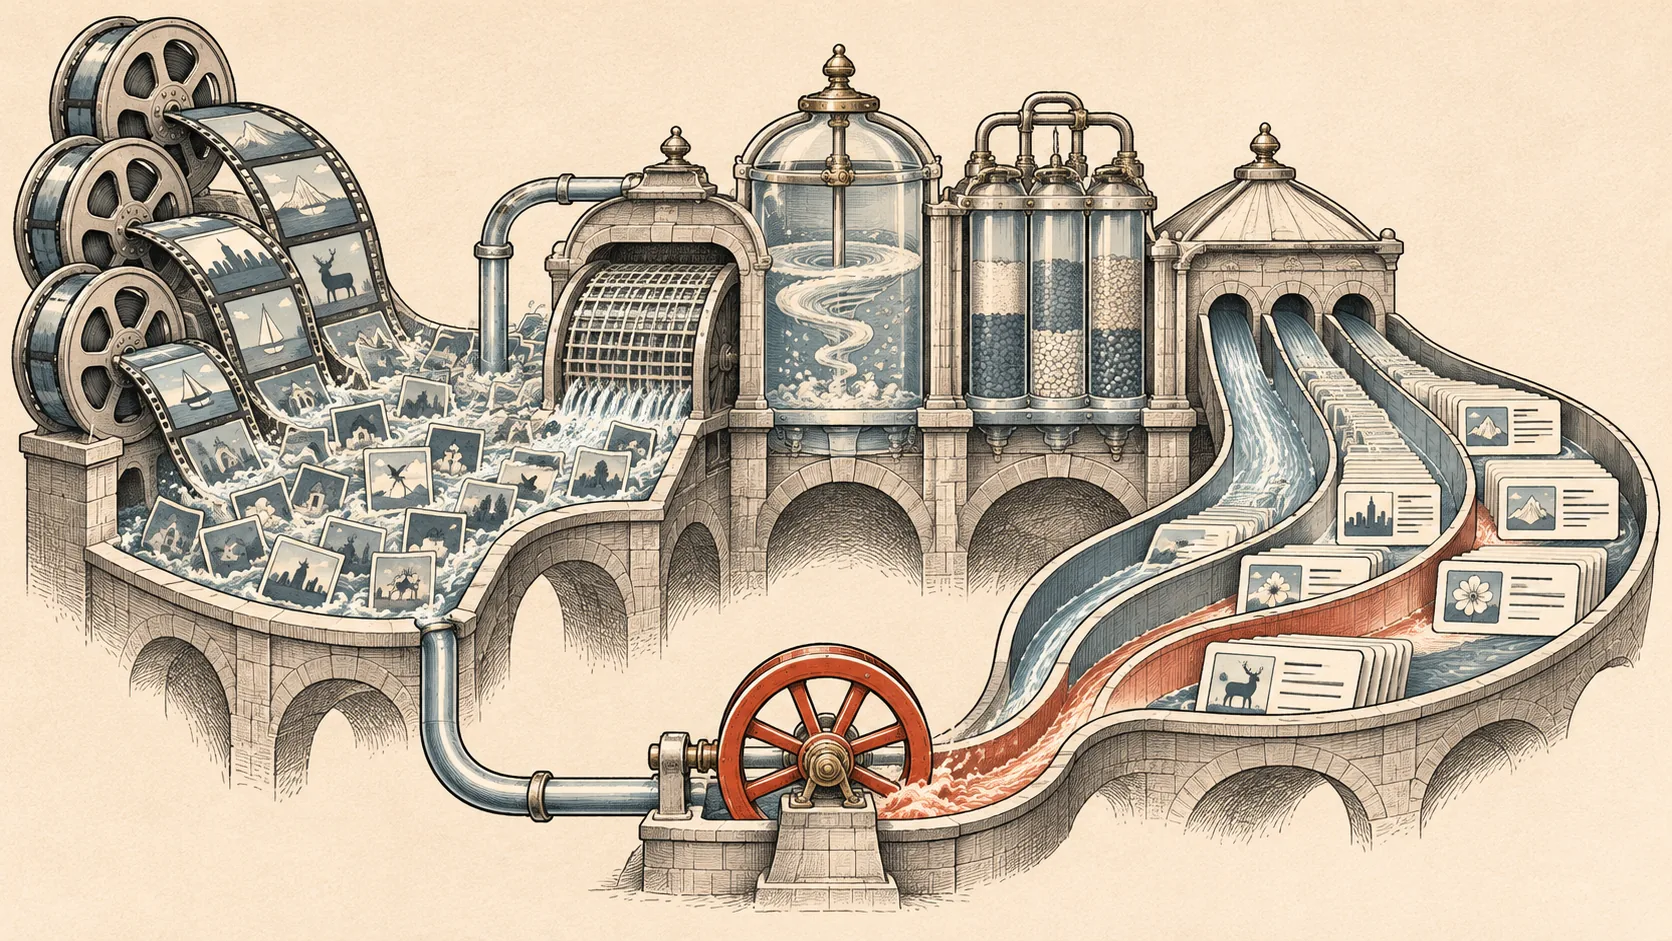
パイプラインは4段階で動画を処理します。まず低品質な映像を除外し、キーフレームとマルチモーダル信号を選び、構造化メタデータを作成したうえで、適したタスクに振り分けて指示データを合成します。視覚と言語を扱うモデルや視覚ツールを使い、品質評価、意味分析、情報検証を行います。合成時には根拠として使った信号を示し、追跡可能性と事実の一貫性が高まると著者らは説明しています。
VidUEU-Agentは、下流の学習と評価の結果を使い、能力・分野・タスク種別ごとのデータ分布も調整します。著者らによると、同じ初期チェックポイントからBAGELを微調整する各回で3万件のサンプルを使い、4回の反復を通じて3つのフィードバック用ベンチマーク全体で改善しました。作成されたデータセット「VidUEU-100K」は8,268本の動画を基に、約2万件の詳細なメタデータ注釈と10万件の指示サンプルを収録しています。内訳は理解向け4万件、編集向け3万件、統合タスク向け3万件で、9種類のタスク領域と5つのシナリオ分類を含みます。著者らは、このデータセットで基準モデルを微調整すると代表的なベンチマークで一貫した向上が得られたとしていますが、個別のスコアは掲載ページにありません。