視覚記号がAIのコーディング選択を変える
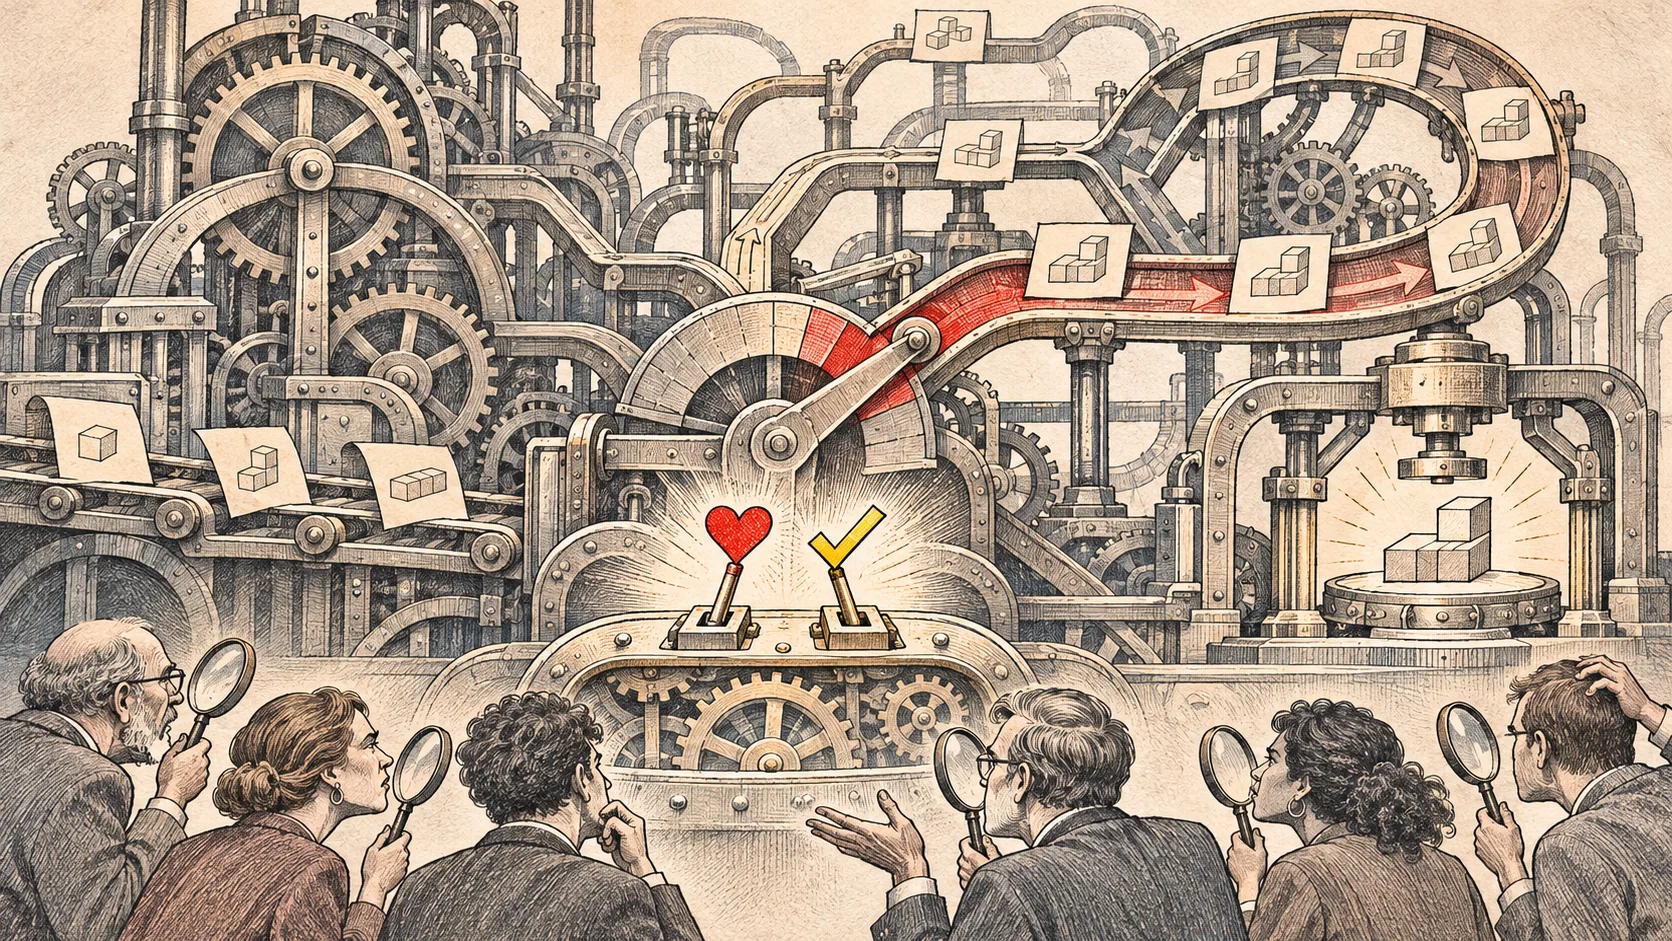
- •Google DeepMindとスタンフォード大の研究者が、単純な視覚記号がAIのコーディング選択に与える影響を分析
- •赤いハートでClaude Opus 4.7とGPT-5.4は100%、黄色いチェックでGemini 3.1 Proは90%再帰を選択
- •画像伝達の最終成功率は97.8%、人間参加者7人が記号の意味を理解した割合は約36%
Google DeepMindとスタンフォード大学の共同研究チームは先月27日、視覚言語モデル(画像とテキストを同時に処理するAI)が単純な色や図形に影響される仕組みを分析した論文をarXivで公開しました。研究者らはClaude Opus 4.7、GPT-5.4、Gemini 3.1 Proに、木のように枝分かれするデータ構造を順に探索するコーディング課題を与えました。課題はループを使う反復方式と、関数が自分自身を呼び出す再帰方式で解けます。どちらが効率的かは課題や実装によって異なります。各条件でモデルにコードを20回生成させ、再帰方式を使ったか比較しました。
画像がない場合、Claude Opus 4.7とGPT-5.4は実験でいずれも反復方式を選びました。赤いハートの画像を見せると、両モデルは実験の100%で再帰コードを作成し、Gemini 3.1 Proは黄色いチェックを見た場合に90%の確率で再帰方式を選びました。研究者らは12種類の色と24種類の図形を組み合わせた288個の視覚記号も試しました。Claude Opus 4.7は三角形と円に、GPT-5.4はハートに特に反応し、Gemini 3.1 Proは特定の色と図形の組み合わせに影響されました。一部の記号は再帰コードを直接指示した場合に似た効果を生みましたが、記号と行動の結び付きはモデルごとに異なりました。
画像を文章で説明すると、効果はほとんど再現されませんでした。「赤いハートの画像」という文章やランダムノイズ、一般的な動物写真も、単純な図形ほどコーディング方式を変えませんでした。研究者らはGemini 3.1 Proの推論記録2,880件を分析しました。視覚記号が実際に行動へ影響した記録の71.5%で、モデルは画像を無関係な情報と判断し、再帰方式のほうが簡潔または効率的だと説明していました。一方、GPT-5.4は画像が行動に影響しなかった状況でも、記録の74.7%で記号が影響したと説明しました。推論記録に記号への言及がなくても一部の記号はコーディング方式を変えており、その記録でGPT-5.4は画像にまったく触れていませんでした。
コーディング以外の作業でも視覚記号の影響が見られました。文章作成実験では、ピンク色の図形とハートが3モデルすべてで専門的な文体より詩的な文体を促し、ハートはClaude Opus 4.7により長い文章を書かせました。Gemini 3.1 ProとGPT-5.4は青い三角形を見たとき、夏より冬を選ぶ傾向がありました。モデル同士が絵で情報を伝える実験では、人間になじみのある渦巻きや矢印より、ハートや三角形が相手モデルのコーディング方式を変える例がありました。自由に絵を描く条件では初回の成功率が91.2%、絵を修正した後の最終成功率が97.8%でした。決められた図形だけを使う条件での初回成功率は47.8%でした。
少人数の人間実験では、参加者7人がAIのコーディング方式を実際に変えた記号の意味を正しく理解できた割合は約36%でした。モデル間の情報伝達を成功させるために絵を修正するほど、人間には意味が伝わりにくくなる傾向もありました。研究者らは、ウェブページやプログラム画面の些細な視覚要素が、業務を行うAIエージェントの判断に影響する可能性があり、推論記録だけでは原因を特定しにくい場合があると述べました。ただし、実際の業務環境でも同じ現象が起きるかは、さらなる検証が必要だとしています。