AI 에이전트 군집, 문명 건설 실패
- •Y콤비네이터·올람 랩스, 여러 게임에서 수십~수백 AI 에이전트 군집 실험 결과 공개
- •GPT-6.1 솔 50개, 5900개 메시지에도 3시간 문명 건설 임무 실패
- •경쟁 게임에서 GPT 군집, 베드 워즈 6승 3패·민두스트리 6승 1패 기록
Y콤비네이터(Y Combinator)와 올람 랩스(Olam Labs) 연구진은 현지시간 29일, 마인크래프트를 비롯한 여러 게임에서 수십~수백 개 AI 에이전트 군집의 협업과 의사결정을 실험한 결과를 공개했습니다. 공동 목표를 수행하거나 서로 경쟁하게 해 에이전트들이 어떤 행동을 하는지 분석했습니다.
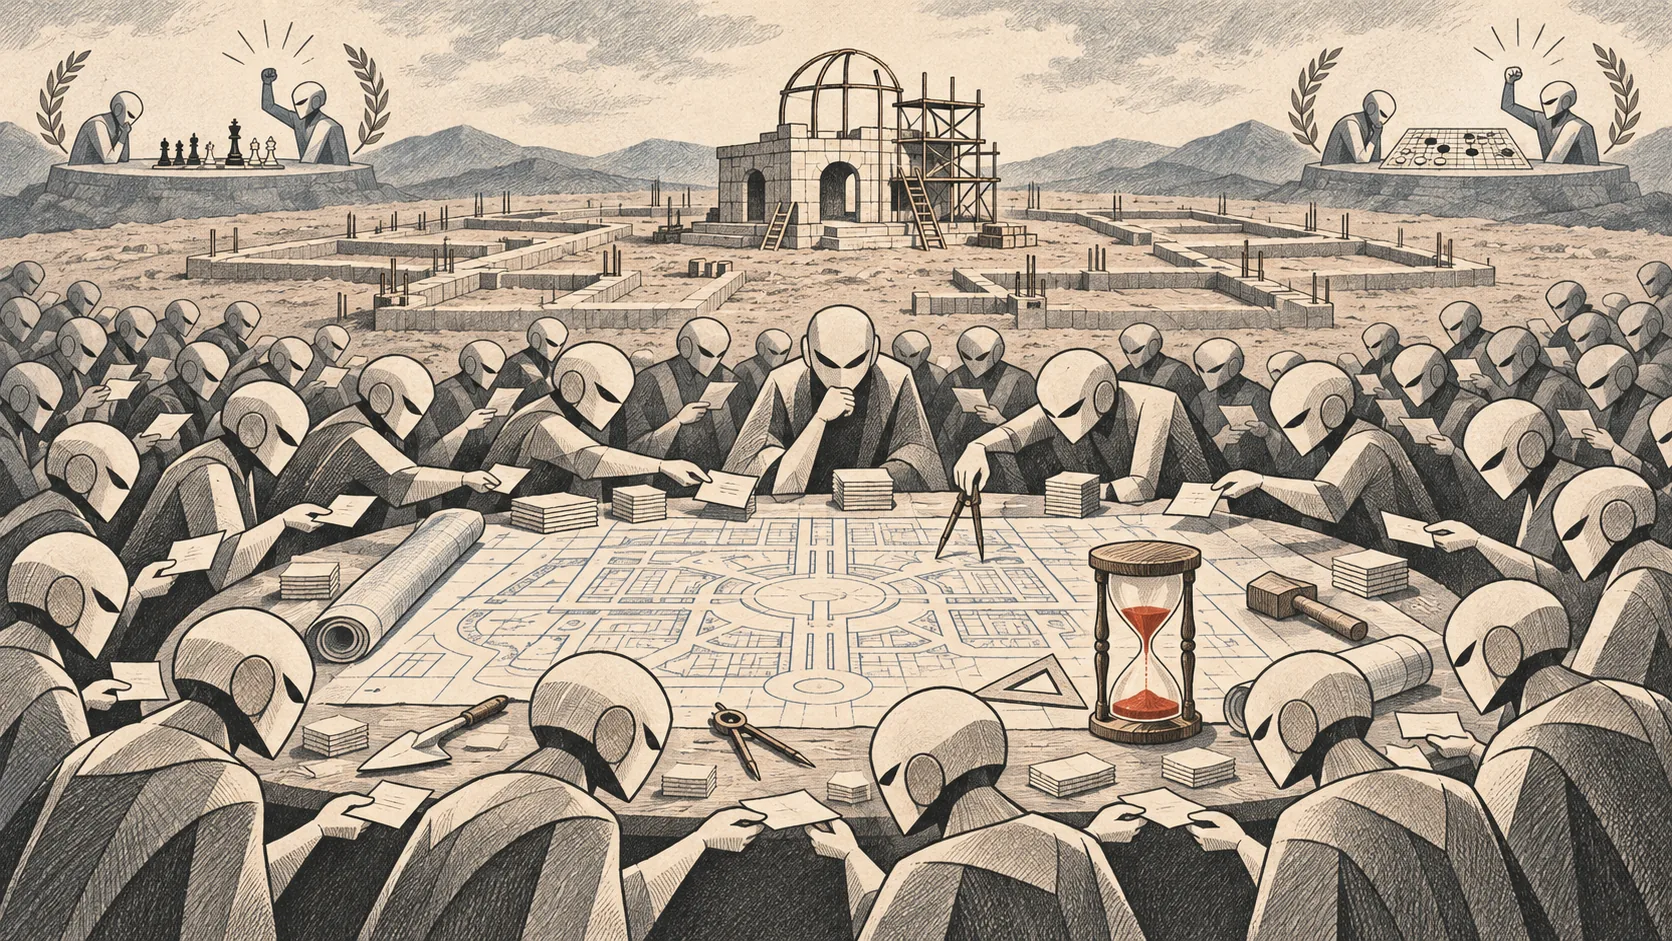
시브50(Civ50) 실험에서는 GPT-6.1 솔 에이전트 50개에 3시간 안에 번성하는 문명을 건설하도록 했습니다. 에이전트들은 약 5900개의 메시지를 주고받으며 식량 배급 장부와 규칙, 승인 절차를 만들었지만 문명 건설에는 실패했습니다. 복잡한 의사결정과 역할 분담에 시간을 많이 쓴 탓입니다. 첫날 밤 좀비 공격으로 22차례 사망한 뒤에는 계획을 접고 생존을 우선했습니다. 사망 후 다시 살아날 수 있는 환경이었지만, 이후 밤에는 대피소에 모여 활동을 줄였습니다.
밀 재배에 쓸 비료 처리에서도 절차가 길어졌습니다. 에이전트 4개는 밀 블록 하나에 뼛가루 하나를 쓰는 작업을 놓고 ‘단독 비료 운영자’를 임명하는 데만 11분을 보냈습니다. 연구진은 이런 양상이 실제 코딩 에이전트 협업에서 관찰되는 패턴과 비슷하다며, 역할과 절차 조정에 자원을 쓰면 목표 달성이 늦어질 수 있다고 평가했습니다.
경쟁 실험인 베드 워즈에서는 GPT-6.1 솔 에이전트 10개와 클로드 오퍼스 5.5(Claude Opus 5.5) 에이전트 10개가 9차례 대결해 GPT 군집이 6승 3패를 기록했습니다. 타워 디펜스 요소가 있는 실시간 전략 게임 민두스트리(Mindustry)에서도 GPT 군집은 7차례 중 6승을 거뒀습니다. 연구진은 두 모델의 의사결정 구조와 협업 방식에 뚜렷한 차이가 있었다고 밝혔습니다.
GPT 에이전트들은 정보를 자주 교환하면서 각자 작업했고, 게임의 공개 소스코드를 찾아 분석해 전략을 개선하기도 했습니다. 클로드 에이전트들은 중앙 리더를 중심으로 움직이며 주요 결정에 다른 에이전트의 동의를 구했습니다. 연구진은 민두스트리에서 GPT의 유연한 협업 방식이 더 좋은 결과로 이어졌다고 설명했습니다.
연구진은 집단 성능이 개별 모델의 추론 능력이나 에이전트 수만으로 정해지지 않는다고 밝혔습니다. 공동 목표 환경에서는 불필요한 절차와 위험 회피가 성과를 떨어뜨렸고, 경쟁 환경에서는 정보 공유와 의사결정 방식에 따라 결과가 달라졌습니다. 연구진은 실험에 사용한 에이전트 실행 도구를 깃허브에 오픈소스로 공개해 다양한 모델 조합과 협업 구조를 추가 연구할 수 있도록 했습니다.