CodeCap-Bench, 영상 코드 캡션 평가 기준 공개
HuggingFace2026년 10월 29일 (목)
- •연구진, 영상에서 실행 가능한 코드 캡션을 생성하는 모델 능력을 평가하는 CodeCap-Bench 공개
- •구조화된 2D 영상 323개를 5개 범주로 나누고 세밀한 주석과 다단계 평가 체계 적용
- •코드 캡션은 추론·영상 재구성에서 자연어보다 높은 성능을 보였고 오픈소스 모델은 상용 모델에 뒤처져
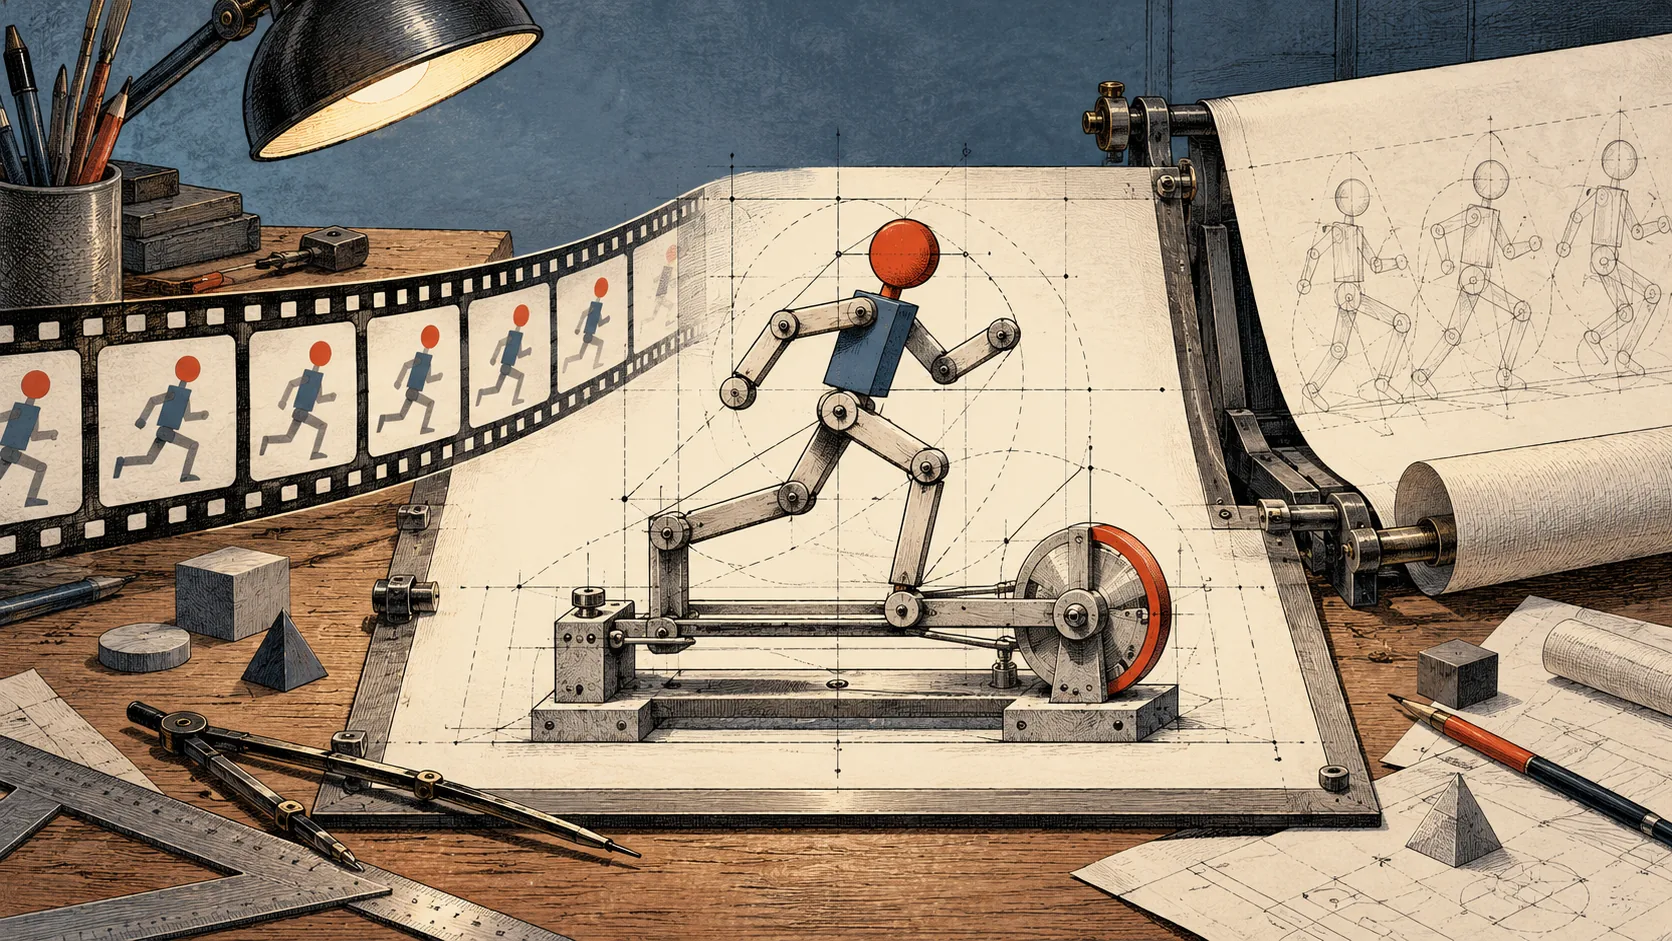
연구진이 멀티모달 대규모 언어 모델이 영상을 실행 가능한 코드 캡션으로 바꾸는 능력을 평가하는 벤치마크인 CodeCap-Bench를 공개했습니다. 논문은 10월 27일 발표됐고 10월 28일 Hugging Face에 제출됐으며, 자연어 설명의 대안으로 코드 캡션을 평가합니다.
연구진은 자연어 캡션이 세밀한 공간 구조와 시간에 따른 변화를 설명할 때 길어지거나 모호해질 수 있다고 설명합니다. 코드 캡션은 그래픽 요소, 배치 규칙, 시간 기반 함수를 사용해 시각 정보를 실행 가능한 프로그램으로 표현합니다.
논문은 후속 질의응답과 영상 재구성 작업에서 코드 캡션과 자연어 캡션을 비교했습니다. 연구진은 코드 캡션이 추론 정확도와 재구성 충실도에서 더 높은 성능을 보였다고 보고했지만, 초록에는 수치 점수가 제시되지 않았습니다.
CodeCap-Bench는 구조화된 2D 콘텐츠를 담은 영상 323개를 5개 범주로 나누고, 세밀한 주석과 다단계 평가 체계를 갖췄습니다. 실험에서 선도적인 상용 멀티모달 모델은 코드 캡션 생성 가능성을 보였지만 복잡한 시간 변화를 충실히 담는 데 여전히 어려움을 겪었습니다. 연구진에 따르면 오픈소스 모델은 상용 시스템보다 상당히 뒤처졌습니다. 이 벤치마크는 모델이 영상 내용을 코드 캡션으로 얼마나 충실하게 표현하는지 평가하도록 설계됐습니다.
논문 저자는 탕자푸, 쉬이판, 탕에릭, 자오쥔제, 뤄스펑, 쑨터, 후하오쉬안, 지이옌, 천신룽, 왕즈하오, 스양, 장위안싱, 완펑페이, 류자헝입니다.