DexAgent, 사람 영상을 로봇 훈련 데이터로 전환
- •스탠퍼드대·컬럼비아대 연구진, 11개 실제 로봇 작업에서 평균 성공률 63.6% 기록
- •사람 영상 하나로 작업당 검증된 로봇 에피소드 500개 생성…4단계 처리와 재사용 기술 활용
- •장난감 서랍 넣기 성공률 80%, 밧줄 매듭짓기 50%…최고 기준선 평균은 18.2%
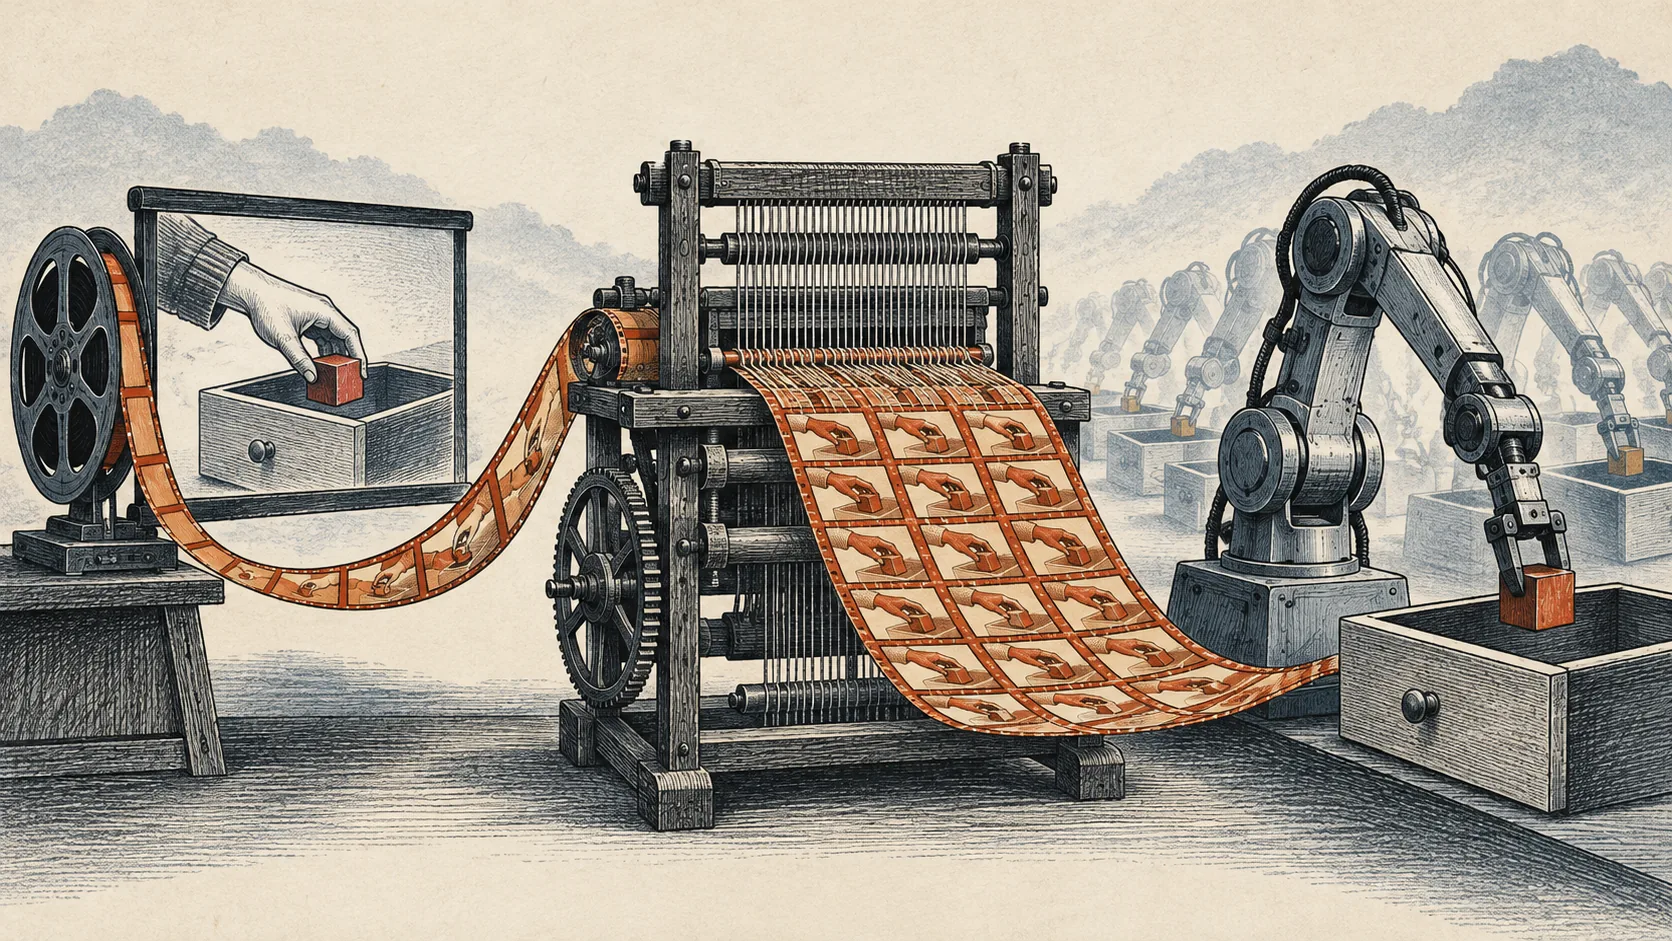
스탠퍼드대와 컬럼비아대 연구진이 사람의 1인칭 시점 영상 한 편과 작업 설명을 로봇 훈련 데이터로 바꾸는 에이전트형 프레임워크 DexAgent를 공개했습니다. 11개 실제 물체 조작 작업에서 DexAgent 데이터로 훈련한 정책의 평균 성공률은 63.6%로, 평가된 기준선 가운데 가장 높은 SPIDER의 18.2%, V2D의 17.3%를 웃돌았습니다. 이는 최고 기준선의 약 3.5배입니다. 실험에는 배터리 끼우기, 가위로 자르기, 밧줄 매듭짓기, 컴퓨터 설치가 포함됐으며, 단단한 물체와 관절형·변형 가능한 물체, 도구 사용과 긴 동작 순서를 다뤘습니다. 각 정책은 작업마다 물체 위치를 무작위로 바꿔 10회 시험했습니다. 장난감을 서랍에 넣는 작업의 성공률은 80%, 밧줄 매듭짓기는 50%였습니다. 연구진은 방법별 비교에서 동일한 정책 모델과 데이터 증강·시각 처리 절차를 사용했습니다.
DexAgent는 시연 영상을 네 단계로 처리합니다. 먼저 물체와 특성, 작업의 하위 목표를 파악하고, 시뮬레이션에 물체를 재구성한 뒤 로봇 동작을 만들고 검증해 다양한 훈련 에피소드를 생성합니다. 병뚜껑 열기 작업에서는 뚜껑의 회전과 위쪽 이동, 병을 고정하는 다른 손의 역할을 표현합니다. 시뮬레이션 검사는 뚜껑을 돌렸을 때 실제로 위로 움직이는지처럼 물체가 필요한 물리적 특성을 갖췄는지 확인합니다. 적절한 재구성 도구가 없으면 에이전트가 도구를 작성할 수 있으며, 검사를 통과할 때까지 시뮬레이션 물체를 다듬습니다. 새 기능은 매개변수가 다른 추가 버전 3개에서 시험한 뒤 재사용 라이브러리에 넣습니다.
로봇 동작 생성에서는 사람의 자세를 참고하고, 손가락 위치를 최적화해 필요한 접촉을 재현한 뒤 시뮬레이션 상호작용에서 후보 손잡기를 시험합니다. 검증한 자세를 동작 궤적으로 연결하며, 앞선 동작 때문에 다음 단계가 막히면 이전 동작을 수정할 수 있습니다. 이어 물체와 로봇의 초기 상태를 다양하게 바꾸고 궤적을 조정해 실행 가능성을 확인합니다. 정책 실험에서는 작업마다 검증된 로봇 에피소드 500개를 생성했습니다. 로봇 시점 이미지를 만들 때는 궤적에 따라 시뮬레이션 속 로봇과 물체를 렌더링하고, 원본 영상에서 시연자의 손과 조작 물체를 지운 뒤 렌더링 이미지를 빈 장면에 합성하고 재질과 외관을 다듬습니다. 생성된 에피소드는 사전 훈련된 π0.5 정책을 미세 조정하는 데 사용됩니다.
재사용 라이브러리에는 기술 103개와 검증기 188개가 들어 있습니다. 별도의 EgoDex 영상 100개 처리 실험에서 기술 재사용으로 영상당 변환 시간은 첫 영상의 4.3시간에서 2.2시간으로 줄었고, 물체 자산까지 재사용할 수 있을 때는 13.1분으로 감소했습니다. 전체 실행에서 영상당 평균 시간은 2.1시간이었습니다. 이 실험에서 축적한 기술은 85개, 검증기는 168개로 더 큰 라이브러리의 일부였습니다. 연구진은 시뮬레이션 검사만으로 현실 세계의 성공을 보장할 수 없다고 밝혔습니다. DexAgent가 시연을 잘못 이해하거나 물체를 부정확하게 재구성하고, 오류를 발견하지 못해 라이브러리에 반영할 가능성이 있습니다. 힘에 민감한 상호작용은 특히 어렵고, 연구진은 검증 강화와 시뮬레이션·현실 간 격차 축소를 향후 과제로 꼽았습니다. 사용 가능한 기술로 타당한 해법을 만들지 못할 때 강화학습을 적용하는 방안도 살펴볼 계획입니다.