응급의료 AI 공정성 평가 틀 제안
Semantic Scholar2026년 10월 19일 (월)
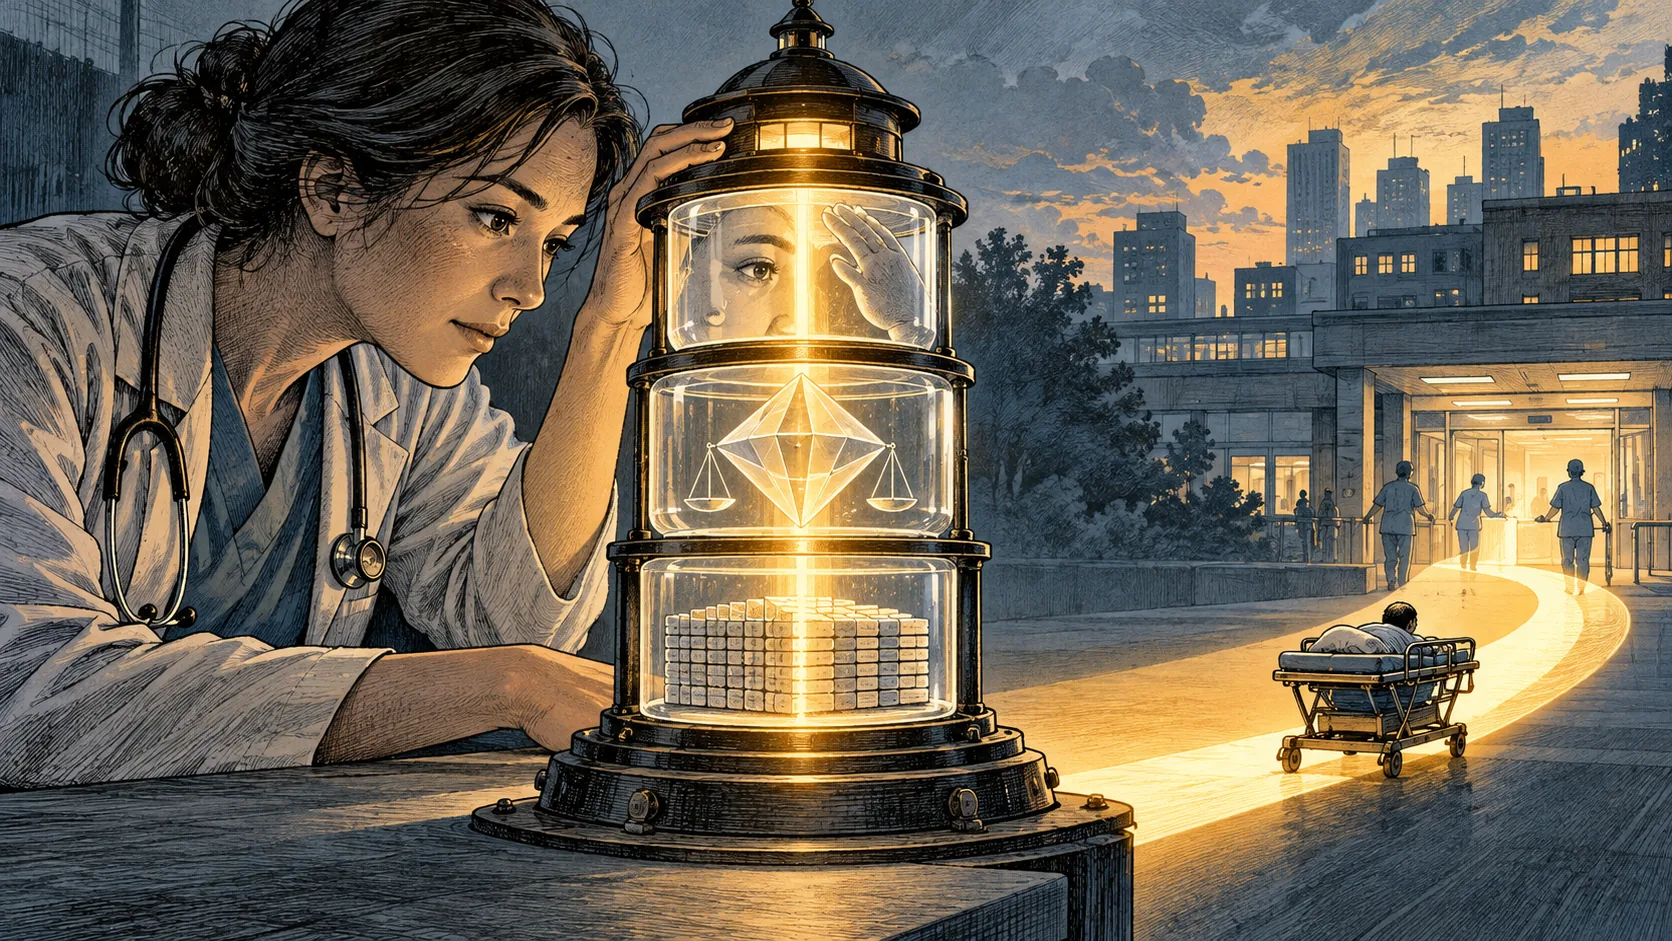
- •임상응급의학 리뷰, 응급의료 AI와 대규모 언어 모델의 공정성 평가 틀 제시
- •위험을 데이터·출력·인간 상호작용의 세 층위로 구분
- •임상의에게 정확도와 함께 안전성·투명성·공정성 검토 촉구
『임상 및 실험 응급의학』에 실린 2026년 서술형 리뷰가 응급의료 분야 인공지능, 특히 대규모 언어 모델(LLM)의 공정성을 평가하는 실용적 틀을 제시했습니다. 리뷰는 공정성이 환자 집단별로 동등한 성능을 내는 것뿐 아니라, 의료 혜택과 배분의 형평성, AI 도입 전 과정의 절차적 공정성까지 포함한다고 설명합니다.
리뷰는 위험을 세 층위로 나눕니다. 데이터 단계의 공정성은 학습·미세조정·프롬프트 데이터와 관련되며, 편향된 임상 기록, 무작위가 아닌 결측, 낙인성 문서화가 모델 성능에 영향을 줄 수 있습니다. 출력 단계에서는 AI가 생성한 권고·예측·번역·지침이 환자 집단마다 정확하고 안전하며 유용한지 살핍니다. 전체 성능이 양호해 보여도 데이터 통합, 학습 또는 평가의 편향으로 하위 집단에서 오류가 생길 수 있습니다.
인간 상호작용 단계의 공정성은 실제 진료에서 임상의와 환자가 혜택을 함께 누리는지에 관한 것입니다. 임상의가 권고를 지나치게 따르거나 유용한 권고를 거부할 때, 또는 환자가 AI를 통한 정보를 이용하거나 이해하거나 신뢰하기 어려울 때 불평등이 생길 수 있습니다. 리뷰는 임상의가 응급의료 AI 도구를 평가할 때 전반적인 정확도와 함께 안전성, 투명성, 공정성을 고려해야 한다고 밝혔습니다.