생성형 AI 학습 데이터에 법적 한계 제안한 연구
Semantic Scholar2026년 11월 9일 (월)
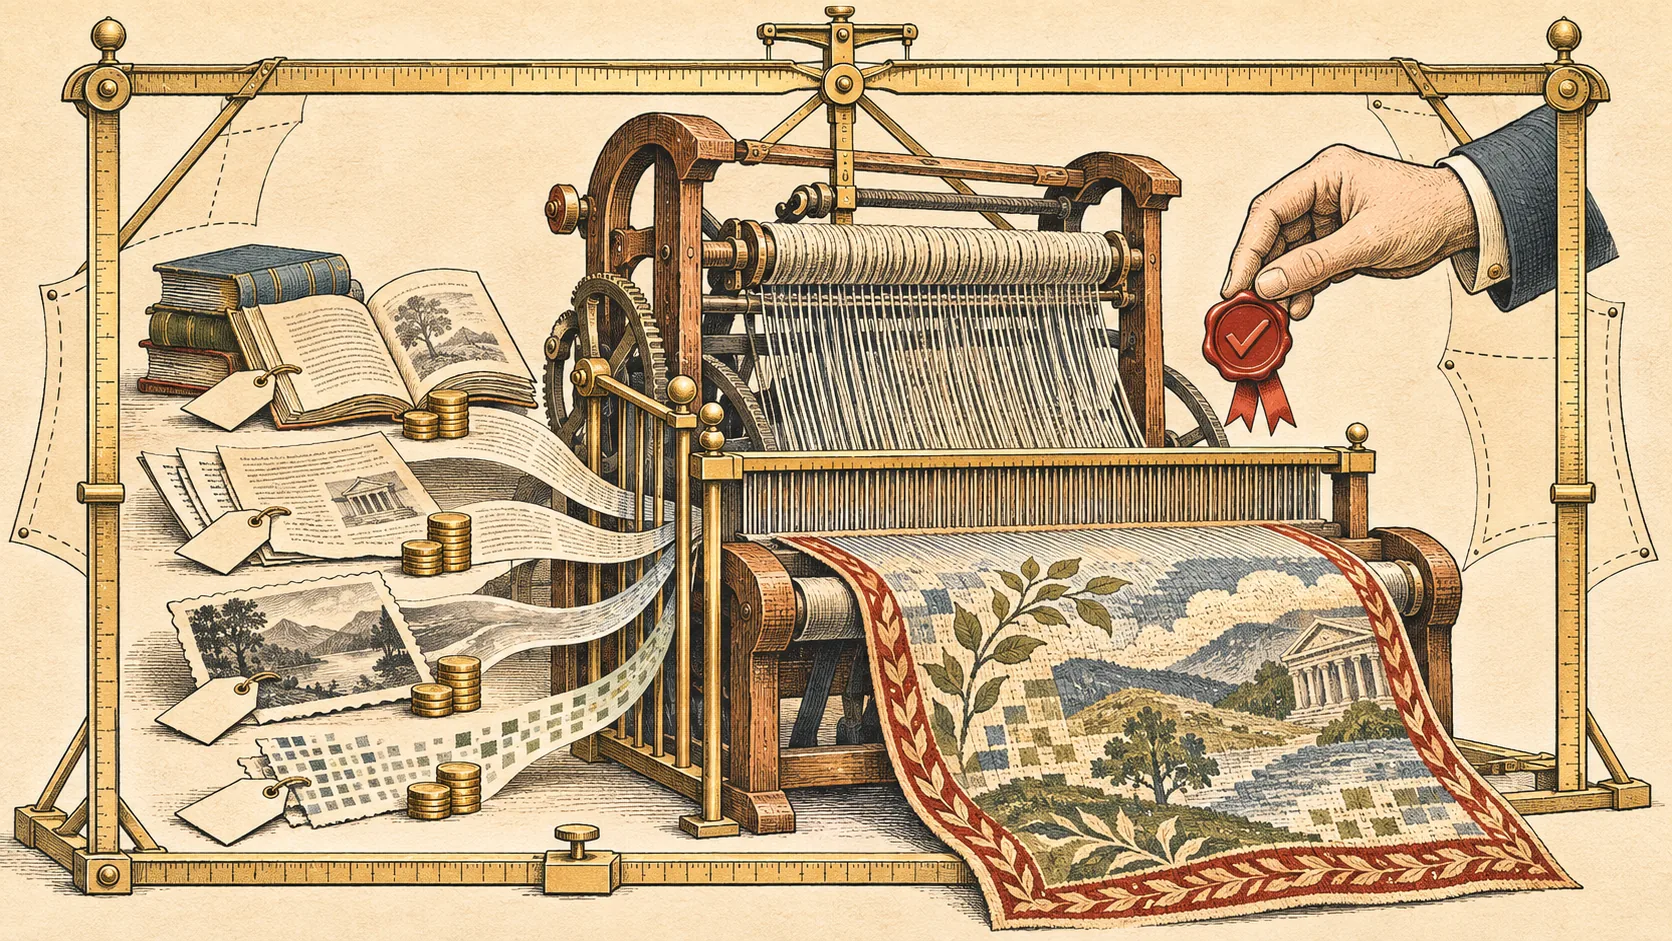
- •연구진, 생성형 AI 학습 데이터의 법적 위험을 분석하고 개인정보·지식재산권 보호를 위한 국가 체계 제안
- •인도네시아·한국·유럽연합·일본 법률 검토와 대규모 언어 모델 프롬프트 시험 진행
- •명시적 허가·공정한 보상·데이터 출처 추적과 사람의 감독·이용자 동의 권고
갈리흐 드위 라마단(Galih Dwi Ramadhan), D. S. 우토모(D. S. Utomo), 박지현 연구진은 생성형 AI 대규모 언어 모델(LLM)의 학습 데이터에 얽힌 법적·윤리적 위험을 분석한 연구를 《인도네시아 법 발전 저널》 2026년 호에 발표했습니다. 연구는 학습 데이터와 지식재산권, 개인정보 보호의 관계를 살피고, 두 권리를 보호할 규제 지침과 국가 체계를 마련하는 데 목적을 뒀습니다.
연구진은 인도네시아, 한국, 유럽연합, 일본의 법률과 법 개념을 검토하는 규범적 법률 연구를 수행하고, 대규모 언어 모델에 프롬프트를 직접 시험했습니다. 연구 결과, 모델이 추가 학습을 위해 이용자의 프롬프트와 데이터, 수정 내용을 계속 흡수하는 과정에서 개인정보 보호법상 보안 취약성이 생길 수 있다고 분석했습니다. 사람의 창작 통제가 충분하지 않고 결과를 예측하기 어려우면 들어오는 데이터 각각이 개인정보 보호 또는 저작권법을 위반하고 창작자에게 피해를 줄 가능성이 있다고 밝혔습니다.
연구진은 명시적 이용 허가와 공정한 보상, 데이터 출처 추적 표시 같은 기술 검증 기준을 권고했습니다. 사람 중심의 감독, 명시적인 이용자 동의, 선택의 자유도 법적 한계의 핵심으로 꼽았습니다. 공동 책임 모델에 따라 소프트웨어 엔지니어는 기술 투명성, 전문가 감독, 신속히 대응하는 민원 절차를 마련해야 합니다. 이용자는 플랫폼을 합법적으로 선택하고, 결과물의 이용 허가 조건을 따르며, 시스템을 적극적으로 살펴야 한다고 제안했습니다.