AI 비교AI 찾기AI 뉴스AI 활용
회사 소개
개인정보처리방침이용약관FAQ문의하기문의하기
에이아이비 주식회사사업자정보
© 2026 AIB Inc.

화자 분리와 소음 억제를 한 번에

화자 분리와 소음 억제를 한 번에

Nature·2026년 10월 9일 (금)
  • •공유 오디오 표현을 활용해 겹치는 화자와 변화하는 배경 소음을 함께 처리하는 신경망 개발
  • •3,000개 혼합 음원에서 0 dB 기준 SI-SNR 개선 15.60 ± 0.10 dB, PESQ 3.02, STOI 0.917 기록
  • •TF-GridNet·MossFormer2보다 연산량은 7~11배 적지만 점수는 0.50~0.80 dB 낮은 결과
  • •공유 오디오 표현을 활용해 겹치는 화자와 변화하는 배경 소음을 함께 처리하는 신경망 개발
  • •3,000개 혼합 음원에서 0 dB 기준 SI-SNR 개선 15.60 ± 0.10 dB, PESQ 3.02, STOI 0.917 기록
  • •TF-GridNet·MossFormer2보다 연산량은 7~11배 적지만 점수는 0.50~0.80 dB 낮은 결과
  • •공유 오디오 표현을 활용해 겹치는 화자와 변화하는 배경 소음을 함께 처리하는 신경망 개발
  • •3,000개 혼합 음원에서 0 dB 기준 SI-SNR 개선 15.60 ± 0.10 dB, PESQ 3.02, STOI 0.917 기록
  • •TF-GridNet·MossFormer2보다 연산량은 7~11배 적지만 점수는 0.50~0.80 dB 낮은 결과
  • •공유 오디오 표현을 활용해 겹치는 화자와 변화하는 배경 소음을 함께 처리하는 신경망 개발
  • •3,000개 혼합 음원에서 0 dB 기준 SI-SNR 개선 15.60 ± 0.10 dB, PESQ 3.02, STOI 0.917 기록
  • •TF-GridNet·MossFormer2보다 연산량은 7~11배 적지만 점수는 0.50~0.80 dB 낮은 결과

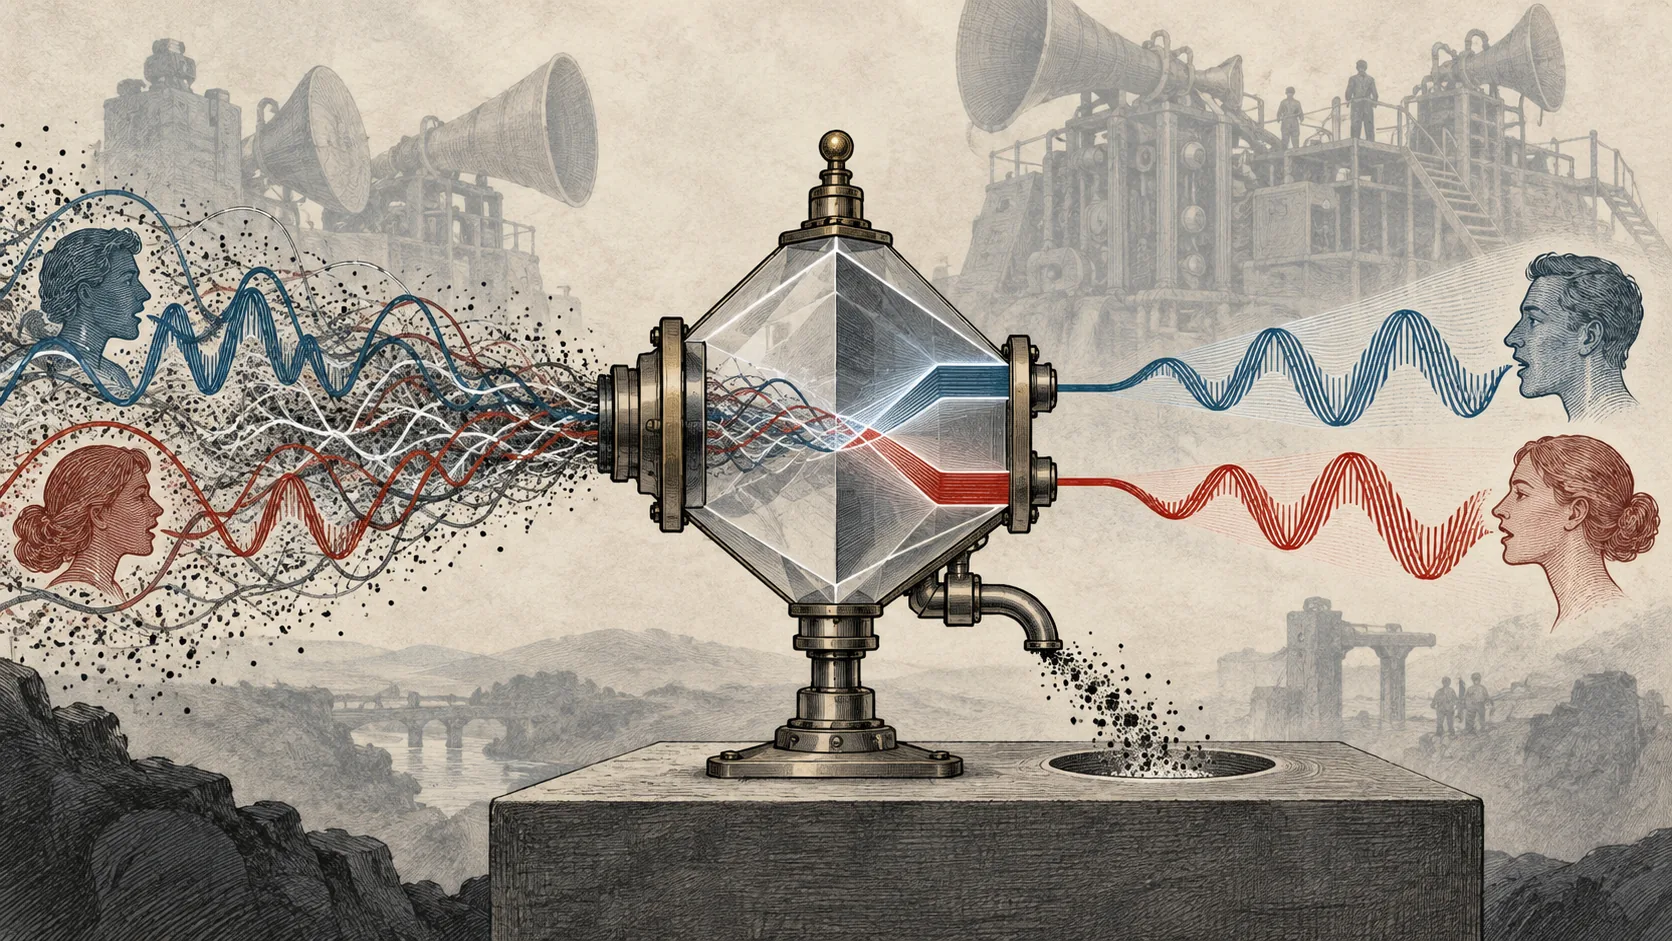
후난정보기술대학교 연구진이 겹쳐 말하는 화자를 분리하고 변화하는 배경 소음을 억제하는 딥러닝 네트워크를 개발했습니다. 시스템은 하나의 공유 오디오 표현에서 두 작업을 수행하며, 학습 가능한 인코더와 다중 스케일 분리기, 각 분리 음원에 적용하는 소음 억제 모듈, 재구성기로 구성됩니다. 채널 및 시간-주파수 어텐션을 활용하고, 신호 대 잡음비·스펙트럼 크기·지각 가중치를 결합한 세 부분 목표로 종단 간 학습했습니다. 학습 입력에는 신호 대 잡음비가 −5 dB인 오디오도 포함됐습니다.

연구진은 음원 분리에 LibriMix, WHAM!, WHAMR!를, 소음 억제에 VoiceBank-DEMAND와 MUSAN을 사용했고, 음성 이외의 전 대역 오디오는 MUSDB18-HQ로 확인했습니다. 3,000개 혼합 음원과 무작위 시드 3개를 사용하고 동일한 학습 방식으로 재학습한 기준 모델 7개와 비교한 결과, 입력 신호 대 잡음비 0 dB에서 신호 대 잡음비 개선값 15.60 ± 0.10 dB, PESQ 점수 3.02, STOI 점수 0.917을 기록했습니다. 모델은 매개변수 390만 개를 사용했으며 Conv-TasNet, DPRNN, SepFormer, 확산 기반 연속 처리 방식, 분리 후 잡음을 제거하는 처리 파이프라인보다 높은 성능을 보였습니다.

TF-GridNet과 MossFormer2는 점수가 0.50~0.80 dB 높았지만 연산량은 7~11배 많았습니다. 제안된 시스템은 오디오 1초당 곱셈-누산 연산 6.8 G를 사용했고, CPU 코어 1개에서 실시간 계수 0.51을 기록했으며 처리한 오디오 1초당 에너지 0.41 J를 소비했습니다. 스트리밍용 인과 모델은 성능이 1.70 dB 낮아졌습니다. 구성 요소 제거 실험에서는 두 어텐션 경로가 각각 4.50%, 7.10%, 공동 잡음 제거 경로가 10.30%를 기여한 것으로 나타났습니다. 다른 말뭉치, 학습에 없던 언어, 잔향 조건을 적용한 시험에서 성능 손실은 0.70~2.20 dB였고, 잔향 시간이 0.90초를 넘으면 개선값은 7.80 dB로 낮아졌습니다. 연구와 함께 코드, 설정 파일, 발화별 기록도 공개됐습니다.

원문 보기 (영어)·2026년 10월 8일
#blind source separation#speech enhancement#noise suppression#audio separation#attention mechanism#si snr#pesq#stoi