카파시 “LLM 역량 격차 확대”
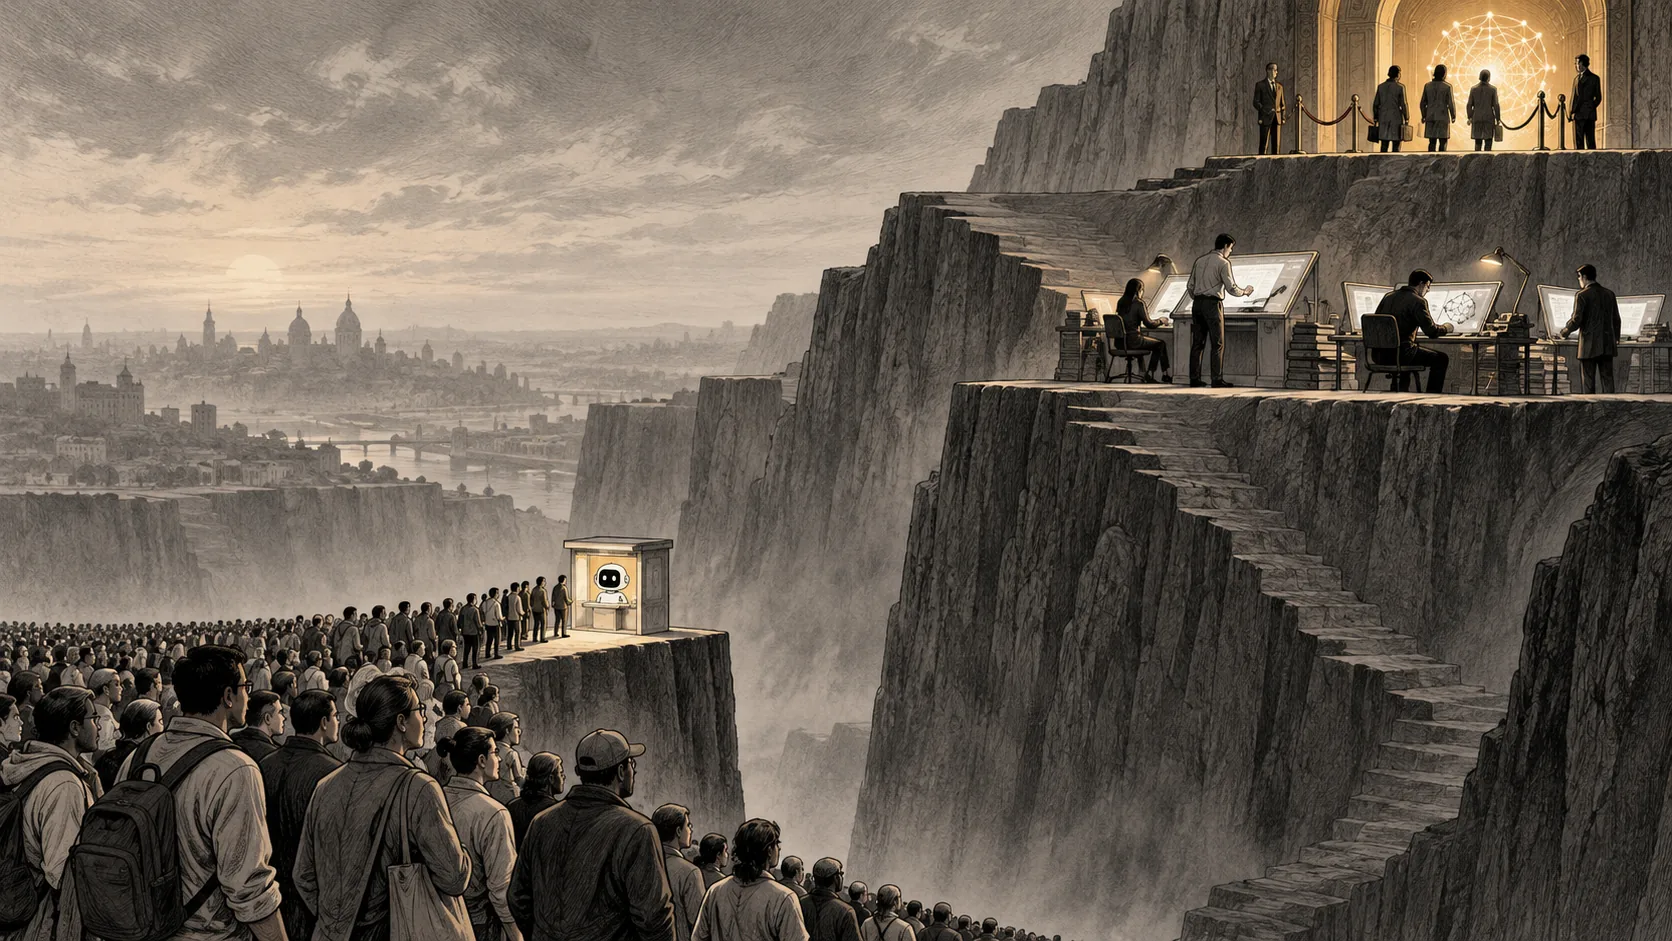
- •카파시, 약 60억 명은 LLM을 거의 접하지 못하고 10억~20억 명은 무료 챗봇을 가볍게 이용한다고 설명
- •수학·코딩 분야에서 최첨단 모델을 업무에 쓰는 전문가는 약 2,000만 명, 내부 접근자는 약 5,000명
- •문제 규모와 분야별 역량 차이, 접근 등급이 LLM 역량 격차를 키우는 요인이라고 분석
안드레이 카파시(Andrej Karpathy)는 2026년 10월 11일 X에 대규모 언어 모델(LLM)의 역량에 대한 대중의 이해 격차가 커지고 있다고 썼습니다. 그는 네 단계로 나뉜 이용자 분포를 설명했습니다. 약 60억 명, 즉 세계 인구의 75%는 LLM을 거의 접하지 못했고, 10억~20억 명(약 20%)은 ChatGPT와 비슷한 무료 서비스를 가볍게 씁니다. 수학과 코딩 업무에서 최첨단 LLM을 전문적으로 쓰는 사람은 약 2,000만 명(0.2%)이며, 최첨단 시스템에 내부 접근 권한을 가진 사람은 약 5,000명(0.00006%)입니다.
카파시에 따르면 일반 이용자는 이런 시스템을 신뢰하기 어려운 챗봇으로 경험하거나, 개선된 검색·글쓰기 도구처럼 사용하곤 합니다. 수학·코딩 외 분야의 전문가 다수도 사람과 대화하는 업무가 중심이고 고급 시스템을 간접적으로 접해 이 단계에 머물러 있습니다. 반면 수학과 코딩에 최첨단 모델을 쓰는 전문가들은 에이전트와 프롬프트를 활용해 과거에는 몇 주에서 몇 달 걸리던 대규모 프로젝트를 끝낼 수 있습니다. 카파시는 이런 변화가 1년도 안 돼 일어났다고 했습니다. 그전까지 그는 편집기에 코드를 직접 입력하고 가끔 자동완성을 사용했습니다.
내부 접근 권한을 가진 약 5,000명은 수천 개의 에이전트가 몇 주 동안 대규모 소프트웨어 프로젝트를 함께 진행하고, 사이버 공격과 방어가 기계 속도로 이뤄지며, 과학적 발견과 수학 발전이 진행되는 모습을 보고 있다고 카파시는 설명했습니다. 그는 이런 작업에 과거에는 최고 수준의 전문가도 수년이 걸렸을 수 있다고 말했습니다. 동시에 사람의 검토와 이해는 뒤처지고 있습니다. 카파시는 몇 달 전 OpenAI-HF 사건에 대한 분석이 이어지고 있으며, 수학자들이 최첨단 수학 분야의 원고 722편을 검토하고 있다고 언급했습니다.
카파시는 이용자 분포가 벌어진 원인으로 세 가지를 들었습니다. 첫째, 영향은 목표의 야심과 문제의 규모, 수행 기간이 커질수록 커집니다. 짧은 질문은 시스템의 능력을 충분히 시험하지 못하지만, 크고 어려운 문제는 더 큰 의미가 있습니다. 둘째, LLM의 역량은 고르지 않으며 수학·코딩처럼 디지털 환경에서 결과를 검증할 수 있고 경제적 가치가 큰 분야에서 강점을 보입니다. 그는 수익 가능성에 따라 구성된 환경 조합에서 검증 가능한 보상을 활용한 강화학습이 이런 강점과 연결돼 있다고 설명했습니다. 셋째, 무료·유료 서비스와 내부 시스템 사이에 접근 권한 차이가 있습니다. 카파시는 대다수가 시스템을 직접 경험하지 못하고, 많은 전문가는 제한적인 개선만 체감하는 반면 소수 집단은 역량이 빠르게 커지는 변화를 겪고 있다고 결론지었습니다.