Kling 보고서, 영상 이해·제어 기술 분석
- •Kling Team, 세대별 Kling 영상 시스템의 의미 제어에 관한 기술 보고서 공개
- •Kling-MLLM, 이미지·영상·오디오 입력을 통합해 후속 작업에 활용
- •보고서, 촘촘한 캡션·프롬프트 개선·보상 모델·과업별 평가 검토
Kling Team이 11월 3일 공개한 기술 보고서는 여러 세대의 Kling 영상 시스템에서 얻은 경험을 공유하고, 의미 제어가 영상 생성의 주요 병목으로 부상하고 있다고 주장합니다. 저자들은 생성 품질이 렌더링만으로 결정되는 것이 아니라 데이터, 조건 설정, 정렬, 평가로 이어지는 전체 과정에 좌우된다고 설명합니다.
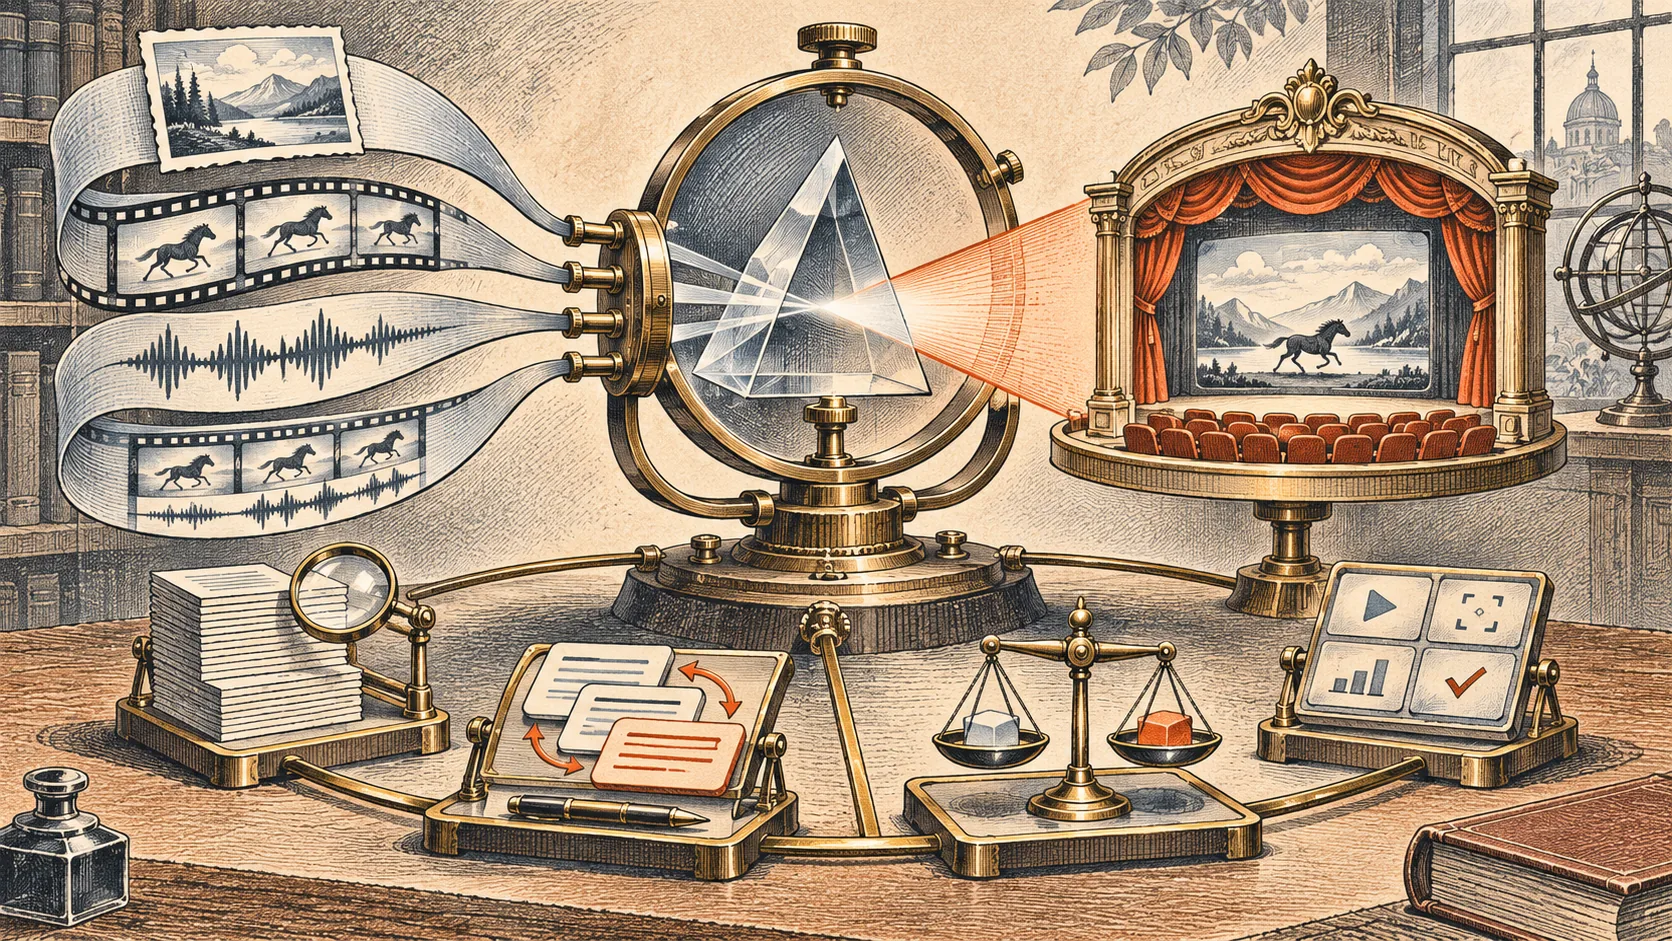
보고서는 여러 양식의 입력을 통합하는 공통 기반 모델 Kling-MLLM을 중심으로 삼습니다. 이 모델은 이미지, 영상, 오디오, 동기화된 오디오·영상, 교차 배열 입력을 처리한 뒤 후속 작업에 맞게 특화됩니다. DiT는 언어 모델보다 훨씬 적은 사례로 학습되므로, 팀은 캡션을 의미 전달의 약속으로 보고 많은 정보를 담아야 한다고 말합니다. 참조 기반 캡션 작성은 설명과 시각 자료 사이의 연결을 명시합니다.
사용자 의도를 생성에 바로 쓸 수 있는 설명으로 바꾸는 프롬프트 개선에는 인상적인 영상의 캡션에서 도출한 기본 방법을 적용합니다. 이후 텍스트 수준 강화학습과 생성기를 학습 과정에 포함하는 강화학습으로 이를 다듬습니다. 에이전트 방식은 이야기 구성을 추가로 개선하고 인상적인 사례를 검색합니다. 보고서는 신뢰할 수 있는 텍스트 인코더에 더 강한 언어 능력보다 지각 학습이 중요하다고 말하며, 최종 학습에 앞서 텍스트만으로 후보를 선별할 수 있다고 설명합니다.
팀은 설명 가능하고 특정 부분을 짚는 비평을 제공하는 일반 보상 모델과 여러 차원을 빠르게 채점하는 의사결정 보상 모델을 함께 사용하며, 지각 대역폭을 핵심 설계 변수로 봅니다. 또한 점수 산정의 지름길을 드러내고 실패가 파이프라인의 앞선 어느 단계에서 시작됐는지 추적하도록 설계된 과업별 자동 평가 절차를 검토합니다. 저자들은 이 관찰을 제어 가능한 영상 생성에 필요한 다중 양식 이해 체계를 구축하기 위한 실무 지침으로 제시합니다.