LLM 보안 흔드는 언어적 불투명성
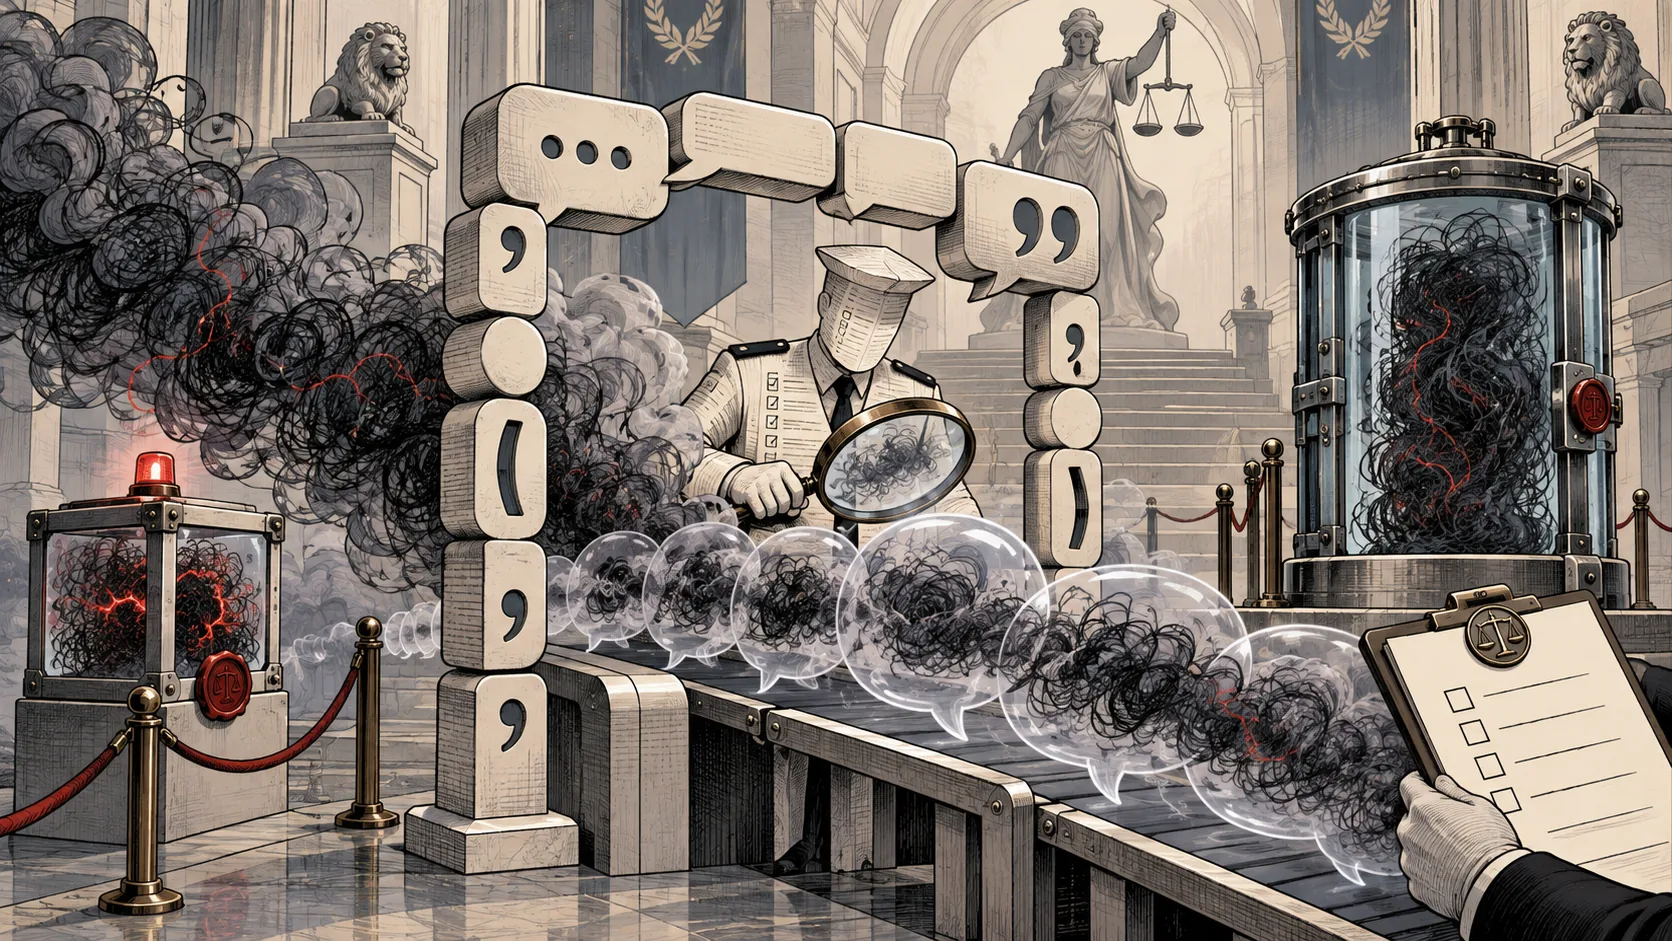
- •제임스 미켄스는 언어적 불투명성이 언어 기반 LLM 보안 메커니즘을 제한한다고 주장했다
- •논문은 사고 과정 모니터링과 헌법적 자기비판이 완전히 건전할 수 없다고 밝혔다
- •오염 추적, 견고한 가상화, 제3자 감사가 샌드박스 보호 장치로 제안됐다
제임스 미켄스(James Mickens)는 2026년 9월 2일 arXiv에 "The Implications of Linguistic Illegibility for LLM Security"라는 논문을 제출하며, 언어 기반 모니터링만으로는 대규모 언어 모델을 완전히 보호할 수 없다고 주장했다. 논문은 "언어적 불투명성"을 LLM의 가시적 텍스트 출력이나 언어처럼 보이는 내부 신호가 모델이 실제로 답을 계산하는 방식을 제대로 나타내지 못하는 경우로 정의했다. arXiv 기록은 이 연구를 Machine Learning (cs.LG)과 Cryptography and Security (cs.CR) 분야로 분류했으며, arXiv ID는 2609.02852, 버전은 v1, 제출 시각은 17:37:22 UTC였다.
미켄스는 LLM이 내부 작업을 직접 언어로 수행하지 않기 때문에 문제가 생긴다고 봤다. 초록에 따르면 내부 계산은 활성화 공간(모델 내부의 숫자 표현)에서 수학적으로 일어나며, 자연어는 입력과 출력 양끝에서 손실이 있는 번역을 거쳐 나타난다. 이에 따라 LLM의 외부화된 언어 출력과 기계적으로 추출된 언어적 특징은 모델 내부 작동을 이해하는 데 신뢰하기 어려운 렌즈가 될 수 있다고 논문은 밝혔다.
논문은 이런 특성이 모델의 언어적 자기보고에 의존하는 보안 기법의 한계를 만든다고 설명했다. 미켄스는 사고 과정 모니터링, 헌법적 자기비판, 언어적으로 정의된 특징 벡터에 대한 활성화 탐침을 예로 들며, 언어적 불투명성이 항상 가능하다면 이런 메커니즘은 "완전히 건전할 수 없다"고 주장했다. 또한 모델 샌드박스에는 모델의 언어 상태를 읽는 데 의존하지 않는 격리 기법이 필요하다고 봤다.
미켄스는 오염 추적(데이터 흐름을 통제하려고 표시하는 기법)을 유망한 샌드박스 접근법으로 제시했다. 논문은 오염 추적 정책이 모델이 자기 행동을 어떻게 설명하든 관계없이, 모델 생성 데이터의 영향을 받아서는 안 되는 시스템 상태 조각을 사전에 정의할 수 있다고 설명했다. 초록은 또한 견고한 가상화와 샌드박스 설정에 대한 제3자 감사를 언어적 모니터링 아래 보안 기반을 제공하는 추가 메커니즘으로 지목했으며, 이런 메커니즘이 프런티어 모델의 최근 샌드박스 익스플로잇을 완화했을 것이라고 밝혔다. 해당 논문으로 연결된 Hacker News 스레드는 점수 42와 댓글 17개를 기록했다.