NVIDIA 연구진, 로봇 학습 프레임워크 ThinkWorld 공개
HuggingFace2026년 10월 29일 (목)
- •NVIDIA 연구진, 사람 영상과 로봇 시연에서 동작을 학습하는 ThinkWorld 발표
- •ThinkWorld, 현재와 미래 상태를 잇는 이산 동작 토큰열로 로봇 행동 표현
- •시뮬레이션과 실제 로봇 실험에서 사람 동작의 로봇 전이와 미관측 환경 일반화 확인
NVIDIA 연구진이 로봇이 학습한 기술을 새 과제와 환경으로 옮기도록 돕는 시각·언어·행동(VLA) 학습 프레임워크 ThinkWorld를 발표했습니다. 논문은 10월 27일 공개됐고 10월 28일 Hugging Face에 제출됐습니다. 연구진은 행동 라벨이 없는 사람 영상과 로봇 시연을 함께 활용해 학습한다고 밝혔습니다.
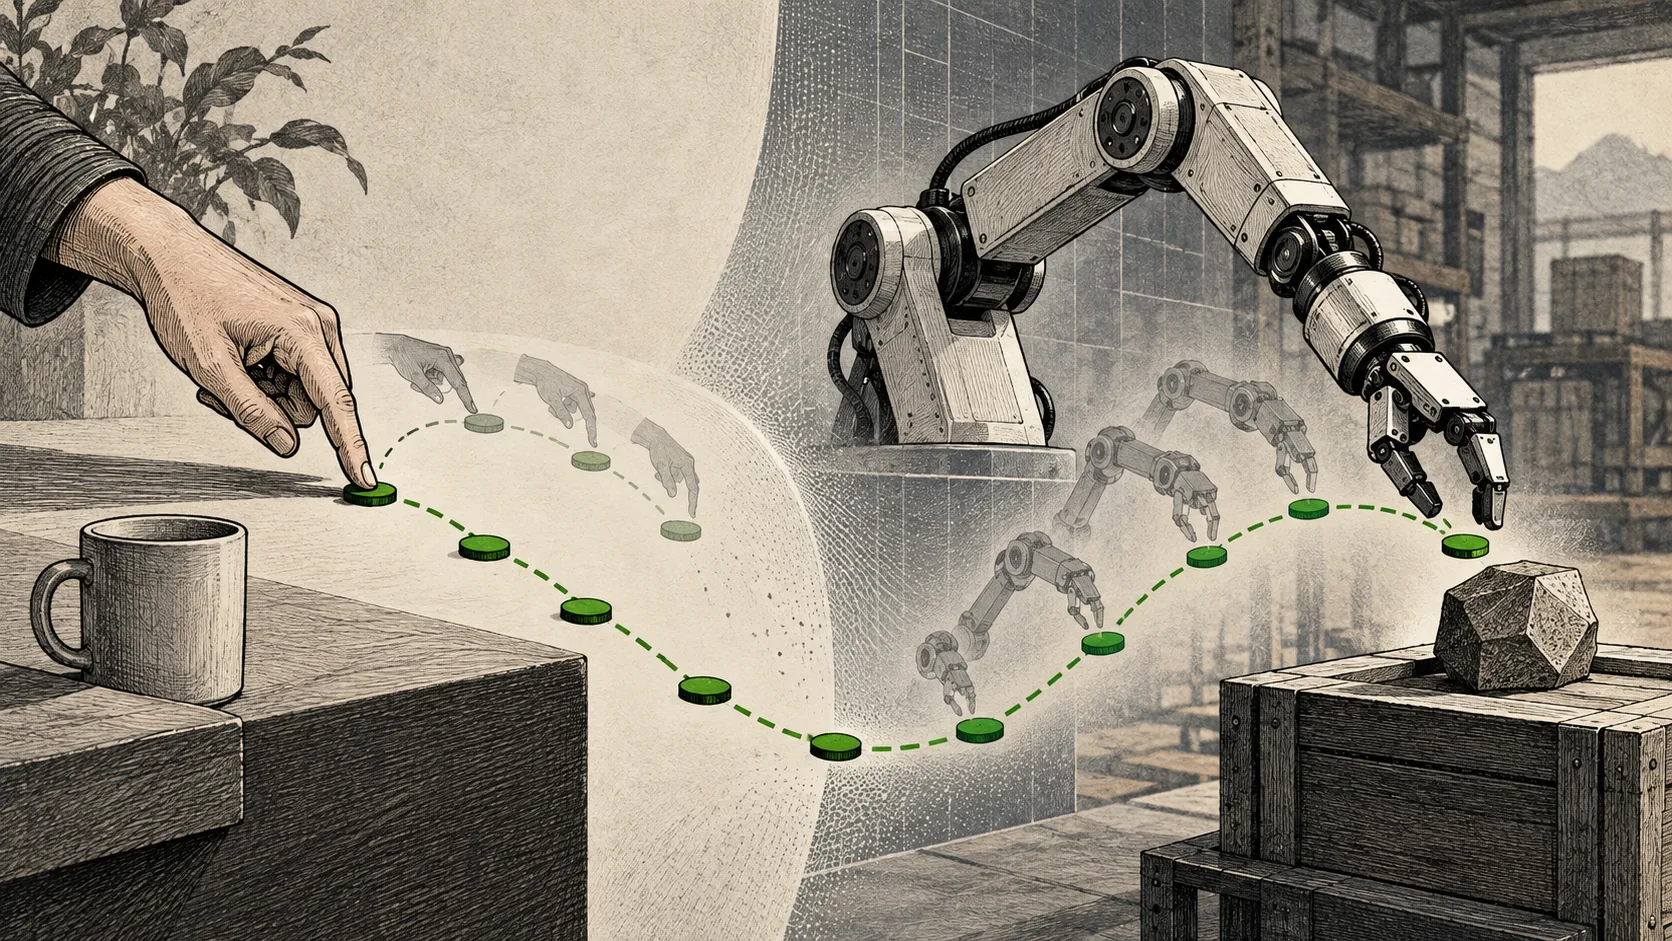
ThinkWorld는 각 행동을 연쇄 동역학(CoD)으로 표현합니다. 이는 현재 세계 상태와 미래 상태 사이의 중간 변화를 나타내는 이산 동작 토큰의 연속입니다. 연구진은 이 표현을 통해 서로 다른 형태의 로봇도 행동을 공통된 방식으로 나타낼 수 있다고 설명합니다. 먼저 행동 라벨이 포함된 시연으로 CoD를 초기화한 뒤, 각 CoD가 만들어낼 미래 상태를 예측합니다.
프레임워크는 예측 결과가 관찰된 결과와 더 잘 맞도록 CoD 예측을 강화합니다. 이에 따라 행동 주석이 없는 영상도 상태 사이에서 보이는 변화를 통해 학습을 지도하며, 사람과 로봇의 경험은 같은 행동 추론 공간을 다듬습니다. 연구진은 시뮬레이션과 실제 로봇에서 실험해 사람에서 로봇으로의 전이와 미관측 과제·환경에 대한 일반화를 보고했습니다. 초록에는 수치 결과나 구체적인 과제 수가 제시되지 않았습니다. 논문은 행동 라벨이 붙은 로봇 시연의 다양성과 범위가 제한적이라는 점을 VLA 모델의 일반화 제약으로 들고, 사람 영상은 더 폭넓은 행동 및 환경 경험을 제공한다고 설명합니다.