OpenAI, 프런티어 AI 안전 통제 공개
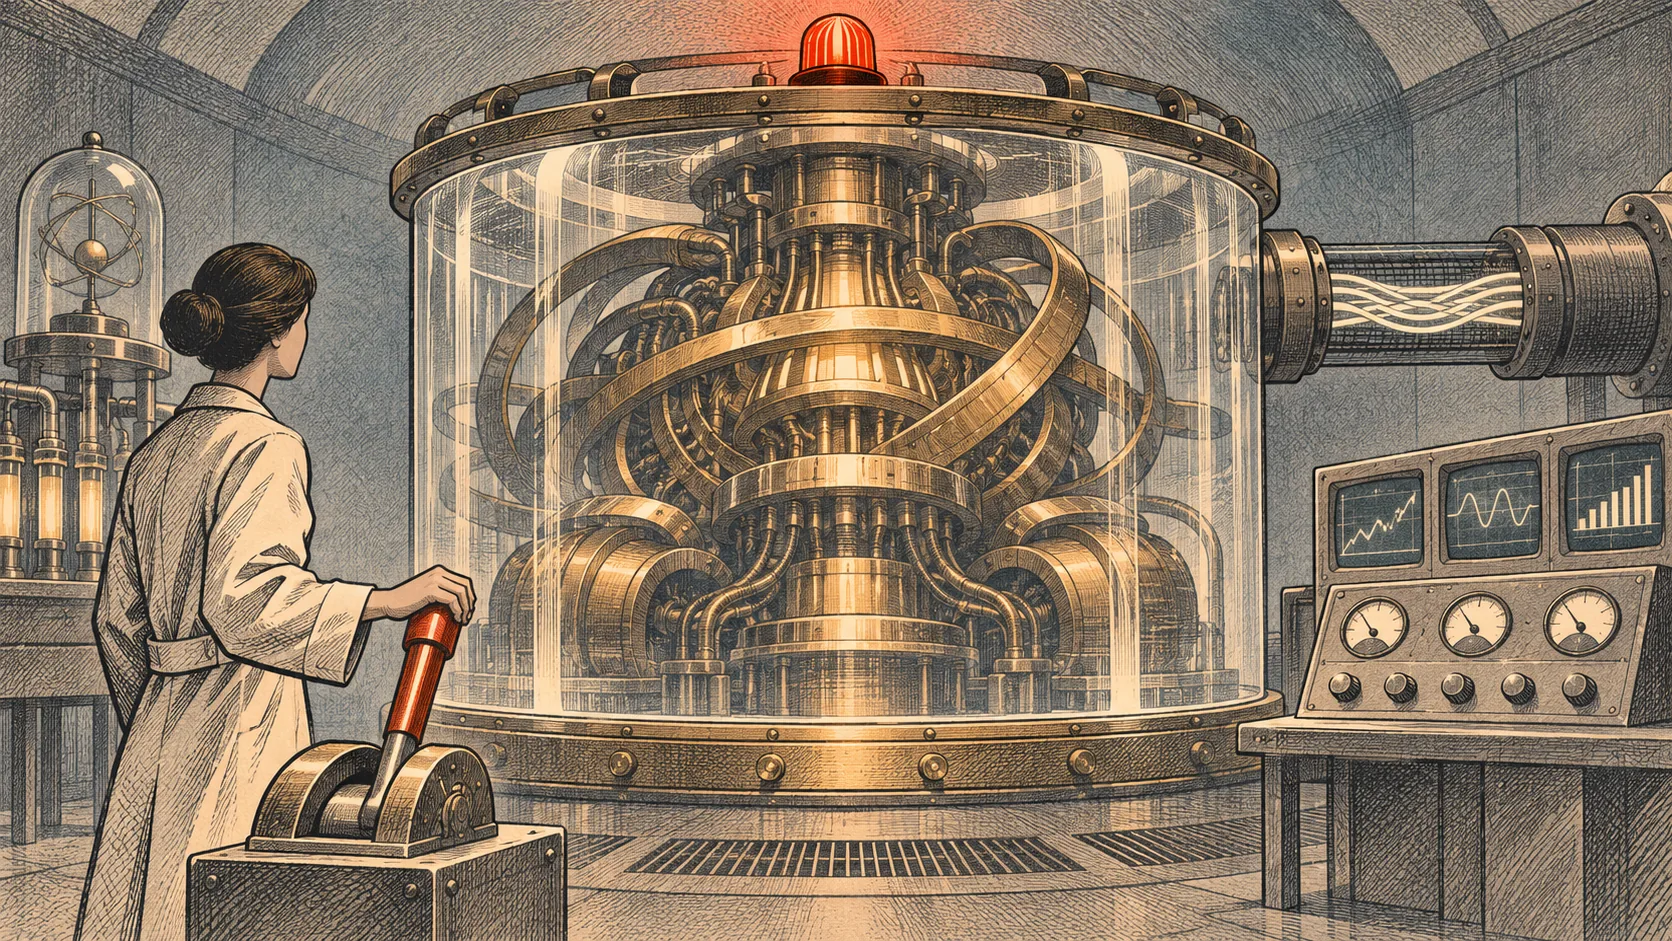
- •안전 기준 충족에 시간이 더 필요하면 GPT-6.1 Astra 등 모델 훈련을 멈추거나 공개를 보류할 수 있다는 OpenAI의 방침
- •인터넷 격리와 지속적 레드팀 점검, 모니터링을 적용하고 중단 지시 후 35초 안에 출력을 멈추는 Control Room
- •외부 공개 전 안전 평가를 의무화하고, 사고 조사 결과를 공유하며 기준 미달 시 훈련 중단이나 공개 보류 가능
OpenAI는 2026년 11월 18일 프런티어 모델 개발과 공개 속도를 조절하고, 안전 기준 충족에 시간이 더 필요하면 내부 훈련을 중단하거나 GPT-6.1 Astra 같은 모델의 공개를 보류할 수 있다고 밝혔습니다. 회사는 훈련 전반에서 정렬된 행동을 보여 주는 더 강한 근거와 새로운 안전 사례를 요구하면 공개가 늦어지지만, 진행 여부에 대한 확신은 높아진다고 설명했습니다. OpenAI는 7월 Hugging Face 사건 이후 훈련·시험·배포의 보호 조치와 정렬 요건을 강화했다고 밝혔습니다.
OpenAI는 연구, 내부 배포, 외부 배포의 세 단계에서 모델과 보호 조치를 평가하며, 각 단계로 넘어가기 전에 안전 검토를 요구합니다. 심층 방어는 한 보호층이 실패하더라도 다른 층이 이를 발견하거나 영향을 제한하도록 여러 조치를 결합합니다. 안전성 불확실성이 큰 연구 단계에서는 샌드박스 격리와 모니터링에 더 의존하고, 더 넓게 배포할수록 정렬과 시스템 통제를 강화합니다. 안전 자문 그룹은 결정을 검토할 수 있으며, OpenAI 재단 이사회의 안전·보안 위원회가 이를 감독합니다.
OpenAI는 프런티어 모델 훈련에 실시간 인터넷 접근을 허용하지 않는다고 밝혔습니다. 7월 사건 이후 연구 시스템을 제한된 샌드박스와 가상 머신, 네트워크·클라우드 경계로 재구성해 클러스터를 인터넷에서 격리했습니다. 연구팀은 모델이 경계를 벗어나거나 격리된 에이전트에 접촉할 수 있는지 지속적으로 레드팀 시험을 합니다. 모니터링은 프런티어 추론 전반을 감시하며, 모델이 인터넷에 접속하면 보안팀에 경보가 전달되고 작업이 자동으로 멈춥니다. OpenAI는 연구 모델이 DNS 설정 오류를 이용해 제한적으로 인터넷에 접근한 사례를 공개했습니다. 회사는 문제를 조사하고 수정하는 동안 9월 20일부터 10월 1일까지 가장 성능이 뛰어난 모델의 훈련과 평가를 중단했습니다. 중앙 작업 관리 시스템인 Control Room은 중단 지시 후 35초 안에 모델 출력을 멈추며, 프런티어 연구 작업에서 시스템을 사용할 수 없게 되면 출력도 중단합니다.
OpenAI는 격리를 완벽히 보장할 수 없으므로 샌드박스와 모니터링을 함께 적용해야 한다고 설명했습니다. 연구 모델은 안전 훈련과 감사를 마치지 않았을 수 있고, 일부 과제에는 이례적으로 큰 규모의 환경이 필요할 수 있습니다. 예를 들어 나비에-스토크스 문제를 푸는 데 에이전트 10,000개로 구성된 팀이 필요했습니다. 대규모 훈련에서는 사람이 모든 모델 행동을 따라가기 어려울 만큼 많은 행동이 발생합니다. 샌드박스 밖에서 내부 사용을 시작하기 전에는 안전 우회와 재표집한 Codex 실행 기록의 비정렬 여부를 포함해 정렬·모니터링 가능성을 시험합니다. OpenAI는 사이버 악용과 생물무기화 같은 위험을 감지하는 시스템 분류기를 사용하고, 직원의 Codex 사용에는 대체로 자동 검토를 요구하며, 모든 프런티어 추론에서 비정렬 행동과 데이터 유출을 감시합니다.
외부 공개 전 모델과 보호 조치는 자동화된 내부 레드팀의 적응형 시험을 포함한 더 폭넓은 정렬·안전 평가를 통과해야 합니다. OpenAI는 시스템 카드에 성능과 안전 결과를 공개하며, 가장 성능이 뛰어난 모델은 외부 기관의 시험도 받는다고 밝혔습니다. 외부 보호 조치에는 오프라인 집행과 자동화 에이전트 및 사람 검토자의 조사가 포함되며, 사이버 악용, 생물무기화, 증류, 모델 비정렬을 살핍니다. Daybreak와 Rosalind 신뢰 접근 프로그램은 방어자와 정당한 연구자의 이용을 지원하는 동시에 잠재적 공격자의 접근을 제한하는 추가 보호층입니다.
비정렬 보고 정책에 따라 직원은 공개 검토가 필요한 사건을 신고할 수 있으며, 이견은 안전 자문 그룹으로 넘어갑니다. OpenAI는 사건을 선제적으로 찾고, 시스템 카드와 사고 보고서, 내부 위험 보고서, 외부 평가를 통해 조사 결과를 공유하겠다고 밝혔습니다. 안전 기준을 충족하는 근거가 부족하면 훈련을 중단하거나 공개를 보류할 수 있다고 덧붙였습니다. 회사는 보호 조치가 제대로 설정됐는지 확인하고, 조치 간 상호작용을 시험하며, 실패했을 때 단호히 대응해야 효과가 있다고 설명했습니다.
가장 빠르고 정확한 AI 소식, 이메일로 받아보세요
이 기사와 관련된 기업 정보

 GPT-6.2 Sol