PostHog, 의사결정 모델로 LLM 호출 선별
- •PostHog, 비용이 큰 LLM 호출 전에 의사결정 모델로 작업 분류
- •Replay Vision 요약 98.7%는 LLM 호출 생략, 0.4 점수부터 개인정보 정리
- •임베딩 재순위화로 20개 테스트 질의의 결과 순위 품질 약 25% 개선
PostHog는 대규모 언어 모델(LLM)을 호출하기 전에 제한적인 분류와 경로 선택 작업을 의사결정 모델로 처리한다고 밝혔습니다. 이 모델은 자유 형식 문장 대신 유형이 정해진 답과 확률 점수를 반환합니다. 보정된 점수 0.8은 답변이 약 80%의 확률로 맞는다는 뜻입니다. 회사에 따르면 의사결정 모델은 최첨단 모델보다 최대 444.6배 저렴하고 193.6배 빠르며, LLM 호출이 필요한지 먼저 가려내는 데 쓰입니다.
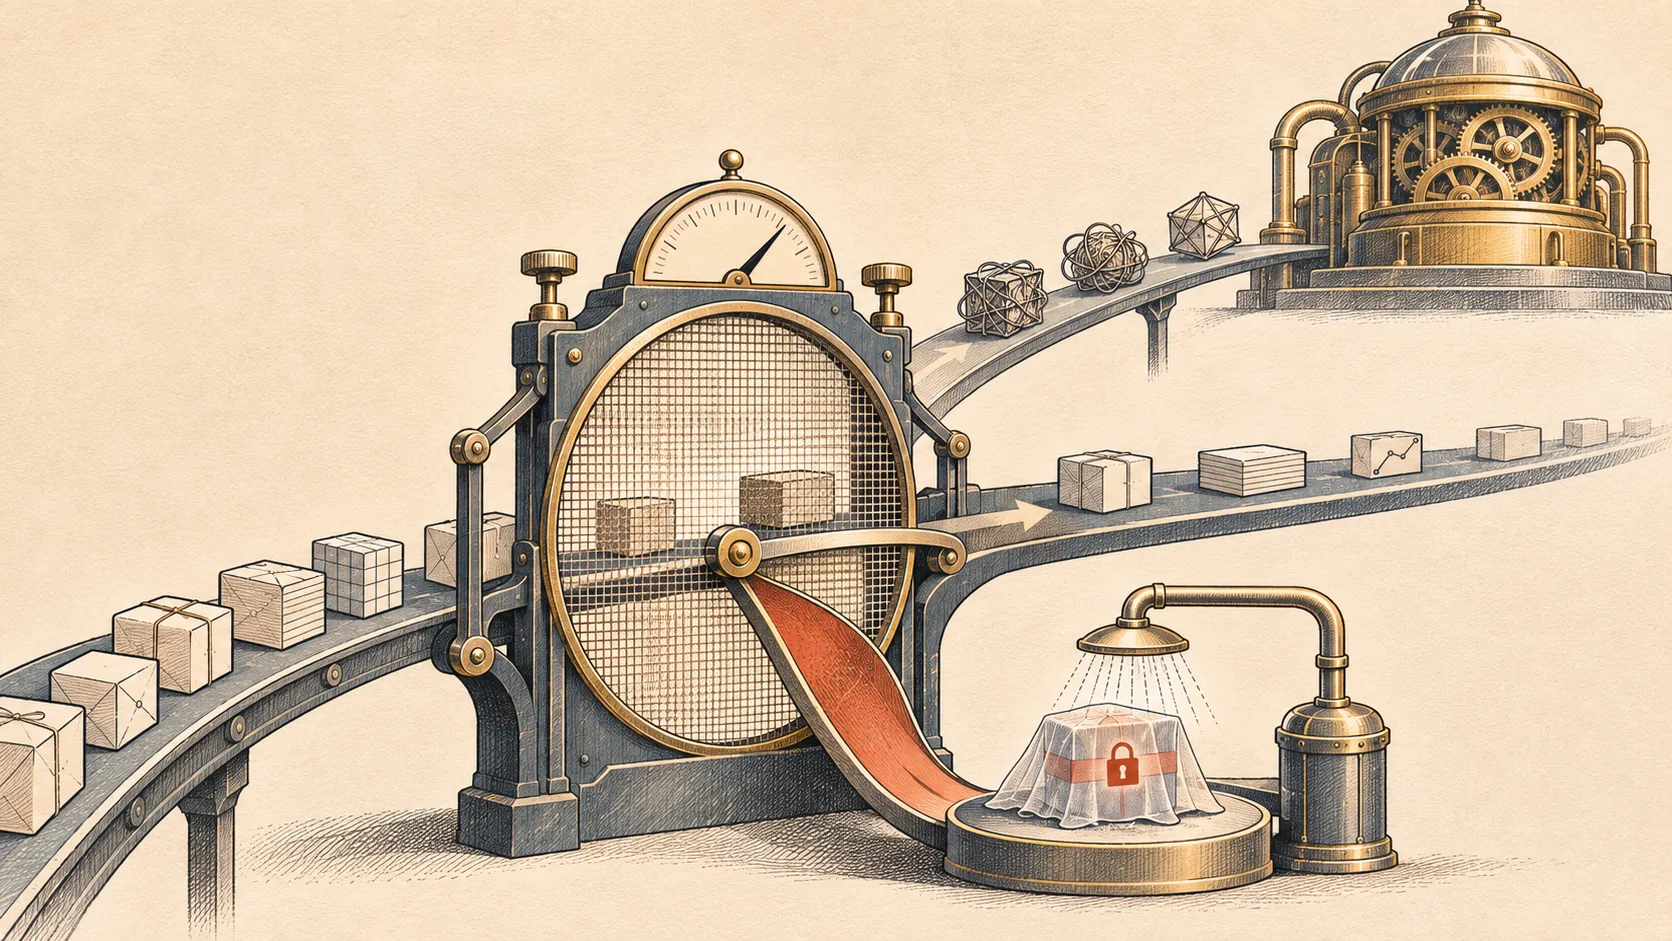
Replay Vision에서는 각 세션 요약에 실제 인물이 언급됐는지, 연락처나 신분증 정보가 있는지 두 가지 예·아니요 질문을 적용합니다. 어느 하나라도 점수가 0.4 이상이면 Gemini가 개인정보를 제거한 뒤 요약을 다시 검사하고, 그렇지 않으면 그대로 통과시킵니다. 실제 운영에서 요약의 98.7%는 LLM 호출을 건너뜁니다. PostHog는 좁은 질문 두 개를 쓰면 질문 하나만 쓸 때보다 오탐이 약 10분의 1로 줄어든다고 밝혔습니다. 점수 0.85도 검사 1,000건 중 약 150건의 오답을 뜻할 수 있습니다. 이 사례에서는 개인정보 누락의 비용이 추가 LLM 호출보다 크다고 보고 낮은 0.4 기준을 적용합니다. 반면 원치 않는 응답이 더 큰 문제인 Slack 봇은 정보 요청 여부와 PostHog가 답할 수 있는지 두 항목 모두 0.85 이상인 메시지만 전달합니다.
PostHog는 태그가 붙은 Slack 요청을 적절한 모델로 보내는 데도 의사결정 모델을 씁니다. 사용자가 모델을 지정하지 않으면 짧은 설명이 붙은 선택지 중에서 첫 시도에 정확히 처리할 가능성이 있는 가장 저렴한 모델을 고르도록 합니다. 회사는 기준 점수가 작업, 모델, 제공업체에 따라 달라진다고 설명했습니다. 비슷한 Error Tracking 로그를 자동 병합하는 시험에서는 같은 모델의 버전 1과 버전 2 사이에서도 기준이 달라졌습니다. 이에 PostHog는 프로젝트별로 기준을 설정할 수 있게 했고, 사람이 표시한 데이터로 재보정하는 동안 판정 모델을 섀도 모드로 운영했습니다. 현재는 자체 호스팅 모델을 포함해 모델을 교체하고 시험할 수 있는 내부 AI 게이트웨이를 사용합니다.
Replay Vision에서 “온보딩 마찰” 같은 검색을 하면 먼저 임베딩이 세션 녹화 목록을 만들고, 의사결정 모델이 각 요약과 질의의 관련도를 매겨 결과 순서를 다시 정합니다. PostHog에 따르면 20개 테스트 질의에서 순위 품질이 약 25% 개선됐습니다. 다만 더 많은 맥락이나 여러 단계의 추론이 필요한 경우 의사결정 모델은 모든 세션의 순위를 처음부터 매길 수 없습니다. 세션 하이라이트를 고르려던 이전 시도에서는 질문 두 개를 연결해 매시간 최대 32개 세션과 각각 12~38k 토큰을 요청했습니다. 요청이 모델 서버에 몰려 다른 제품의 호출이 몇 시간 동안 막혔습니다.
조직이 선택적으로 허용하면 PostHog는 SQL 질의와 결과의 첫 세 행을 고려하는 의사결정 모델을 써서 차트 선택 규칙도 대체합니다. 브라우저별 페이지뷰 질의에서 Jev 모델은 브라우저별 막대 차트를 골랐고, 기존 규칙은 합산 선형 차트를 선택했습니다. 내부 PR 검토 에이전트의 조사 결과 순위를 매기는 시험에서는 질문 다섯 개의 결과가 명확하지 않았으며 AUC는 0.52였습니다. PostHog는 일반 의사결정 모델이 큰 요청을 처리하지 못해 이런 추론에는 적합하지 않고, 긴 맥락 모드도 더 느리고 정확도가 낮다고 밝혔습니다. 사내 연구팀은 확신이 없을 때 먼저 추론한 뒤 결정하는 하이브리드 의사결정 모델 Jeeves를 개발했습니다. Jeeves는 모델을 지정하지 않은 의사결정 호출의 기본 모델이며, 회사는 유사한 변형 모델 Kev도 언급했습니다. PostHog의 지침은 LLM을 쓰기에는 입력이 단순하지만 정규식만으로 처리하기에는 모호한 작업에 의사결정 모델을 쓰고, 복잡한 다단계 추론은 LLM에 맡기는 것입니다.
가장 빠르고 정확한 AI 소식, 이메일로 받아보세요
이 기사와 관련된 기업 정보

 Gemini 4 Hydrogen