연구진, 로봇 조작 모델 SLA 발표
HuggingFace2026년 11월 7일 (토)
- •연구진, 11월 5일 논문에서 로봇 조작용 공간·언어·행동 모델 SLA 발표
- •SLA, 다양한 로봇 데이터와 작업으로 학습하며 시각 임베딩을 공간 표현과 정렬
- •저자들, 학습 때만 쓰는 구성 요소로 추론 구조를 유지한다고 설명
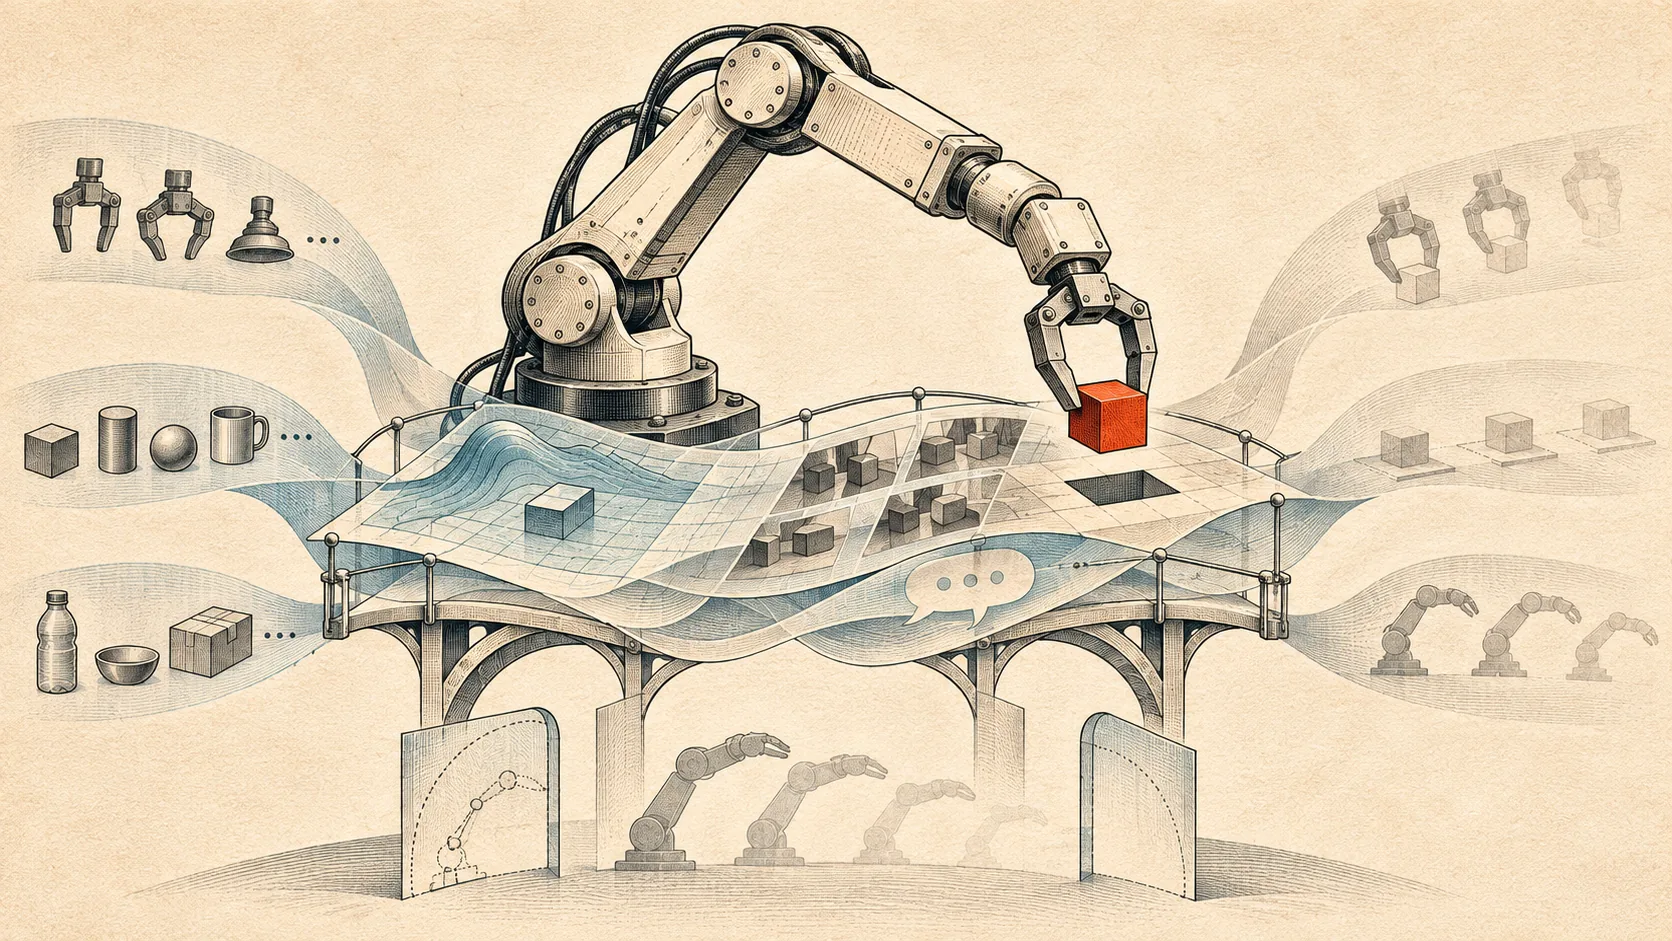
연구진은 11월 5일 발표하고 11월 6일 제출한 논문에서 로봇 조작용 공간·언어·행동 모델 SLA를 소개했습니다. SLA는 의미를 이해하는 능력과 3차원 공간에서 정밀하게 제어하는 능력을 결합하는 것을 목표로 합니다. 저자들은 시각·언어·행동(VLA) 모델이 흔히 2차원 시각·언어 사전학습에서 표현을 이어받고, 특정 작업에 맞춘 적응 단계에서 주로 공간 감독을 추가한다고 설명했습니다.
사전학습된 pi05 정책으로 초기화한 SLA는 정책을 지속적으로 사전학습하고 사후학습하면서, 중간 시각 임베딩을 동결된 3차원 인식 모델의 공간 표현과 정렬합니다. 연구진은 로봇 형태와 작업, 장면이 서로 다른 여러 데이터셋을 통합했습니다. 특징 의존 게이트(특징을 조합하는 학습된 제어 장치)는 여러 VLA 계층에서 시각 임베딩을 골라 공간 감독에 사용합니다.
3차원 인식 모델은 RGB 관측값과 함께 이용 가능한 깊이 정보 및 카메라 보정 데이터를 사용해 다양한 기하학적 주석을 활용합니다. 확률적 상태 드롭아웃(학습 중 상태 입력을 무작위로 생략하는 기법)은 모델이 시각적 단서에 의존하도록 유도하고 시연 궤적에 대한 과적합을 줄입니다. 저자들에 따르면 보조 구성 요소는 학습 중에만 쓰이므로, SLA는 사전학습된 VLA 가중치를 재사용하면서 기존 추론 구조를 유지할 수 있습니다.