Preferred Networks, 3D 장면 재구성법 T3lescope 공개
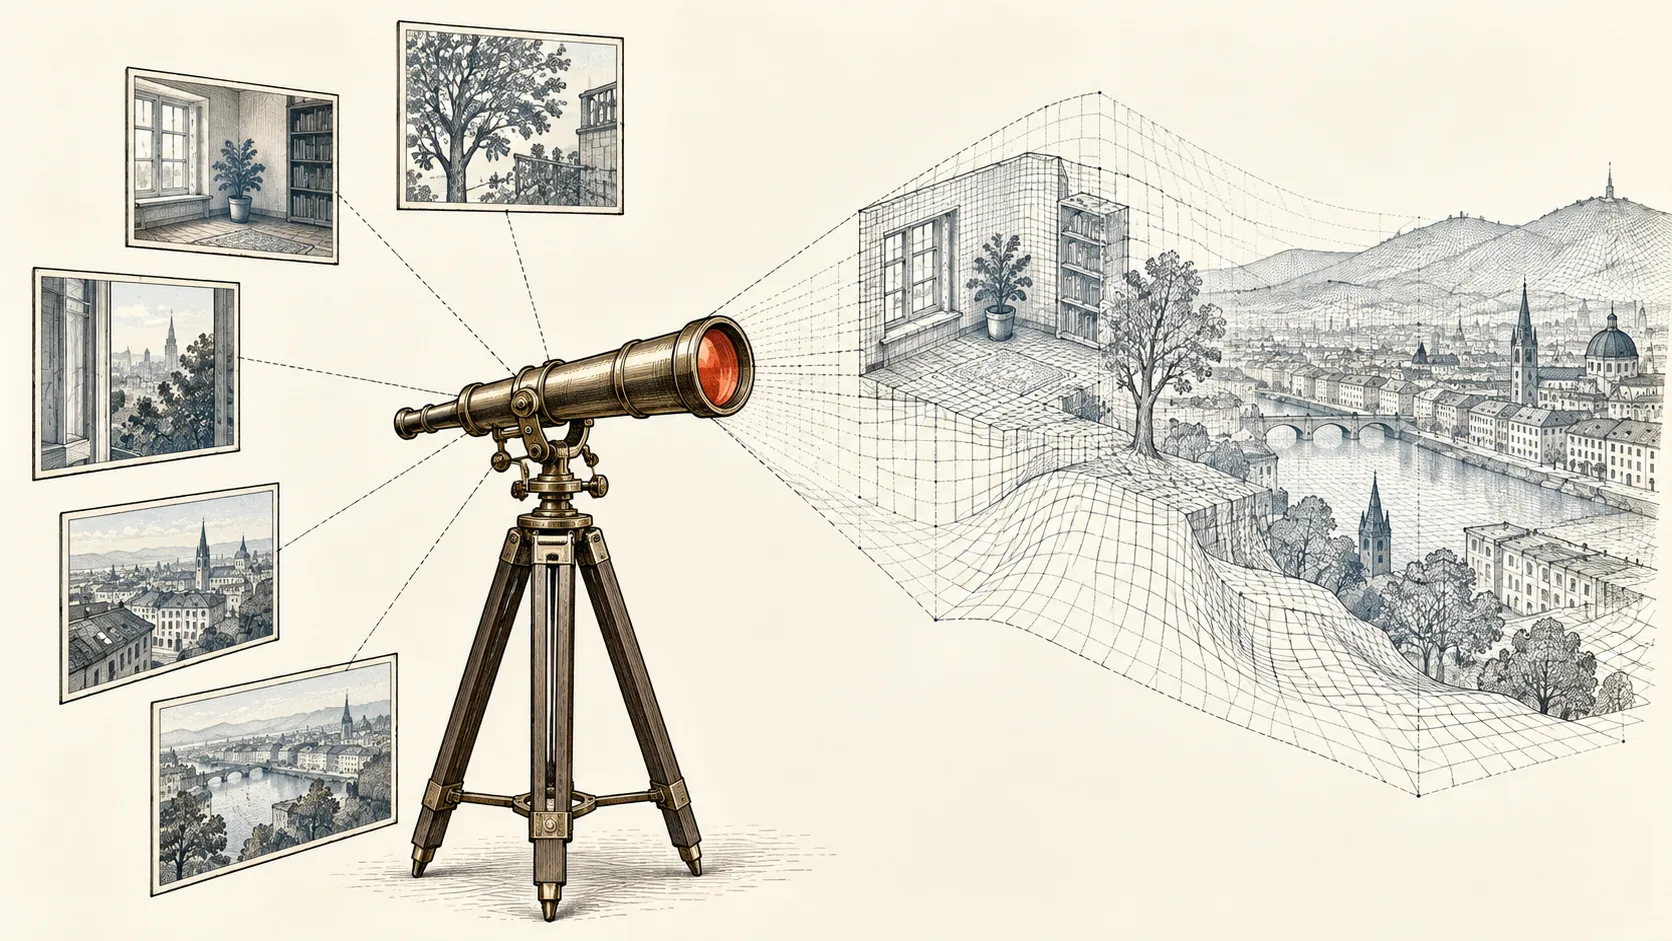
- •Preferred Networks 연구진, 여러 시점 이미지에서 3D 장면 메시를 복원하는 T3lescope 발표
- •장면별 최적화 없이 단일 고정 해상도 생성기로 단일 객체부터 대규모 야외 영역까지 처리
- •실내·야외·도시 규모 장면에서 순전파·생성 기준 모델보다 높은 성능 보고
Preferred Networks 연구진은 여러 시점에서 촬영한 카메라 자세 정보가 있는 이미지로 고품질 3D 장면 메시를 복원하는 방법 T3lescope를 발표했습니다. 이 방법은 장면마다 별도의 3D 표현을 최적화하지 않고도 단일 객체부터 넓은 야외 영역까지 처리합니다. 논문은 10월 2일 공개됐고 10월 13일 Hugging Face Papers에 제출됐습니다.
기존 생성형 복원 방법은 학습된 3D 사전 정보를 활용해 이미지 관측이 드문 곳의 형태를 보완하며, 광택이 있거나 투명한 표면도 다룹니다. 많은 방법은 해상도와 공간 범위가 고정돼 세부 묘사와 넓은 범위 사이에서 절충합니다. 큰 장면은 겹치는 영역을 나눠 처리해야 할 수 있어 전체 형태의 일관성을 유지하기 어렵습니다.
T3lescope는 추론 단계에서 거친 단계부터 세밀한 단계로 진행하는 방식으로, 하나의 고정 해상도 생성기를 다양한 장면 규모에 적용합니다. 먼저 거친 단계에서 전체 배치를 잡고, 이후 단계에서는 앞서 얻은 기하 정보를 바탕으로 점차 작은 공간 셀 안에서 형태를 교란하고 잡음을 제거해 표면 세부를 복원합니다. 모델은 여러 규모의 개별 셀을 대상으로 학습하고 단계 간 가중치를 공유하며, 단계 수와 셀 규모·위치는 추론 단계에서 정합니다.
연구진은 실내·야외·도시 규모 장면 평가에서 T3lescope가 순전파 기준 모델과 생성형 기준 모델보다 높은 성능을 보였고, 장면별 최적화 방식과 같거나 더 나은 결과를 냈다고 보고했습니다. 또한 세밀한 구조와 광택·투명 표면을 복원했으며, 장면 종류와 이미지 시점 수, 이미지 해상도가 달라져도 일반화했다고 밝혔습니다.