연구진, VidUEU-Agent 영상 데이터 파이프라인 공개
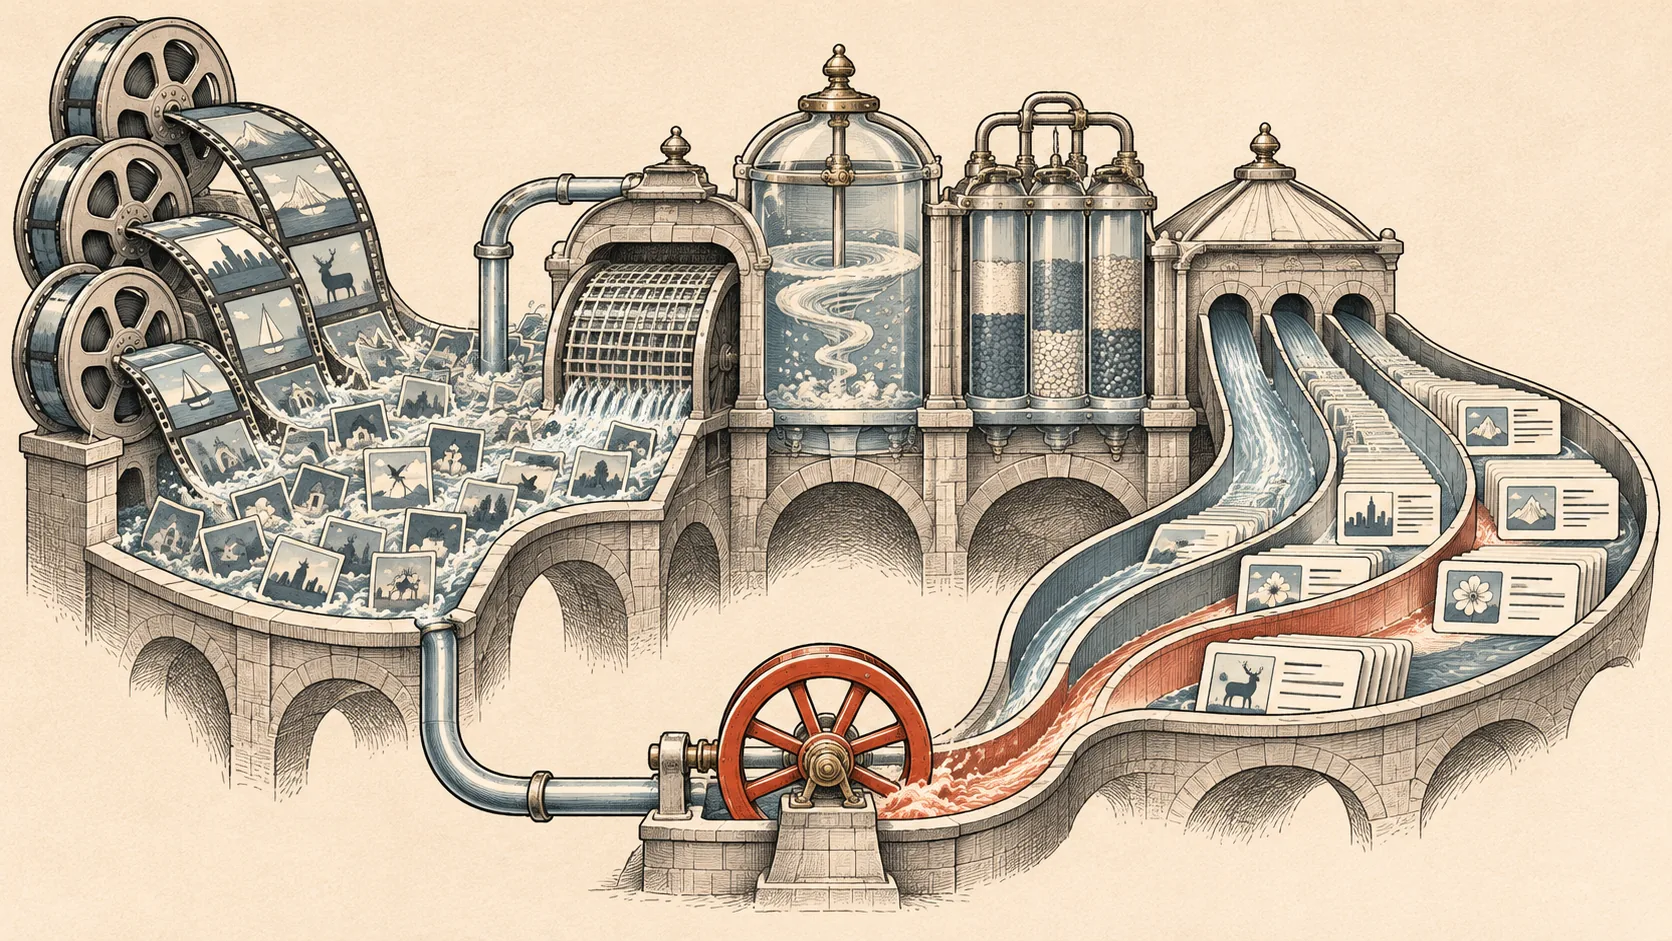
- •연구진, 원본 영상에서 멀티모달 지시 데이터를 만드는 VidUEU-Agent 소개
- •4단계 파이프라인, 학습·평가 피드백으로 데이터 분포 반복 개선
- •VidUEU-100K, 영상 8,268개 기반 샘플 10만 개와 9개 작업 유형 수록
연구진이 원본 영상에서 멀티모달 이해, 이미지 편집, 이해·생성 통합 작업용 지시 데이터를 만드는 자동화 파이프라인 VidUEU-Agent를 공개했습니다. 저자들은 고품질 지시 데이터의 부족과 높은 주석 비용을 해결하기 위해 시스템을 개발했다고 밝혔습니다. 논문은 11월 3일 공개됐고, 11월 4일 Hugging Face에 제출됐습니다.
파이프라인은 영상에서 품질이 낮은 장면을 걸러내고, 주요 프레임과 멀티모달 신호를 선택한 뒤, 구조화된 메타데이터를 만들고 이를 적합한 작업에 연결해 지시 데이터를 생성하는 4단계로 구성됩니다. 시각·언어 모델과 시각 도구를 사용해 품질 평가, 의미 분석, 정보 검증을 수행합니다. 데이터 생성 때 근거로 사용한 신호를 함께 표시해 추적 가능성과 사실 일관성을 높인다고 저자들은 설명했습니다.
VidUEU-Agent는 후속 학습과 평가 결과를 반영해 역량, 분야, 작업 유형별 데이터 분포도 조정합니다. 저자들은 동일한 초기 체크포인트에서 BAGEL을 미세 조정하며, 각 3만 개 샘플을 사용한 4회 반복을 거쳐 피드백 벤치마크 3개 모두에서 종합 성능이 개선됐다고 보고했습니다. 그 결과물인 VidUEU-100K 데이터셋은 영상 8,268개에서 구축됐으며, 조밀한 메타데이터 주석 약 2만 건과 지시 샘플 10만 개를 담았습니다. 샘플은 이해 4만 개, 편집 3만 개, 통합 작업 3만 개로 구성되고, 9개 작업 패러다임과 5개 시나리오 범주를 포괄합니다. 저자들은 이 데이터셋으로 기준 모델을 미세 조정했을 때 대표 벤치마크 전반에서 일관된 향상이 나타났다고 밝혔지만, 개별 점수는 공개 페이지에 제시되지 않았습니다.