オンデバイスAIとクラウドAI、仕事に合わせてどう使い分ける?
機内モードにしたスマートフォンに「音楽をかけて、窓を閉めて」と話しかけます。AIはその指示を理解して応答します。続けて「この音楽は少し退屈。もっと楽しい曲に変えて」と伝えると、前の会話を踏まえて反応します。
これは、11月11日にソウルで開かれた「DEEP DIVE INTO 2026」で、Liquid AI JapanのCTO、Rom Parnichkun氏が披露した車載音声アシスタントのデモの一場面です。
Liquid AIは、MITの研究者らが設立したAI企業です。スマートフォンからサーバーまで、さまざまな環境で効率よく動くモデルを開発しています。同社は当初、オンデバイスに限定せず、AIモデルの効率を高める研究から出発し、その取り組みを端末上で動くモデルへと広げてきました。
小さな端末で動くAIから、巨大なデータセンターを使うクラウドの大規模モデルへ。そして今、オンデバイスとクラウドをどう組み合わせるかが、改めて注目されています。
AIが動く場所が変わってきた
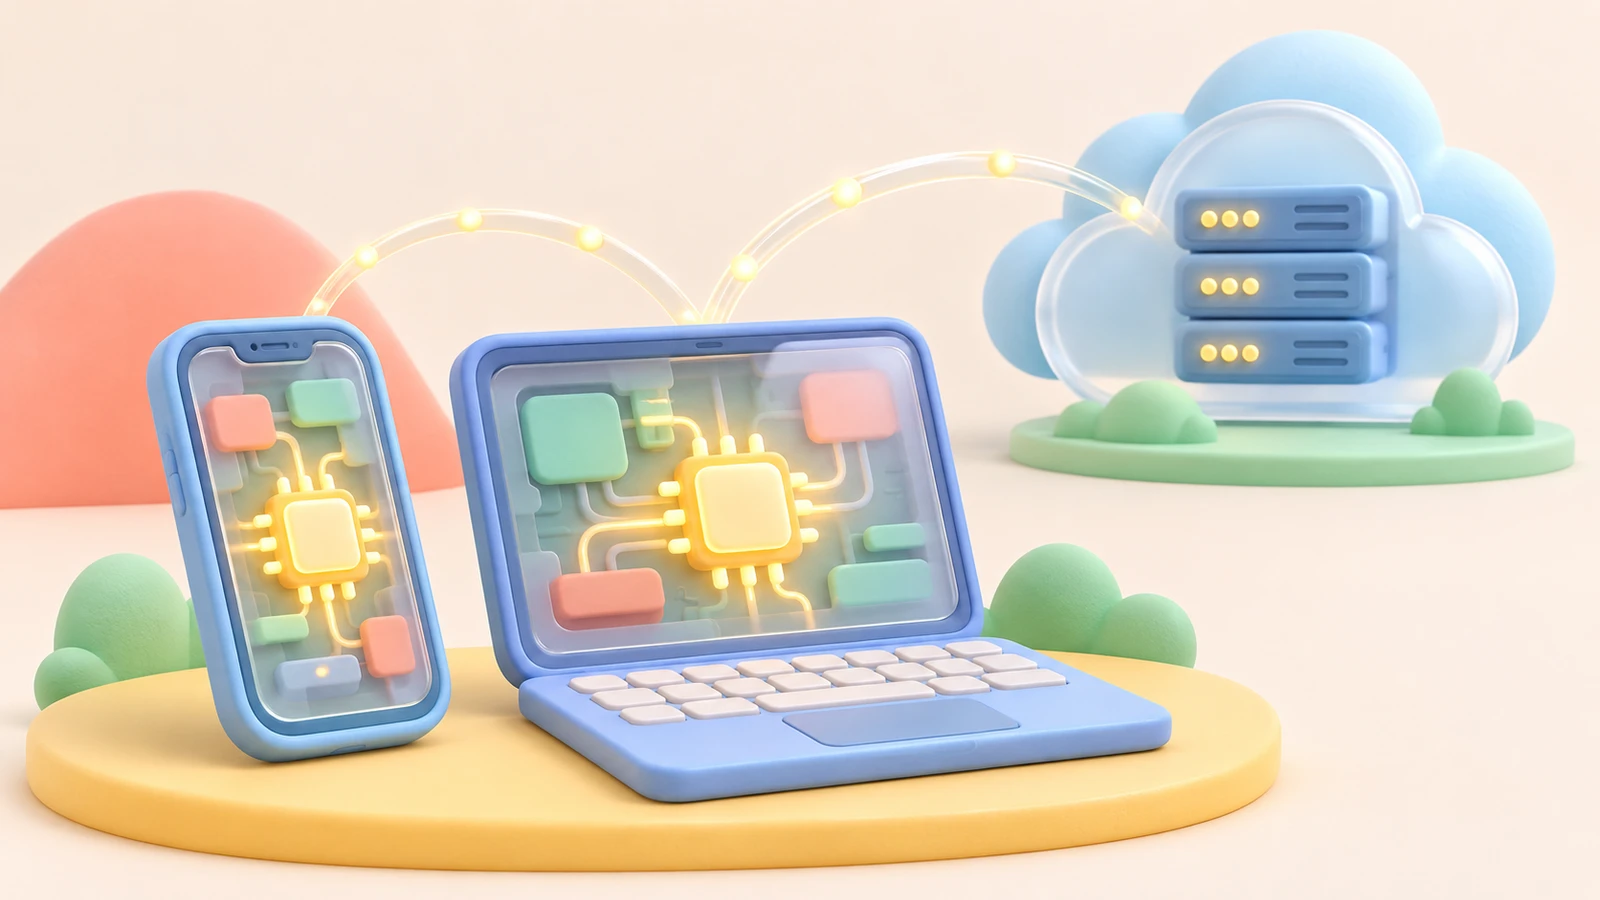
ChatGPTやGeminiのようなサービスでは通常、質問がインターネットを通じてサーバーに送られ、サーバー上のモデルが回答を生成します。これがクラウドAIです。
一方、オンデバイスAIは、スマートフォンやノートパソコン、自動車など、利用者が使う端末の中でモデルを動かします。必要なデータを端末で直接処理できることが、大きな違いです。
この二つはモデルの大きさだけで分かれるわけではありません。小さなモデルをサーバーで動かすことも、比較的大きなモデルをノートパソコンや自社サーバーで動かすこともできます。オンデバイスとは、モデルの賢さではなく、どこで動くかを表す言葉です。
これまで端末上のモデルは、できることが限られているという印象が強くありました。しかし、モデルの設計を効率化し、特定の業務に合わせて学習させることで、端末上で扱える仕事が増えています。特定の作業では、より速く、低コストで処理できる場合もあります。
小さなモデルをつくる新しい方法
Liquid AIが取り組むのは、単にモデルを小さくすることではありません。同じ端末で動かしても、より高い性能を発揮できる構造を探しています。
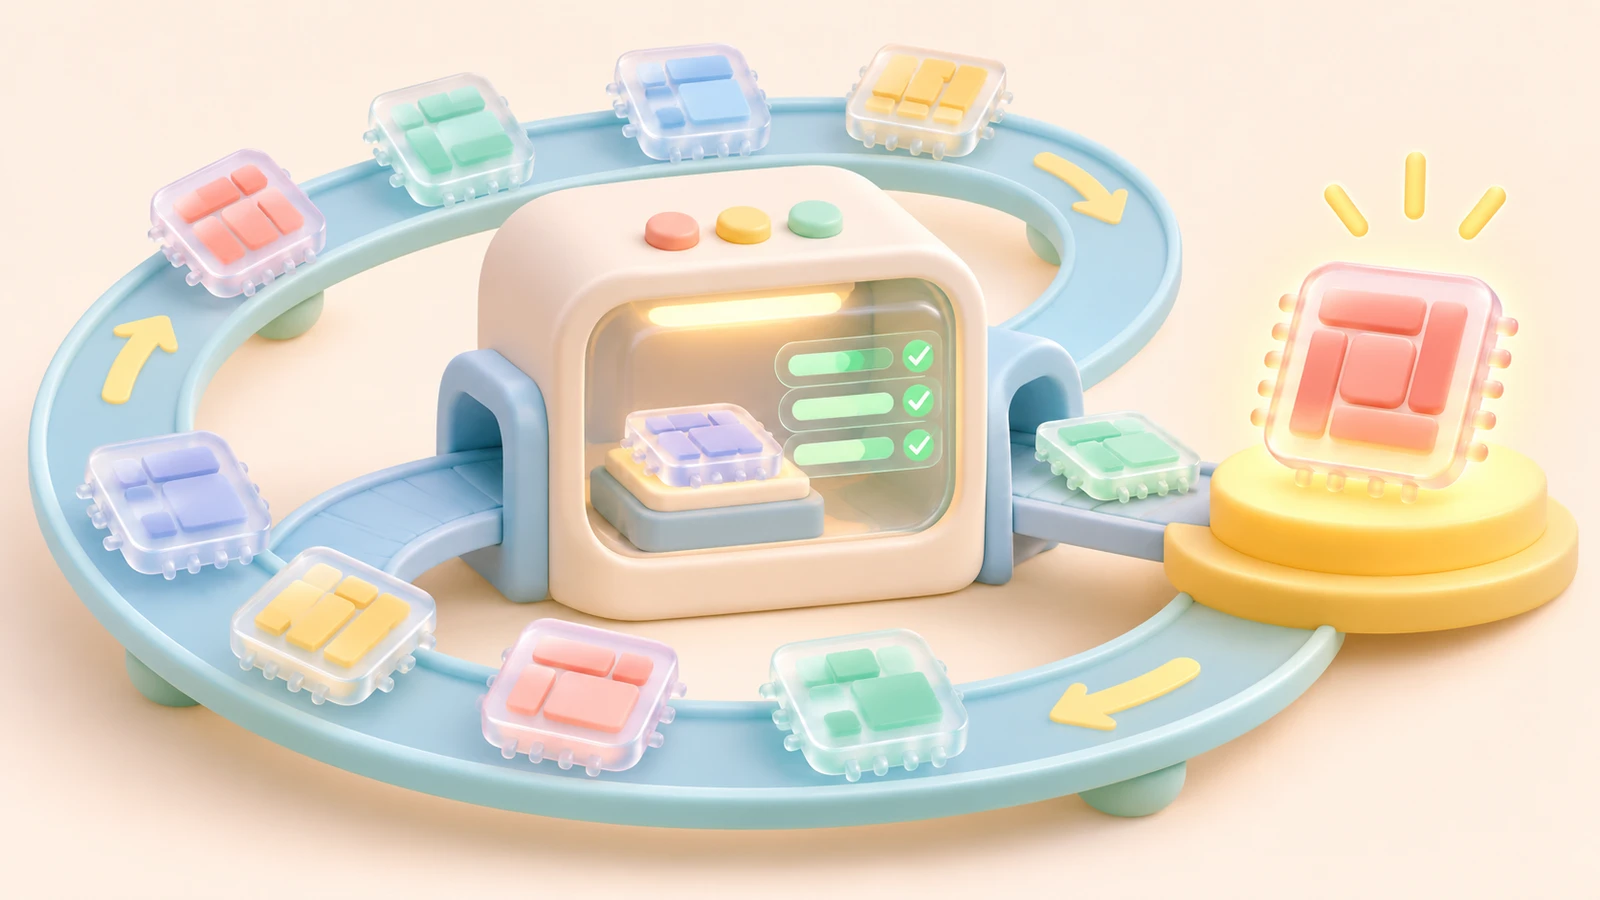
Rom氏が説明したのは、複数のモデル構造を作り、実際の端末で試す方法です。それぞれを学習させ、回答の品質に加えて、スマートフォンやノートパソコンでの実行速度とメモリ使用量を測定します。
その後、良い結果を出した構造を残し、一部を変化させて新たな候補を作ります。生成、試験、選択を繰り返し、その端末に合う構造を探します。生物の進化における選択と変異に似ていることから、進化的探索と呼ばれます。
Liquid AIは、この方法で見つけた構造を基にモデルを学習し、数学、コーディング、ツール利用などの能力をさらに高めます。分野ごとに学習したモデルの能力を一つのモデルに伝える手法も使います。小さなモデルが限られた大きさの中で、さまざまな作業に対応できるようにするためです。
この開発や学習には多くの資源が必要です。小さなモデルが簡単に作れるという意味ではありません。開発段階で投資し、完成後はより小さな端末で繰り返し動かす。それがLiquid AIの考え方です。
Rom氏は、今後関心のある研究として再帰的自己改善(RSI)にも言及しました。AIが利用中に得た情報を基に、自らを改善する方法を探る研究です。特に、個人の端末にある情報をすべて外部に送らずに、利用者に合わせて進化する可能性に注目しています。
AIが一人ひとりに合わせてどう改善できるのかは、これからの課題です。モデルの開発から、利用者の端末での動き方まで、変化が広がっています。
オンデバイスAIが注目される理由
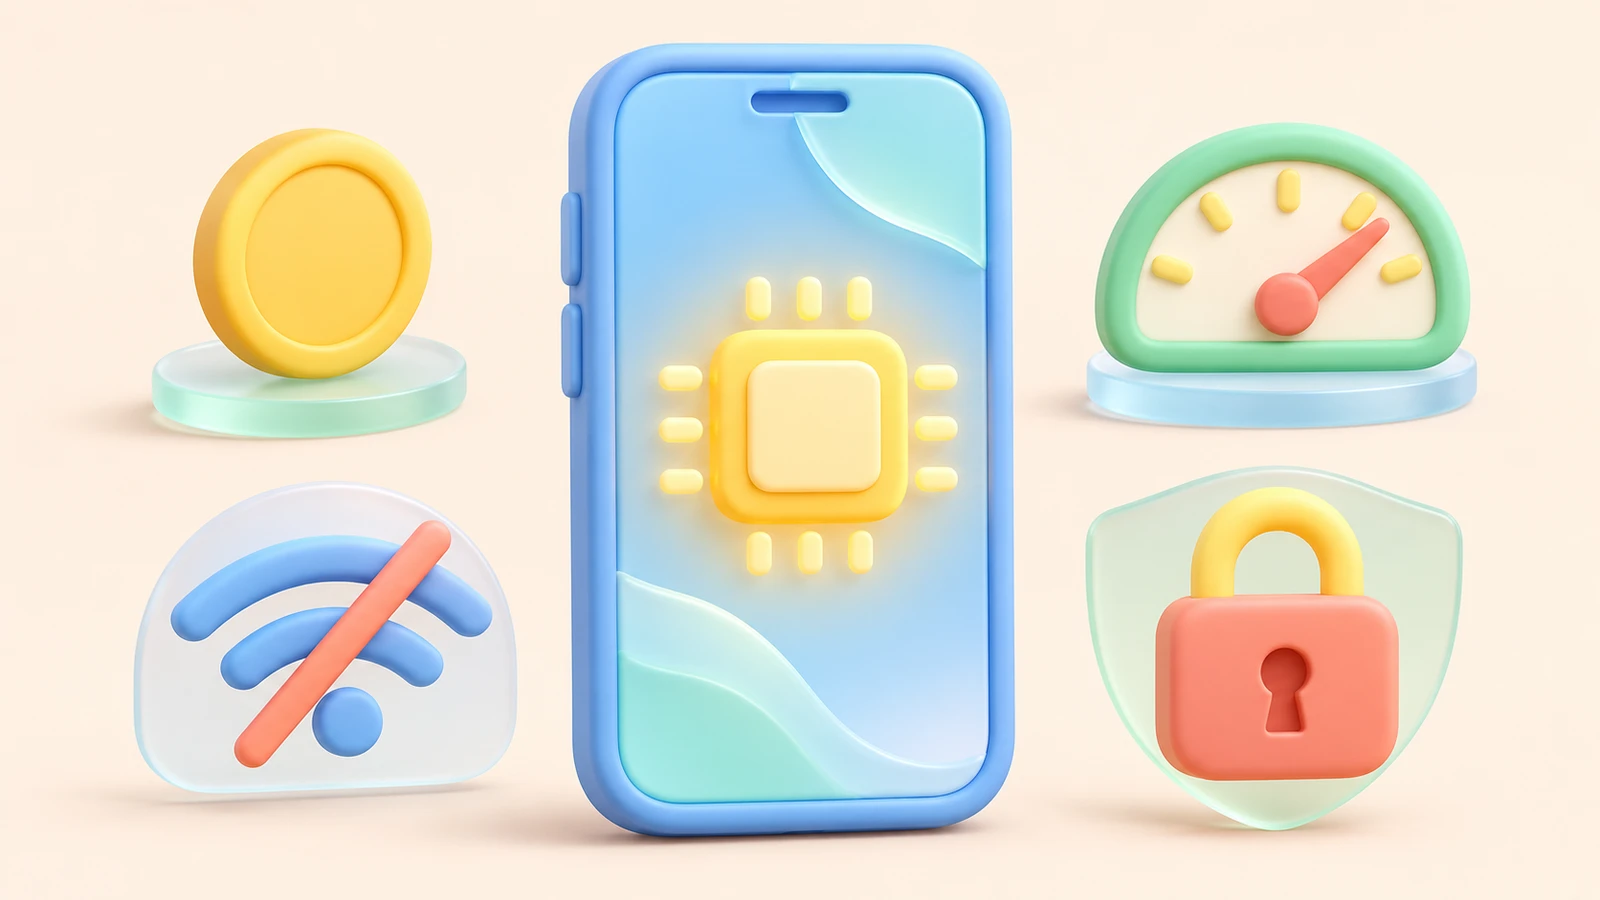
Rom氏はオンデバイスAIの利点として、コスト、オフライン利用、応答速度、プライバシーを挙げました。
インターネット接続が不安定でも、端末内で完結する作業は続けられます。接続状態が一定でない工場や物流現場、移動中の車内では特に重要です。
応答速度も変わります。クラウドではデータをサーバーに送り、結果を受け取るまでの通信が必要です。端末内で処理すれば、その往復時間をなくせます。すぐに反応してほしい音声アシスタントでは、利用体験にも影響します。ただし、実際の速度は端末の性能やモデルの大きさ、作業量によって変わります。
データの扱い方にも選択肢が生まれます。例えば社内文書を端末内で分析するよう設計すれば、文書全体を外部モデルに送らずに必要な作業を処理できます。
コスト構造も異なります。端末でモデルを実行する作業には、クラウドモデルを呼び出す従量課金がかかりません。一方、モデルを動かせる端末の購入費用に加え、導入・保守、メモリやバッテリーの消費、更新費用を考慮する必要があります。1回の呼び出しではなく、サービス全体の運用コストで比べることが大切です。
身近なAIはもっとパーソナルになる
オンデバイスAIが変えるのは処理速度だけではありません。AIとの付き合い方も変わるかもしれません。
今は、知りたいことがあるとアプリを開いて質問することが多いでしょう。スマートフォンや自動車にAIが入っていれば、別のサービスを探しに行かず、普段使っている端末に話しかけられます。
講演では、スマートフォン上のAIが、アクセスを許可された予定やメールを基に結婚式の招待状を確認し、予定の重複や移動に必要な情報を整理するデモ映像も紹介されました。毎回最初から状況を説明しなくても、端末内の情報を使って手伝うという例です。
利用者の予定や好みを理解できれば、AIはよりパーソナルなアシスタントに感じられるかもしれません。車ではよく使う機能を声で操作し、スマートフォンでは許可された情報から必要な内容を整理する、といった使い方です。
ただし、端末内にあるだけで利用者を理解し、安全に行動できるわけではありません。どの情報にアクセスさせるかを利用者が決められ、メッセージ送信や予約のような実際の行動には適切な確認が必要です。
オンデバイスとクラウドを組み合わせる
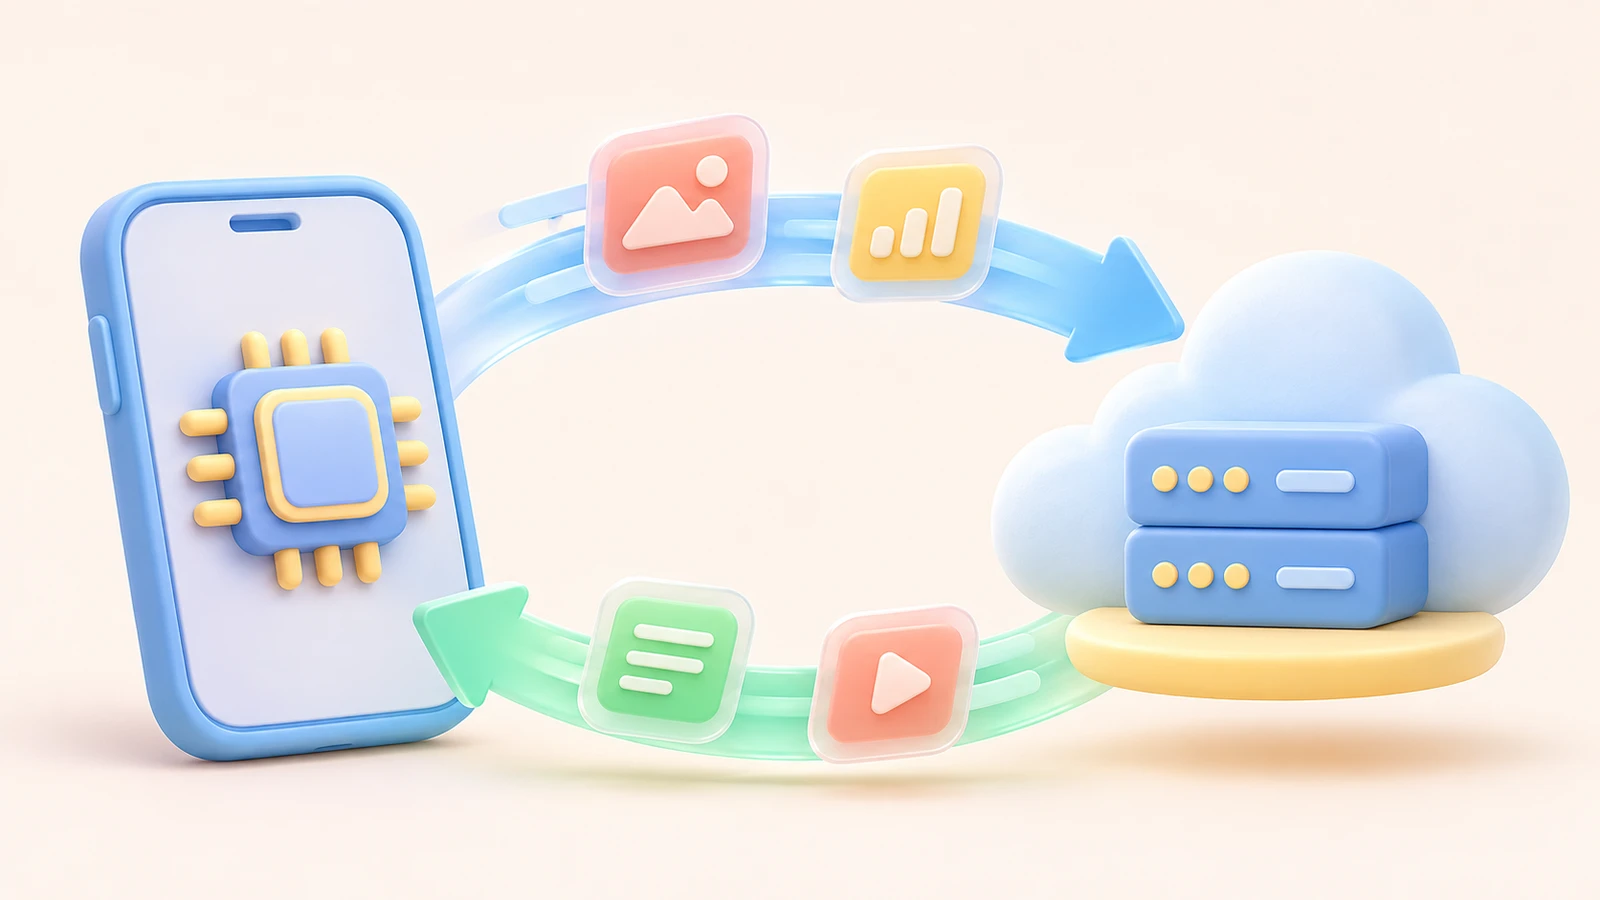
オンデバイスとクラウドは、どちらか一方だけを選ぶ関係ではありません。一つのサービスの中でも、作業に応じて組み合わせられます。
例えば、現場の担当者の音声指示は端末で理解し、よく繰り返す作業はその場で処理します。通信が不安定でも基本機能を使え、すぐに反応してほしい指示にも対応できます。
一方、複数の長い文書を分析したり、幅広い分野の知識を結び付けたりする場合は、クラウド上のより大きなモデルを活用できます。その際は、利用者が許可した情報だけを送ります。新しい情報が必要なら、別途検索機能も組み合わせます。
自動車でも同様です。窓を閉めたり音楽を変えたりする指示は端末で処理し、より複雑な調査や計画にはクラウドモデルを使う。利用者には一つのAIアシスタントに見えても、裏側では作業と利用環境に合わせて処理する場所を分けることができます。
その際、何をどこに送るかを決めなければなりません。モデルが端末で動いていても、アプリが入力や結果をサーバーに保存することはあるからです。Rom氏も、プライバシーはモデルだけでなく、アプリをどう実装するかによって決まると説明しました。
自社にはどのモデルが合う?
AIを導入するときは、どのモデルが最も有名かより、自社の仕事に何が必要かから考えましょう。
顧客からの問い合わせを素早く分類する仕事と、複数の文書を読んで新しい戦略を立てる仕事では、必要な能力が異なります。現場でインターネットなしに動かす必要があるか、どれほど速い応答が必要か、データをどこで処理できるかも選択に関わります。
どのモデルがあるか知りたいときは、AIBの用途別AI性能ランキングで、業務自動化や文書作業、コーディングなどに対応するモデルを調べられます。候補が決まったら、AIモデル比較で料金、速度、処理容量、評価結果を並べて確認できます。AIBのAI比較で、同じ質問への回答を直接比べるのも出発点になります。
その後は、実際の業務と利用環境で試すことが大切です。ランキング上位のモデルが必ず自社に合うとは限りません。オンデバイスモデルも、実際の端末で必要な速度と精度を出せるか確認しましょう。
オンデバイスとクラウドの距離が縮まるほど、選択肢は広がります。どの仕事を、どこで処理するかを適切に分けること。それがAIをより速く、役立つ形で使うための基準になります。
あわせて読みたい
AIトレンドに関連する記事をもっと見る →
AI時代のPMの役割とは?何をつくり、どこまで責任を持つのか
会員登録の画面で、多くのユーザーが途中離脱しているとします。プロダクトマネージャー(PM)は問題に気づき、原因を調べ、チームと解決策を考えます。改善した画面をリリースし…
RSI:自ら進化するAIは、どんな未来をつくるのか
AIが自分より優れたAIをつくり、そのAIがさらに優れたAIを生み出す。そんなことが可能になったら、何が起きるのでしょうか。 この循環が続けば、人類が長年解けなかった科…
AIエージェント時代、増え続けるトークンを支える推論インフラ
11月4日、ウェスティン・ソウル・パルナスで開催されたAMD Advancing AI World Tour & AI DevDay Seoulに参加しました。 Dev…
「レバテックフリーランス」にAIBが掲載されました。AI時代にエンジニアの価値はどう変わるのか
このたび、ITエンジニア・フリーランス向けメディア「レバテックフリーランス」の記事「エンジニアの業務効率を飛躍させる!注目のAIツール&AIエージェント特集」に、AIB…