AIエージェント時代、増え続けるトークンを支える推論インフラ
11月4日、ウェスティン・ソウル・パルナスで開催されたAMD Advancing AI World Tour & AI DevDay Seoulに参加しました。
DevDayを通じて語られたのは、AIを実際の業務で広く活用するために、どのような基盤が必要かというテーマでした。AMDのハードウェア・ソフトウェア戦略に加え、Moreh、NAVER Cloud、Clevi、Nota AI、Lablupなど、韓国企業による運用・最適化の事例を聞くことができました。
AIエージェントに任せる仕事が増えるほど、トークン消費は増え、その推論を速く安定して処理するインフラの重要性も高まります。 AIエージェントの時代が急速に近づくなか、モデル選びとあわせて、そのモデルをいくらで、どこで、どのように使うかを考える必要がありそうです。
推論で使うトークンは増え続ける
チャットボットに質問し、回答を受け取るために使うトークンの量は、会話の長さや回数に比例します。一方、複数の段階にわたる長い作業を自律的に進めるAIエージェントは、一つの指示に応えるために、計画、情報収集、ツールの実行、結果の確認を繰り返し、次の行動を判断します。
コーディングエージェントは、その好例です。AIはコードを生成して実行し、エラーを読み、修正し、再びテストします。ユーザーが「この機能を作って」と一行のテキストで依頼しても、成果物ができるまでには数多くのモデル呼び出しと、入力・出力トークンが発生します。AIが処理する情報の単位であるトークンが、業務の過程全体で急増するのです。
つまり、エージェントに任せる業務が増え、複数のエージェントが同時に動けば、推論需要も大きくなります。モデルの効率が向上してトークン単価が下がっても、それ以上の速さで使用量が増えれば、総コストは上がり得ます。AIの活用が広がるほど、推論の費用対効果まで考えて設計する必要があるのは、このためです。
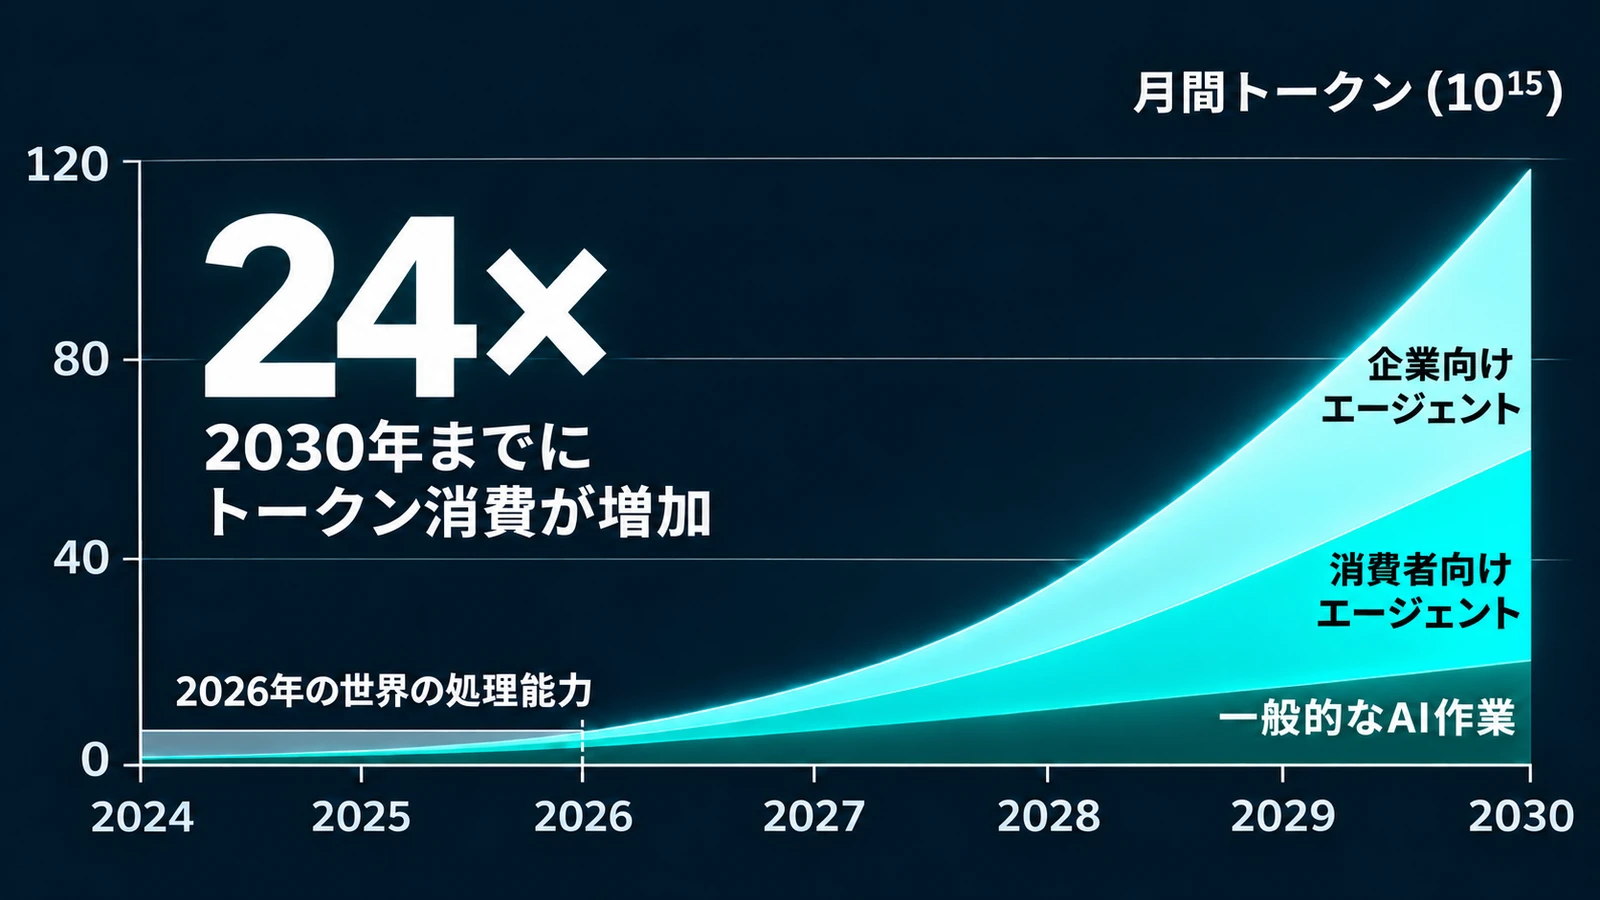 AMDの会場発表で示されたトークン需要予測をもとに再構成したグラフです。
Morehが示したトークンサービスの採算性
Morehは、顧客のニーズがGPUサーバーのレンタルから、既存のエージェントにそのまま接続できるAPIへと移っていると説明しました。顧客が求めているのは、必要なモデルをすぐに使え、適切な速度で応答が返り、トークン費用を予測できるサービスです。
このとき、ハードウェアの違いがなくなるわけではありません。その違いへの対応を、サービス運営者が担うことになります。新しいモデルへの対応、機器に合わせた演算の最適化、複数リクエストの分散処理、メモリやネットワークのボトルネック解消が必要です。同じ機器でも、ソフトウェアや運用方法によって、提供できる処理量とコストは変わります。
特に重要だったのは、一人のユーザーが得られる応答速度と、GPU一台の総処理量を分けて考える説明でした。複数のリクエストをまとめると、機器全体の処理量は増えても、個々のユーザーへの応答は遅くなることがあります。逆に、少数のリクエストにリソースを集中させると、応答は速くなっても、機器全体の処理量は下がることがあります。
推論インフラの競争力は、最高速度だけでは決まりません。顧客が待てる時間内に、必要な品質と処理量をどれだけ安定して提供できるかが、サービスの価格と事業の持続性を左右します。
エージェントの仕事はGPUの外にもある
AMDのEPYCセッションでは、エージェント時代にCPUが担う役割が示されました。モデルがコードを生成することと、そのコードを実際に実行することは、別の作業です。ファイル処理、コンパイル、テスト、データベースへのアクセスといった処理には、CPU、メモリ、ストレージ、ネットワークが必要です。
発表では、エージェントが作成したコードやツールを隔離環境で実行するサンドボックスも、独立したインフラの役割として取り上げられました。エージェントが増えるほど、同時に実行できる環境とリソースを確保し、実行権限や失敗した処理を管理することも重要になります。
この視点に立つと、GPUのトークン生成速度を上げるだけでは十分ではありません。モデルがすぐに回答しても、検索やテストに時間がかかれば、ユーザーの待ち時間は期待したほど短くなりません。モデルの応答速度と、エージェントが業務を完了するまでの時間は、別々に測る必要があります。
NAVER Cloudの事例は、この問題を実際の運用へと広げるものでした。サーバーを増やすには、プロセッサーだけでなく、ラックのスペース、電力、冷却まで考えなければなりません。発表では、CPUの世代が変わるたびに認証を行い、管理ノードと運用プラットフォームで検証してから、サービスへの適用を広げる手順が紹介されました。優れた機器を選ぶことと同じくらい、実際の業務で検証しながら導入する過程が重要だと分かる事例です。
ローカルAIも最適化があってこそ経済的になる
トークン使用量が増えると、一部の作業を社内サーバーやPCで処理するローカルAIも、有力な選択肢になります。継続的なAPI支出を機器や電力・運用の費用に置き換え、機密性の高いデータを社内で扱えるためです。ただし、機器にモデルを載せるだけで、コストや性能の問題が解決するわけではありません。
今回のイベントでは、韓国企業がそれぞれ異なる課題を取り上げました。
- Cleviが取り上げたのは、入力文書の問題です。 HWP(韓国で使われる文書形式)、PDF、スキャン文書からテキストだけを抽出すると、表内の関係や図の位置、ページ構造が失われることがあります。原文の根拠を保ちながら文書をAIが読み取りやすい形に変換する技術は、エージェントが適切に判断するための出発点です。
- Nota AIは、処理をデバイスに合わせて分担する方法を示しました。 紹介された事例では、入力コンテキストの処理と回答生成をNPUとGPUに分け、モデルの重みを共有することで、メモリ効率を高める構成が説明されました。モデルだけでなく、実行方法やハードウェアへの処理の割り当ても含めて最適化するアプローチです。
- Lablupは、同じモデルでも実行環境によって性能が変わることを示しました。 ユニファイドメモリに対応している、低精度モデルを使えるといった仕様だけでは、実際の速度は分かりません。ハードウェアに適した演算経路とメモリの使い方が必要です。
これらの事例に共通するのは、モデルを実際の業務で使うまでに、解決すべき課題が多くあるという点です。文書を正しく読み取り、メモリを効率よく使い、デバイスごとのボトルネックを減らすソフトウェアがあってこそ、ハードウェアの性能をサービスの価値に変えられます。
企業が比較すべきは「業務一件を完了するコスト」
当日の発表を企業のAI導入に当てはめると、判断基準が明確になります。トークン単価や機器の価格に加え、必要な品質で業務一件を終えるための総コストを見るべきです。今年初めに話題になった「トークン・マキシング」というトレンドは、わずか数か月の間に、「トークン・エコノミー」のように、トークンの費用に対する業務効率を最大化する方向へと進化しています。AMD社内でも、社員一人ひとりの月間トークン使用量を従来の無制限から、現在は一定の上限を設ける運用に変えているそうです。
- 品質: 結果は実際の業務基準を満たしているか。どのような抜け漏れや誤りがあり、人による修正にどれだけ時間がかかるか。
- 時間とコスト: 最初の応答だけでなく、完了までにどれだけかかるか。トークン使用量、再試行、機器・運用費を合計するといくらになるか。
- データと運用: どの情報が外部に送られるか。同時作業が増えたり、モデルが変わったりしても、同じ水準を維持できるか。
この結果をもとに、クラウド、ローカル、あるいは両者を組み合わせた構成を選べます。繰り返しが多く検証しやすい作業はローカルで処理し、より高い性能を必要とする作業はクラウドに送る構成も、実際の品質とコストを比較して判断する対象です。目指すべきはローカルで処理する比率を高めること自体ではなく、業務の成功率を維持しながらコストを管理することです。
AIを使い続けるための基盤
今日の会場での発表をまとめると、AIエージェントの普及は、モデルの呼び出しを増やすと同時に、その周辺にある実行・データ・運用のインフラも広げる変化です。今後、エージェントに任せる仕事が増えるほど、トークン消費と推論インフラは、さらに重要な課題になります。
AIBがAIを比較し、顧客の課題に合った活用方法を探す際にも、この視点が必要です。どのモデルが良い回答を出すかに加えて、実際の業務をどれだけ速く、安定して、無理のないコストで完了できるかまで見る必要があります。その基盤を作ることが、AIエージェント時代の重要な競争力になるはずです。
イベントプログラム:AMD ADVANCING AI WORLD TOUR SEOUL 2026 · AMD AI DEVDAY SEOUL 2026
あわせて読みたい
AIトレンドに関連する記事をもっと見る →
「レバテックフリーランス」にAIBが掲載されました。AI時代にエンジニアの価値はどう変わるのか
このたび、ITエンジニア・フリーランス向けメディア「レバテックフリーランス」の記事「エンジニアの業務効率を飛躍させる!注目のAIツール&AIエージェント特集」に、AIB…
判断型AIの競争、JevからOpenAI・Layaへ:企業の活用はどう変わる?
問い合わせを読み、担当部署を選ぶために、毎回長い回答を書くAIが必要でしょうか。前回のJevの記事で考えた問いです。OpenAI、Perplexity、Liquid A…
GPT-6 Astraブーム、AIにはどれほどの計算資源が必要なのか
GPT-6、公開から1週間で新規登録を制限 数日前に公開されたOpenAIの最新AIモデル「GPT-6 Astra」が、大きな注目を集めています。昨年末以降、開発者やA…
AIを『配る国』と『育てる国』 — 日本・韓国・タイ、それぞれの選択
生成AIを国民に広く使ってもらうため、政府が直接支援する国が出てきています。 その方法は国によってかなり違います。 海外のAIをすぐに使えるようにする国。 自国のAIを…